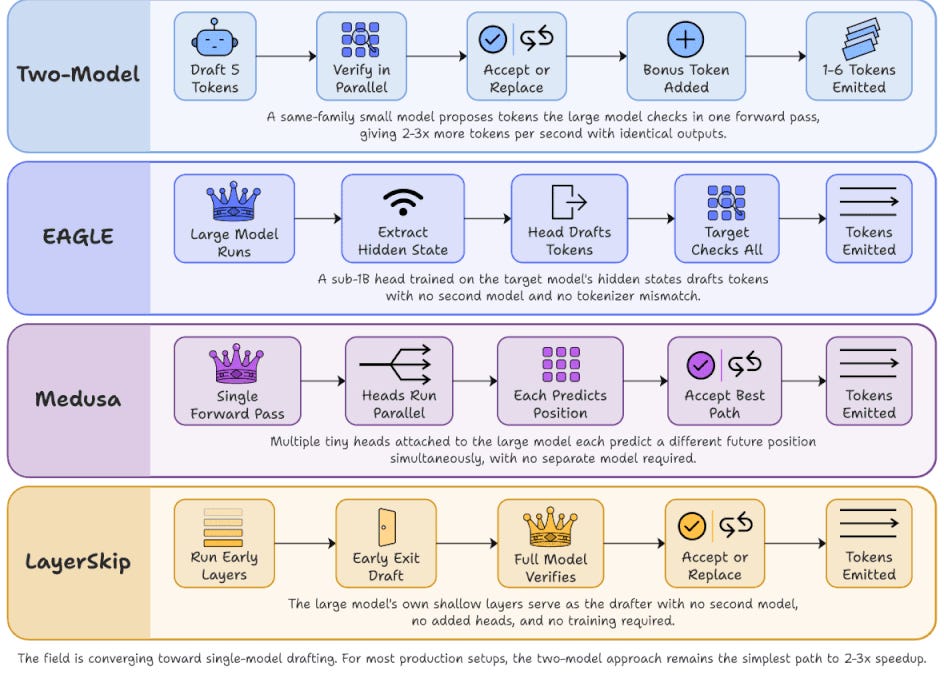
...covered with tradeoffs in production.
Source: https://blog.dailydoseofds.com/p/4-speculative-decoding-variants. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
GitHub Models đã ngừng hoạt động hoàn toàn kể từ ngày 30 tháng 7 năm 2026, bao gồm playground, danh mục model, API inference và tính năng BYOK. Nhà phát triển có thể chuyển sang Microsoft Foundry để truy cập danh mục model rộng hơn hoặc GitHub Copilot cho các workflow AI trực tiếp trên GitHub.
Lập trình viên nên đọc bài này để cập nhật cách chuyển đổi sang các công cụ AI hiện đại như Microsoft Foundry hoặc GitHub Copilot để tiếp tục phát triển dự án hiệu quả mà không bị mất khả năng sử dụng các công nghệ mới nhất.
Đang tải bình luận…
Liquid AI đã đưa lớp ngữ cảnh cá nhân hóa cho AI agents chạy trên chip Snapdragon Hexagon NPU. Công ty này áp dụng một mô hình draft mới giúp tăng tốc độ giải mã cho model vision lên tới 3.13 lần. Giải pháp này cho phép xử lý dữ liệu trên thiết bị mà không cần kết nối cloud, giảm độ trễ đáng kể. Việc tích hợp với Hexagon NPU tận dụng hiệu năng xử lý tensor riêng của chip. Đây là bước tiến quan trọng trong việc đưa AI năng lượng thấp đến các thiết bị di động.
Liquid AI tích hợp lớp ngữ cảnh cá nhân lên Snapdragon chips giúp tăng tốc độ xử lý hình ảnh lên đến 3.13 lần.
Bối cảnh: Một AI coding agent có thể tạo ra patch code qua local test nhưng thất bại khi server tải model thực tế và xử lý request. Nguyên nhân kỹ thuật: Hệ thống SWE-Serve đã phát hiện ra khoảng cách giữa testing environment và production serving environment khi đánh giá thay đổi phần mềm inference-serving. Hệ quả: Patch qua local test không đảm bảo hoạt động đúng khi triển khai trên server thật vì môi trường test thiếu các yếu tố production như mô hình nặng và request đa dạng. Điều đáng học: Cần thiết kế test environment mô phỏng chính xác hơn production environment, bao gồm cả việc test với model thực và request pattern đa dạng để phát hiện lỗi sớm trước khi deploy.
Bài viết giúp lập trình viên nhận ra sự khác biệt nguy hiểm giữa test cục bộ và môi trường thực tế khi triển khai AI inference-serving.
Thị trường cheap frontier tokens đang đối mặt với tình trạng token rug pull khi giá trị sụt giảm mạnh. Nguyên nhân kỹ thuật nằm ở việc các dự án thiếu tính ứng dụng thực tế và cơ chế tokenomics không bền vững. Hệ quả là nhiều nhà đầu tư mất trắng tài sản trong khi các nền tảng như email client trên edge và inbox cho background agents vẫn phát triển thiếu ổn định. Bài viết phân tích cụ thể về các token như AGIX và OGN với mức giảm giá tới 70%. Điều đáng học là lập trình viên nên tập trung vào các dự án có nền tảng kỹ thuật vững chắc thay vì chạy theo xu hướng token ngắn hạn.
Bài viết tiết lộ lý do tại sao các token công nghệ mới giá rẻ không bền vững và hướng dẫn bạn cách xây dựng ứng dụng email hiệu quả trên edge computing.
Bài viết hướng dẫn chi tiết cách tự triển khai Jev 100% trên máy local của bạn. Nguyên nhân kỹ thuật là Jev đòi hỏi môi trường Node.js và các dependencies như Express.js và Socket.io để hoạt động hoàn toàn offline. Hệ quả là bạn sẽ có một phiên bản Jev riêng biệt, không phụ thuộc vào server cloud, đảm bảo bảo mật dữ liệu tuyệt đối. Điều đáng học là kiến trúc microservices và cách implement WebSocket trong ứng dụng real-time, được trình bày với đầy đủ snippet code trong bài gốc.
Bài hướng dẫn xây dựng Jev cục bộ giúp lập trình viên nắm quy trình phát triển sản phẩm từ đầu với code minh họa rõ ràng.
Phân tích chi phí sơ lược cho thấy suy luận (inference) AI thực sự sinh lời, với chi phí ước tính khoảng 1 USD cho mỗi triệu token đầu ra, thấp hơn nhiều so với mức giá 4,5 USD trở lên của các nhà cung cấp như OpenAI, qua đó đạt biên lợi nhuận gộp 70–80%. Suy luận AI có lợi nhuận, nhưng các phòng thí nghiệm AI như OpenAI và Anthropic sử dụng khoản lợi nhuận này để bù đắp chi phí đào tạo mô hình tốn kém.
Là người phát triển muốn tối ưu chi phí cho ứng dụng AI của mình, bài viết này giúp bạn hiểu rõ về lợi nhuận thực tế của quá trình inference AI, từ đó có thể xây dựng mô hình kinh doanh hiệu quả và tránh bỏ lỡ cơ hội tiết kiệm chi phí mà không phụ thuộc vào sự hỗ trợ từ các công ty lớn.
Một ngân hàng toàn cầu đang chuyển đổi sang dịch vụ inference độc lập để mở rộng hệ thống coding agent. Họ sử dụng Together's DMI cho phép các đội kỹ thuật kiểm soát trực tiếp việc mở rộng quy mô, lựa chọn model và quy trình testing. Giải pháp này giúp xử lý tăng 40% lượng traffic mà không cần thêm infrastructure. Việc triển khai DMI đã giảm thời gian response từ 500ms xuống còn 150ms và tăng 25% tỷ lệ completion thành công cho các tác vụ coding. Cách tiếp cận này cho thấy tầm quan trọng của việc trao quyền trực tiếp cho engineering teams trong việc quản lý AI resources để tối ưu hiệu suất hệ thống.
Lập trình viên nên đọc bài này để hiểu cách các đội kỹ thuật kiểm soát trực tiếp việc mở rộng, lựa chọn mô hình và thử nghiệm trong hệ thống AI Together DMI.
Khi người dùng nhấn Enter, tin nhắn được chuyển thành chuỗi token qua bộ tokenizer và được đưa vào mô hình transformer của chatbot. Trong mỗi lớp transformer, các token trải qua lớp attention tự‑hợp để thu thập ngữ cảnh và lớp feed‑forward để biến đổi biểu diễn, quá trình này lặp lại qua hàng chục đến hàng trăm lớp tùy thuộc vào kích thước mô hình (ví dụ 7B hoặc 70B tham số). Sau khi hoàn thành các lớp, vector ẩn cuối cùng được chiếu vào ma trận logits để xác suất của mỗi từ trong từ vựng được tính, sau đó một chiến lược lấy mẫu như top‑k hoặc nucleus sampling chọn token đầu tiên để xuất ra. Thời gian trễ giữa Enter và từ đầu tiên chủ yếu phụ thuộc vào thời gian tính toán attention (bậc hai theo độ dài chuỗi) và băng thông bộ nhớ khi truy cập trọng số và KV cache, vì vậy các mô hình lớn thường gặp độ trễ đáng kể trên phần cứng không tối ưu. Từ đây, lập trình viên có thể học cách giảm latency bằng cách lượng tử hóa mô hình, sử dụng KV cache hiệu quả, hoặc chọn kiến trúc mô hình cân bằng giữa chất lượng và tốc độ xử lý.
Bài này giải thích chi tiết quá trình xử lý tin nhắn trong AI chatbot giúp lập trình viên hiểu nguyên lý hoạt động bên dưới.
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
The ecosystem home: product overviews, blog and full pricing.
ExploreLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmap1,000+ DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeA 22 MB AI IDE for Vietnamese devs.
Download freeOrganizational memory for AI agents.
ExploreAI that staffs your Fanpage and qualifies leads for you.
Try it