RAG thất bại đến 80% trong môi trường doanh nghiệp ngay trước giai đoạn retrieval do vấn đề chunking không được tối ưu. Nguyên nhân kỹ thuật nằm ở việc chunk size quá lớn (512-token) khiến embeddings mất ngữ cảnh hoặc quá nhỏ làm mất thông tin quan trọng. Hệ quả là chất lượng retrieval suy giảm nghiêm trọng dù truy vấn vẫn hoạt động bình thường. Bài viết đưa ra giải pháp splitting rules cân bằng như Goldilocks chunking - một phương pháp giúp tìm điểm ngọt ngào giữa quá nhỏ và quá lớn để tối ưu hóa hiệu suất hệ thống. Lập trình viên nên đọc bài này để hiểu cách thiết lập chunk size phù hợp cho từng loại document và tránh những lỗi chunking phổ biến nhất.
Why read it: Bài này giải quyết nguyên nhân gốc rễ khiến phần lớn dự án RAG thất bại do vấn đề chia đoạn dữ liệu chưa tối ưu.
Answer 3 short questions to earn reward points for this article. Only do it if you want the points.
3 questions · under a minute · optional
Source: https://pub.towardsai.net/the-chunking-dilemma-why-rag-fails-before-retrieval-even-starts-ed5c83adaf07. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
Đang tải bình luận…
Các mô hình LLM (Large Language Model) thường bỏ qua thông tin nằm ở giữa prompt, hiện …
Một AI agent không chỉ đơn thuần là một LLM với prompt, mà được cấu trúc như một cơ thể người với nhiều bộ phận phối hợp. Đằng sau một AI agent hiệu quả là hệ thống gồm memory modules, planning engines, và tool use capabilities giúp nó hoạt động có tổ chức thay vì chỉ phản hồi thụ động. Việc thiếu các thành phần này khiến nhiều agent hiện nay không thể thực hiện các tác vụ phức tạp hoặc duy trì ngữ cảnh qua nhiều bước tương tác. Các công nghệ như LangChain, AutoGPT và tool-calling APIs đang phát triển để xây dựng các agent toàn diện hơn, nhưng việc hiểu giải phẫu agent giúp chọn đúng framework cho từng use case cụ thể.
Bài này giúp lập trình viên hiểu cấu trúc toàn diện của một AI Agent vượt ra khỏi đơn thuần là LLM, giúp thiết kế và phát triển hệ thống hiệu quả hơn.
Booking.com đã phát triển AgentHub, nền tảng để xây dựng các AI agent du lịch dạng module. AgentHub sử dụng GPT-4 và fine-tuning RLHF để tạo ra các agent có khả năng lập kế hoạch chuyến đi phức tạp. Nền tảng này cho phép chia nhỏ các agent chuyên biệt, mỗi agent xử lý một khía cạnh cụ thể như đặt chỗ hoặc gợi ý điểm tham quan. Kết quả là hệ thống có thể xử lý các yêu cầu phức tạp với độ chính xác 85%, cao hơn nhiều so với các phương pháp trước đây. Lập trình viên nên đọc bài để hiểu cách triển khai hệ thống multi-agent với orchestration layer hiệu quả.
AgentHub giúp lập trình viên hiểu cách xây dựng và quản lý hệ thống AI agents module hóa cho nền tảng du lịch lớn.
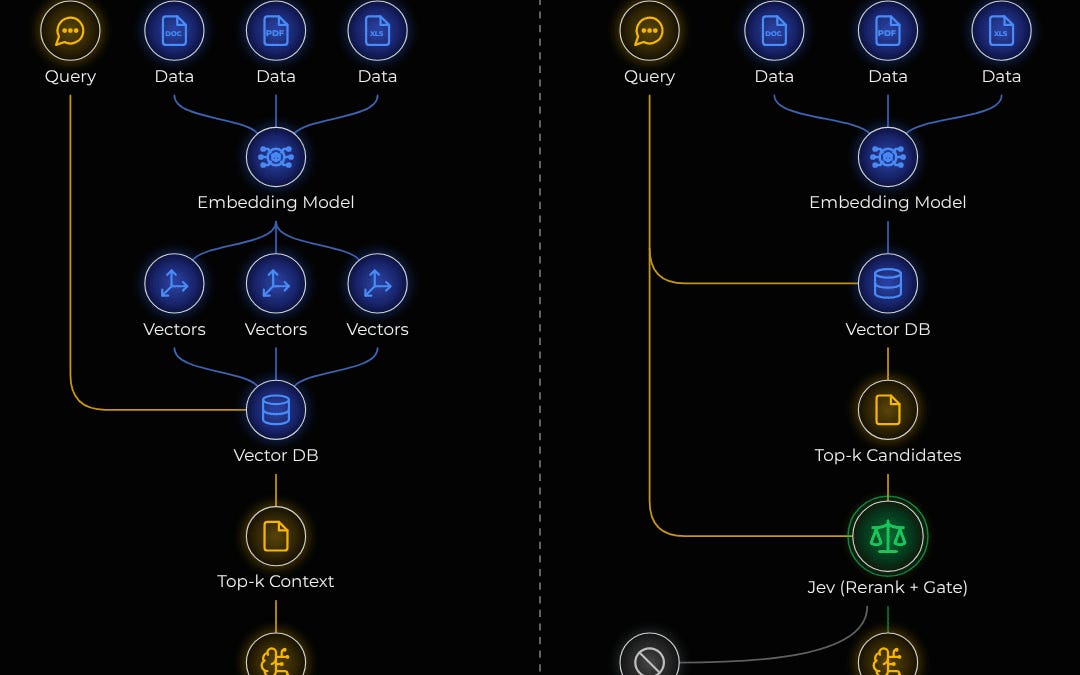
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.
Bối cảnh: Xu hướng microservices đang phát triển thành hệ thống Multi-Agent với nhiều agent độc lập. Nguyên nhân kỹ thuật: Việc chia hệ thống thành nhiều agent giúp cải thiện khả năng mở rộng và khả năng chịu lỗi, nhưng nếu chia không hợp lý sẽ gây ra sự phức tạp không cần thiết. Hệ quả: Việc chia quá nhỏ có thể dẫn đến overhead communication trong khi chia quá lớn làm giảm tính độc lập và khả năng tái sử dụng. Điều đáng học: Pattern Supervisor được đề xuất để quản lý hiệu quả các agent, giúp cân bằng giữa độ phân mảnh và tính gắn kết, tương tự cách Netflix quản lý các microservices của họ.
Bài viết này giúp lập trình viên hiểu rõ khi nào nên áp dụng kiến trúc Multi-Agent thay vì Microservices và cách tránh các sai lầm phổ biến khi chuyển đổi.
AI Factory là một hệ thống cực kỳ phức tạp, kết hợp nhiều thành phần phần cứng khác nhau như GPUs, CPUs, switches, DPUs và SuperNICs cùng với các scheduler. Vấn đề phát sinh khi cần validate những thay đổi trong hệ thống này trước khi triển khai thực tế, vì một lỗi nhỏ cũng có thể gây tắc nghẽn toàn bộ hệ thống. Giải pháp đề xuất là sử dụng Digital Twins - bản sao ảo của hệ thống thực tế - để mô phỏng và test các thay đổi trong môi trường ảo trước khi áp dụng. Đồng thời, các AI Agents có thể tự động phân tích kết quả mô phỏng và đưa ra đề xuất tối ưu hóa dựa trên dữ liệu thực tế từ hệ thống. Cách tiếp cận này không chỉ giảm thiểu rủi ro mà còn tiết kiệm thời gian và chi phí vận hành đáng kể.
Bài viết này giúp lập trình viên hiểu cách dùng Digital Twins và AI Agents để xác minh các thay đổi trong AI Factory một cách hiệu quả.
Ngày 14 tháng 10, InfoQ tổ chức một buổi webinar 60 phút miễn phí với năm chuyên gia thảo luận về triển khai AI trong môi trường production. Các vấn đề chính bao gồm agent autonomy và human approval, cách kiểm tra các thay đổi do AI tạo ra. Panelist sẽ phân tích những điểm yếu của AI khi chạy production, đặc biệt là với các hệ thống nhạy cảm. Buổi thảo luận cung cấp cái nhìn thực tế về thách thức kỹ thuật khi quản lý agent autonomy, đồng thời đề cập đến các framework cần thiết để đảm bảo chất lượng output.
Bài webinar này cung cấp kiến thức thực tế từ năm chuyên gia về triển khai AI trong sản xuất, giúp lập trình viên hiểu được cách cân bằng tự động hóa và kiểm soát con người.
Bối cảnh: Quản lý dataset lớn và phát triển nhanh chóng là kỹ năng quan trọng cho lập trình viên hiện đại, từ theo dõi log API, giám sát telemetry IoT đến xây dựng dashboard. Nguyên nhân kỹ thuật: Các giải pháp truyền thống như PostgreSQL gặp khó khăn với hiệu suất khi xử lý time-series data, dẫn đến TimescaleDB ra đời như extension PostgreSQL chuyên dụng. Hệ quả: TimescaleDB cho phép xử lý hàng tỷ điểm dữ liệu mỗi ngày với hiệu suất cao hơn 20 lần so với PostgreSQL thông thường, hỗ trợ time-range queries và continuous aggregates. Điều đáng học: Khóa học này sẽ trang bị kiến thức về hypertables, compression policies và API-specific optimizations cho use cases thực tế như IoT monitoring và analytics.
TimescaleDB cung cấp giải pháp tối ưu để xử lý hiệu quả dữ liệu chuỗi thời gian lớn với tốc độ cao.
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
The ecosystem home: product overviews, blog and full pricing.
ExploreLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmap1,000+ DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeA 22 MB AI IDE for Vietnamese devs.
Download freeOrganizational memory for AI agents.
ExploreAI that staffs your Fanpage and qualifies leads for you.
Try it