Loading feed…

Daily Dose of Data Science | Avi Chawla | Substack33 Hot1 comments10 min read
6 KV Cache Quantization Approaches
Source: https://blog.dailydoseofds.com/p/6-kv-cache-quantization-approaches. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you

Medium183 Hot10 minAI
10 Best AI GitHub Repositories to Supercharge Your Agent
GitHub là kho lớn nhất chứa công cụ AI miễn phí nhưng phần lớn lập trình viên chưa khai …
Daily Dose of Data Science | Avi Chawla | Substack178 Hot9 minAI
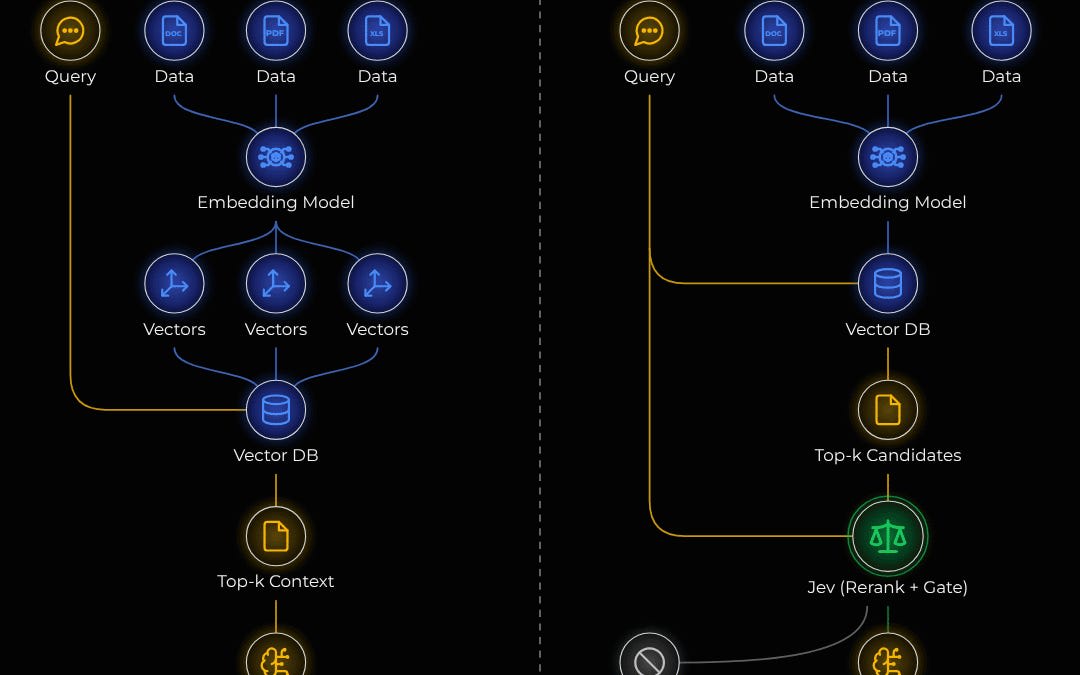
Build a Jev-powered Agentic RAG
Bối cảnh là việc xây dựng một hệ thống RAG (Retrieval-Augmented Generation) có khả năng …

Hacker News2 Hot6 min
Git for US Legislation
Lawyers should be able to read a statute as it stood on any date and see which law wrote each phrase. A history of nine titles of the US Code, built by replaying every amendment, as the example.

ByteByteGo87 Hot4 minAI
EP230: RAG vs Agentic RAG
RAG (Retrieval-Augmented Generation) và Agentic RAG là hai phương pháp xử lý thông tin …
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 minAI
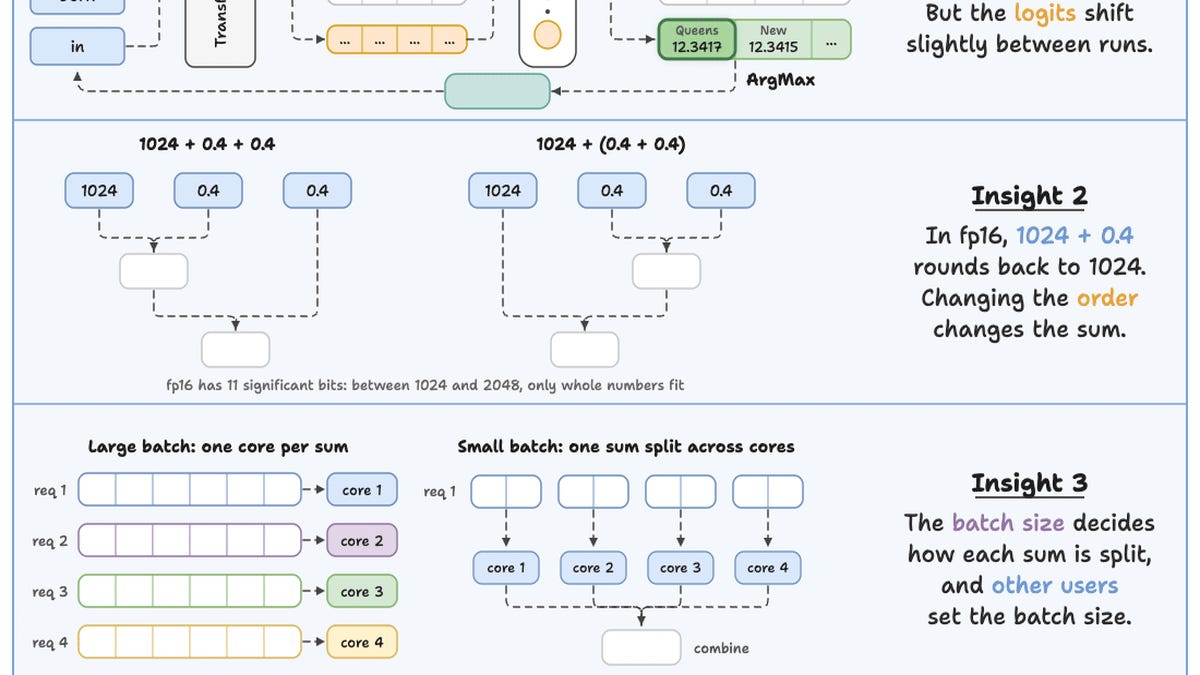
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

ClickHouse1 Hot18 minAI
The Agentic Analytics Benchmark: ranking tables and labeling failures with Jev
Jev đánh giá xếp hạng các bảng warehouse và gắn nhãn lỗi agentic trong dưới một giây, thể hiện hiệu suất vượt trội. Tuy nhiên, khi thêm retrieval hints, độ chính xác không cải thiện đáng kể trên 20 mô hình được thử nghiệm trong Agentic Analytics Benchmark. Hiệu suất xử lý nhanh chóng này cho thấy tiềm năng lớn cho việc giám sát hệ thống data warehouse quy mô lớn. Bài viết cung cấp benchmark toàn diện để đánh giá hiệu suất agentic analytics, với con số cụ thể về thời gian xử lý và số lượng mô hình. Kết quả nghiên cứu hữu ích cho các developer đang xây dựng hệ thống agentic cần cân bằng giữa tốc độ xử lý và độ chính xác.
Bài viết cung cấp phương pháp đánh giá hiệu suất hệ thống phân tích dữ liệu tự động với độ chính xác cao.

Machine Learning Pills67 Hot4 minAI
An Animated Guide to RAG: How AI Finds Answers in Your Documents
Hướng dẫn minh họa giải thích cách Retrieval-Augmented Generation (RAG) giúp AI tìm câu …

ByteByteGo1 Hot10 minAI
How Apple Fits an LLM on Your iPhone
Apple tích hợp LLM lớn trên iPhone bằng cách sử dụng Transformer architecture và kỹ thuật quantization giảm độ chính xác từ 32-bit xuống 4-bit. Công nghệ này cho phép model hoạt động hiệu quả với hạn chế bộ nhớ và điện năng của thiết bị di động. Hệ quả là người dùng có thể trải nghiệm các tính năng AI mạnh mẽ ngay trên thiết bị mà không cần kết nối internet. Bài viết đáng học hỏi ở chỗ Apple đã tối ưu hóa hiệu suất mô hình thông qua kỹ thuật distillation và các bản đặc biệt của on-device neural engine.
Bài này giải thích cách Apple tối ưu hóa mô hình LLM để chạy trơn tru trên iPhone mà không ảnh hưởng đến hiệu năng thiết bị.
Bình luận
Đang tải bình luận…