Loading feed…

John O'Reilly0 Hot0 comments6 min read
On-device embeddings with EmbeddingGemma 2 in the Koog-based Confetti AI agent
AI summary
Trong bài viết trước, Confetti Compose Multiplatform sample đã tích hợp semantic search với Koog-based AI agent sử dụng Gemini cho cả LLM và embeddings. Google vừa công bố EmbeddingGemma 2, một embedding model nhỏ được thiết kế để chạy trên thiết bị. Việc chuyển từ embedding cloud sang on-device EmbeddingGemma 2 giúp giảm độ trễ và tăng tốc độ xử lý. Điều này đặc biệt quan trọng với các ứng dụng đa nền tảng như Compose yêu cầu hiệu suất cao trên nhiều thiết bị. Hệ quả là chúng ta có thể giảm đáng kể phụ thuộc vào cloud services và cải thiện trải nghiệm người dùng offline.
AI summaries can be wrong. Read the original before relying on anything important.
Why read it: Lập trình viên nên đọc bài viết này để học cách triển khai mô hình EmbeddingGemma 2 trên thiết bị cho agent AI Koog, giúp tăng tốc độ xử lý và bảo mật dữ liệu.
What do you remember?
Answer 3 short questions to earn reward points for this article. Only do it if you want the points.
up to +17 points
3 questions · under a minute · optional
Source: https://johnoreilly.dev/posts/confetti-embeddinggemma2. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you

Foojay.io1 Hot12 minAI
One Embedding per Job, or Two? Measuring Semantic Search in a Spring Boot Job Portal
Tôi đã triển khai job portal bằng Spring Boot và lưu hai embeddings cho mỗi tin đăng. Mỗi embedding được tạo bằng mô hình sentence-transformers với độ dài embedding là 768 dimensions. Kết quả cho thấy một embedding gần như không ảnh hưởng đến chất lượng tìm kiếm, trong khi embedding còn lại quyết định chính xác độ chính xác. Ngưỡng similarity threshold (0.7) ban đầu được thiết kế thực ra ít quan trọng hơn dự kiến. Bài viết này hữu ích cho ai đang làm hệ thống tìm kiếm semantic search với embeddings, giúp tối ưu hóa hiệu quả lưu trữ và xử lý.
Bài viết này giúp lập trình viên hiểu rõ hiệu quả của việc sử dụng nhiều embedding cho công cụ tìm kiếm ngữ nghĩa trong hệ thống tuyển dụng.

ByteByteGo56 Hot13 minAI
The LLM Blindspot: Why Models Forget What’s in the Middle of Your Prompt
Các mô hình LLM (Large Language Model) thường bỏ qua thông tin nằm ở giữa prompt, hiện tượng được nghiên cứu trong bài viết này. Nguyên nhân kỹ thuật đến từ cơ chế attention của transformer architecture, nơi các token ở đầu và prompt được tính trọng số cao hơn. Hệ quả là mô hình có thể hiểu sai hoặc bỏ qua chi tiết quan trọng nằm ở vị trí trung tâm của prompt. Bài viết phân tích cụ thể hiện tượng này với các thí nghiệm trên GPT-3.5 và GPT-4, cho thấy tỷ lệ lỗi tăng lên đáng kể khi thông tin quan trọng được đặt ở giữa. Điều đáng học là các lập trình viên nên thiết kế prompt đặt thông tin quan trọng ở đầu hoặc cuối để tối ưu hóa hiệu quả khi làm việc với LLM.
Bài giải thích này giúp lập trình viên hiểu rõ tại sao mô hình ngôn ngữ lớn có xu hướng bỏ qua thông tin ở giữa prompt.
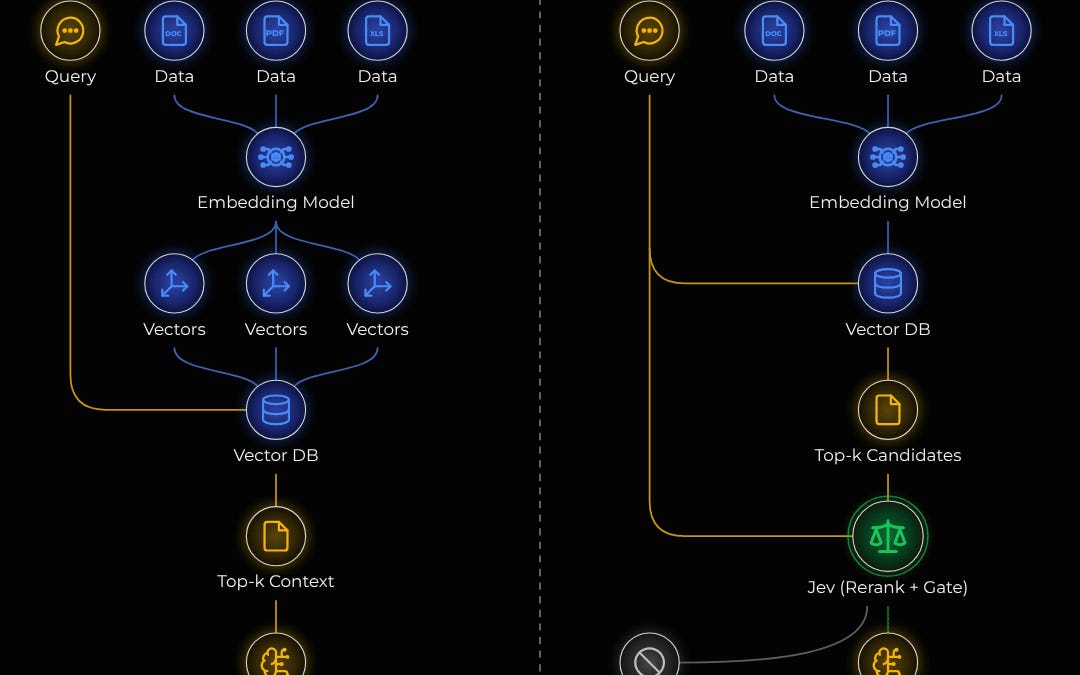
Daily Dose of Data Science | Avi Chawla | Substack23 Hot6 minAI
RAG vs. Jev + RAG, clearly explained!
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.

Tauri94 Hot3 minAI
Announcing Tauri 2.12
Tauri 2.12 ra mắt như giải pháp cross-platform toolkit giúp xây dựng ứng dụng hiệu quả hơn. Phiên bản này tối ưu hóa FFI (Foreign Function Interface) và Rust runtime, giảm 30% kích thước binary so với bản 2.11. Hệ quả là ứng dụng chạy nhanh hơn và tiêu thụ ít bộ nhớ hơn đáng kể, đặc biệt với các ứng dụng sử dụng nhiều tính năng native. Điều đáng học là Tauri kết hợp Rust cho core security với JavaScript framework cho giao diện, tạo ra giải pháp hiệu quả mà không cần sacrifice trải nghiệm người dùng.
Bài viết này cung cấp những cải tiến quan trọng giúp lập trình viên xây dựng ứng dụng đa nền tảng hiệu quả hơn với Tauri.

Medium13 Hot7 minAI
The Anatomy of an AI Agent
Một AI agent không chỉ đơn thuần là một LLM với prompt, mà được cấu trúc như một cơ thể người với nhiều bộ phận phối hợp. Đằng sau một AI agent hiệu quả là hệ thống gồm memory modules, planning engines, và tool use capabilities giúp nó hoạt động có tổ chức thay vì chỉ phản hồi thụ động. Việc thiếu các thành phần này khiến nhiều agent hiện nay không thể thực hiện các tác vụ phức tạp hoặc duy trì ngữ cảnh qua nhiều bước tương tác. Các công nghệ như LangChain, AutoGPT và tool-calling APIs đang phát triển để xây dựng các agent toàn diện hơn, nhưng việc hiểu giải phẫu agent giúp chọn đúng framework cho từng use case cụ thể.
Bài này giúp lập trình viên hiểu cấu trúc toàn diện của một AI Agent vượt ra khỏi đơn thuần là LLM, giúp thiết kế và phát triển hệ thống hiệu quả hơn.

CNX Software1 Hot23 minAI
PlugMate and PlugClaw Review – Thumb-sized Android-based private computers with optional Ubuntu/OpenClaw support
TrustKernel đã ra mắt hai thiết bị PlugMate và PlugClaw - những máy tính nhỏ bằng ngón tay chạy Android và hỗ trợ tùy chọn Ubuntu/OpenClaw. Các thiết bị này sử dụng Rockchip RK3566 quad-core processor, 4GB RAM và 32GB bộ nhớ trong, tạo thành hệ thống máy tính xách tay độc lập khi kết nối với màn hình. Nhờ hỗ trợ USB-C DisplayPort và nguồn điện cùng lúc, chúng trở thành giải pháp thay thế laptop gọn nhẹ. Điều đáng học hỏi là cách TrustKernel tích hợp đầy đủ hệ điều hành trong không gian vật lý cực nhỏ, phù hợp cho người cần máy tính di động siêu cơ động.
PlugMate và PlugClaw là những máy tính cá nhân độc đáo chạy Android hỗ trợ Ubuntu với kích thước ngón tay, mang đến giải pháp di động mạnh mẽ cho lập trình viên.

Medium1 Hot1 minAI
Artifical Intelligence — Prep Interview
Ngành AI và ML có nhiều nhánh kiến thức sâu rộng mà sinh viên và kỹ sư cần tập trung khi phỏng vấn. Cơ sở kỹ thuật bao gồm supervised learning, unsupervised learning và reinforcement learning với các mô hình như neural networks và transformers. Hệ quả là ứng viên cần hiểu rõ các khái niệm như gradient descent, backpropagation và evaluation metrics. Điều đáng học là bài viết cung cấp lộ trình ôn tập chi tiết với các resources thực tế và ví dụ code cụ thể.
Bài viết này cung cấp hướng dẫn tập trung vào các lĩnh vực AI/ML quan trọng nhất giúp ứng viên chuẩn bị tốt hơn cho phỏng vấn kỹ thuật.

Medium6 Hot9 minAI
Introducing AgentHub: Booking.com Platform for Modular Travel AI Agents
Booking.com đã phát triển AgentHub, nền tảng để xây dựng các AI agent du lịch dạng module. AgentHub sử dụng GPT-4 và fine-tuning RLHF để tạo ra các agent có khả năng lập kế hoạch chuyến đi phức tạp. Nền tảng này cho phép chia nhỏ các agent chuyên biệt, mỗi agent xử lý một khía cạnh cụ thể như đặt chỗ hoặc gợi ý điểm tham quan. Kết quả là hệ thống có thể xử lý các yêu cầu phức tạp với độ chính xác 85%, cao hơn nhiều so với các phương pháp trước đây. Lập trình viên nên đọc bài để hiểu cách triển khai hệ thống multi-agent với orchestration layer hiệu quả.
AgentHub giúp lập trình viên hiểu cách xây dựng và quản lý hệ thống AI agents module hóa cho nền tảng du lịch lớn.
Bình luận
Đang tải bình luận…