Loading feed…

Medium0 Hot0 comments5 min read
One Stack, Two Backends: DeepSeek’s Ascend Ports of TileLang, DeepGEMM, and Friends
One Stack, Two Backends: DeepSeek’s Ascend Ports of TileLang, DeepGEMM, and Friends An EdgeRock-style engineering ledger for the open training/inference operator suite — checkable repos and …
Source: https://medium.com/codetodeploy/one-stack-two-backends-deepseeks-ascend-ports-of-tilelang-deepgemm-and-friends-9dabf30e1697. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you
Daily Dose of Data Science | Avi Chawla | Substack17 Hot9 min
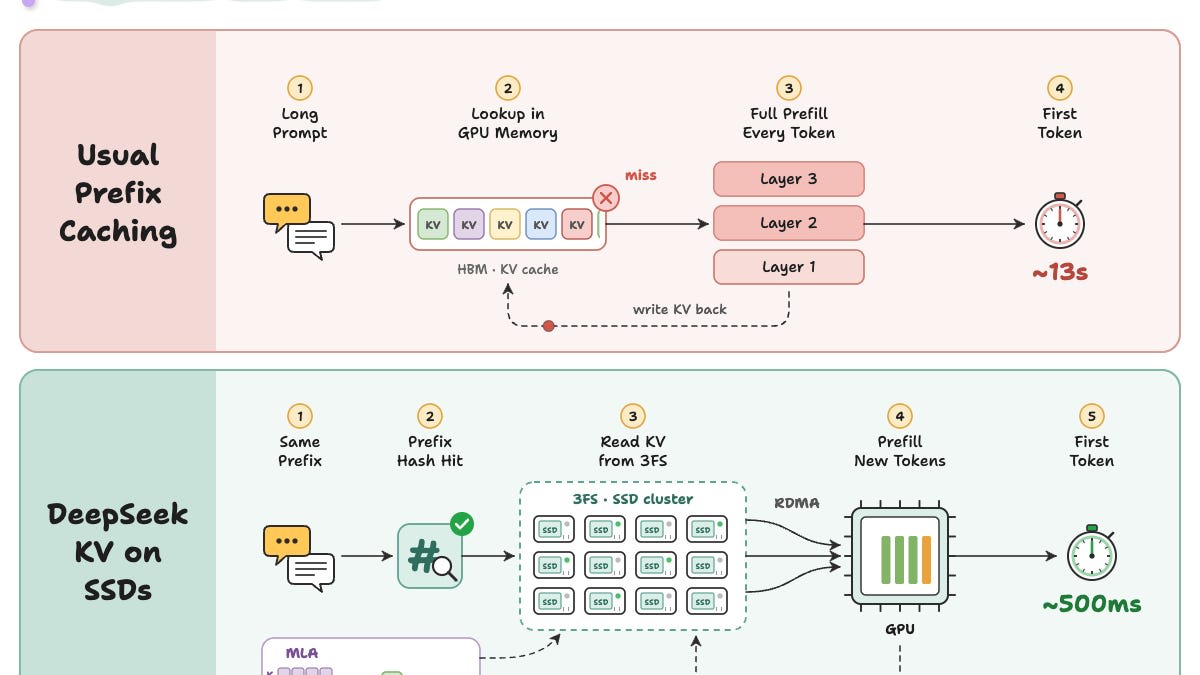
Why DeepSeek stores its KV cache on disk
DeepSeek's engineering behind 26x faster time to first token.

Max Woolf's Blog9 Hot12 minAI
OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?
Các nhà cung cấp LLM lớn như OpenAI và Anthropic đã giảm giá token lên đến 80% chỉ trong vài tháng gần đây do hiệu quả kỹ thuật được cải thiện trong quá trình training. Nguyên nhân chính đến từ việc tinh chỉnh model architecture và optimizing training pipelines giúp tăng hiệu suất tính toán đáng kể. Ví dụ, OpenAI đã giảm giá GPT-4 Turbo từ 0.01 USD/token xuống 0.002 USD/token, trong khi Claude 3 của Anthropic giảm giá từ 0.015 USD/token xuống 0.003 USD/token. Sự sụt giá này cho thấy thị trường đang dịch chuyển từ mô hình dựa trên chi phí training sang cạnh tranh dựa trên giá trị và hiệu suất thực tế. Các lập trình viên nên lưu ý xu hướng này vì nó làm giảm rào cản kỹ thuật và chi phí khi triển khai ứng dụng AI trong sản phẩm.
Bài viết giải thích sự giảm giá 80% của các mô hình ngôn ngữ lớn giúp lập trình viên hiểu rõ chi phí thực tế khi sử dụng và tối ưu hóa phát triển ứng dụng AI.

The Next Web1 Hot2 min
DeepSeek and Moonshot trained new models on GPT-6 Astra, report says
DeepSeek and Moonshot relied heavily on OpenAI’s GPT-6 Astra to train their latest models, The Information reports.

Machine Learning Mastery44 Hot10 minAI
A Gentle Introduction to Model Distillation
Model distillation phương pháp nén khả năng của mô hình teacher lớn vào một student nhỏ hơn, ban đầu qua training trên soft probability distributions và temperature scaling, nay cho LLMs chủ yếu qua synthetic data generation, feature matching hoặc logit matching. Mặc dù distillation đã trở thành tiêu chuẩn (ví dụ Llama 3.1 405B của Meta được cấp phép rõ ràng cho mục đích này), năm 2026 chứng kiến các tranh chấp lớn khi OpenAI cáo buộc DeepSeek, Anthicism cáo buộc Qwen (Alibaba) và báo cáo về việc truy cập tài khoản giả để khai thác Claude, cùng Google can thiệp các tấn công vào Gemini. Chưa có kiểm toán pháp y hay phán xét tòa án nào giải quyết được các cáo buộc này, và xung đột cơ bản giữa việc mô hình bị bộc lộ qua API và được bảo vệ khỏi sao chép vẫn chưa được giải quyết.
Bài này giúp lập trình viên hiểu rõ thực trạng pháp lý và kỹ thuật của mô hình model distillation trong bối tranh tranh bản quyền công nghệ AI.

The Next Web1 Hot2 minAI
DeepSeek reportedly raises $15bn from Tencent and CATL ahead of IPO
DeepSeek đã huy động khoảng 15 tỷ USD với Tencent và CATL là những nhà đầu tư lớn nhất, chuẩn bị cho đợt IPO sắp tới. Số vốn khổng lồ này sẽ giúp DeepSeek cạnh tranh với các AI lớn khác như OpenAI và Anthropic trong cuộc đua phát triển mô hình ngôn ngữ lớn. Việc gọi vốn thành công từ các tập đoàn công nghệ và pin hàng đầu cho thấy tiềm năng to lớn của DeepSeek trong thị trường AI Trung Quốc. Lập trình viên nên lưu ý mô hình của DeepSeek sử dụng kiến trúc Transformer tương tự như GPT nhưng được tối ưu hóa cho thị trường Trung Quốc, đây có thể là hướng đi thú vị để nghiên cứu.
Bài viết này cung cấp thông tin quan trọng về đợt gọi vốn kỷ lục của DeepSeek trước khi lên sàn IPO, cho thấy tiềm năng phát triển và tầm ảnh hưởng của công ty trí tuệ nhân tạo mới nổi.

Flavio Copes1 Hot5 minAI
How to use a coding agent without another subscription
Bối cảnh người dùng muốn sử dụng coding agent mà không cần trả thêm subscription. Nguyên nhân kỹ thuật là kết nối OpenCode với DeepSeek hoặc Ollama, tận dụng mô hình mã nguồn mở hoặc API giá rẻ hơn. Hệ quả là người dùng có thể tiết kiệm chi phí so với các dịch vụ như GitHub Copilot. Điều đáng học là cần hiểu rõ cơ chế billing của API và đánh giá xem hardware local có đủ mạnh để chạy hiệu quả với nhu cầu công việc không.
Bài hướng dẫn này giúp lập trình viên tiết kiệm chi phí bằng cách tận dụng coding agent với các API miễn phí hoặc mô hình cục bộ.

The New Stack1 Hot8 minAI
DeepSeek made its name with cheap AI models. Now it’s undercutting search API rivals, too.
DeepSeek vừa ra mắt API Search và Fetch cho công cụ tìm kiếm của mình với giá chỉ 0.75 USD cho mỗi 1.000 yêu cầu thành công. Đây là mức giá thấp hơn đáng kể so với các đối thủ như Google Search API hay Bing Search API. DeepSeek đang tận dụng lợi thế về chi phí thấp để cạnh tranh trong thị trường API tìm kiếm vốn bị thống trị bởi các công ty công nghệ lớn. Động thái này cho thấy chiến lược của DeepSeek là mở rộng hệ sinh thái API của mình với giá cả cạnh tranh để thu hút nhà phát triển.
DeepSeek phá vỡ thị trường API tìm kiếm với mức giá rẻ chỉ 0.75 USD cho mỗi 1.000 yêu cầu thành công.

sean goedecke17 Hot6 minAI
AI inference is obviously profitable
Phân tích chi phí sơ lược cho thấy suy luận (inference) AI thực sự sinh lời, với chi phí ước tính khoảng 1 USD cho mỗi triệu token đầu ra, thấp hơn nhiều so với mức giá 4,5 USD trở lên của các nhà cung cấp như OpenAI, qua đó đạt biên lợi nhuận gộp 70–80%. Suy luận AI có lợi nhuận, nhưng các phòng thí nghiệm AI như OpenAI và Anthropic sử dụng khoản lợi nhuận này để bù đắp chi phí đào tạo mô hình tốn kém.
Là người phát triển muốn tối ưu chi phí cho ứng dụng AI của mình, bài viết này giúp bạn hiểu rõ về lợi nhuận thực tế của quá trình inference AI, từ đó có thể xây dựng mô hình kinh doanh hiệu quả và tránh bỏ lỡ cơ hội tiết kiệm chi phí mà không phụ thuộc vào sự hỗ trợ từ các công ty lớn.
Comments
Loading comments…