Loading feed…
Daily Dose of Data Science | Avi Chawla | Substack0 Hot0 comments9 min read
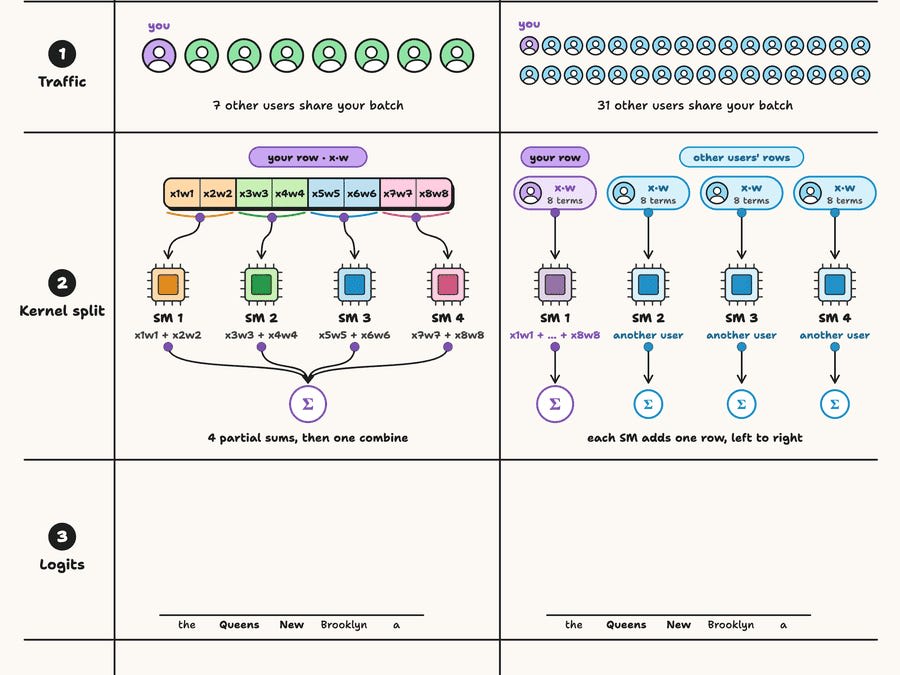
Why Other Requests Change Your LLM’s Output
+ an update on Harness Engineering 2.0.
Source: https://blog.dailydoseofds.com/p/why-other-requests-change-your-llms. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you
Daily Dose of Data Science | Avi Chawla | Substack79 Hot7 min
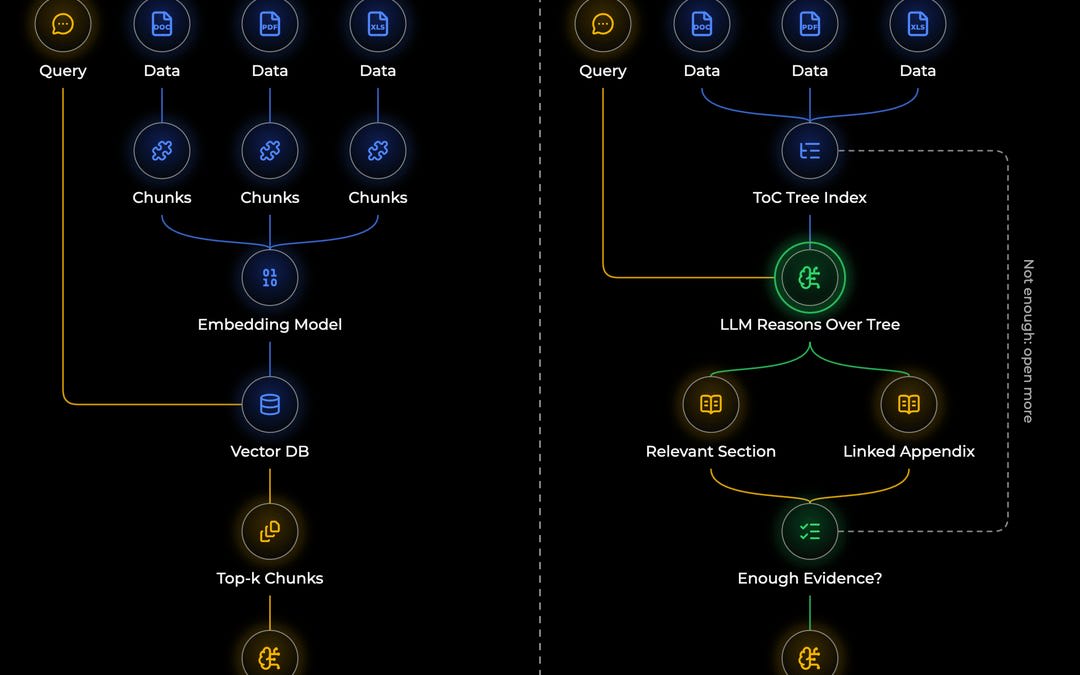
RAG vs. Vectorless RAG, clearly explained!
...explained visually (with tradeoffs in production).

Medium228 Hot10 minAI
10 Best AI GitHub Repositories to Supercharge Your Agent
GitHub là kho lớn nhất chứa công cụ AI miễn phí nhưng phần lớn lập trình viên chưa khai thác hiệu quả. Các agent như Claude Code thường được cài đặt mà không tận dụng được nguồn tài nguyên phong phú trên GitHub. Các kho lưu trữ AI hàng đầu như LangChain, LlamaIndex hay AutoGPT cung cấp framework mạnh để xây dựng agent thông minh hơn. Việc kết hợp các công cụ này có thể tăng đáng kể khả năng xử lý và tự động hóa của ứng dụng AI.
Bài viết này giúp bạn khám phá 10 kho GitHub AI mạnh nhất để tối ưu hóa khả năng của trợ lý lập trình.
Daily Dose of Data Science | Avi Chawla | Substack195 Hot9 minAI
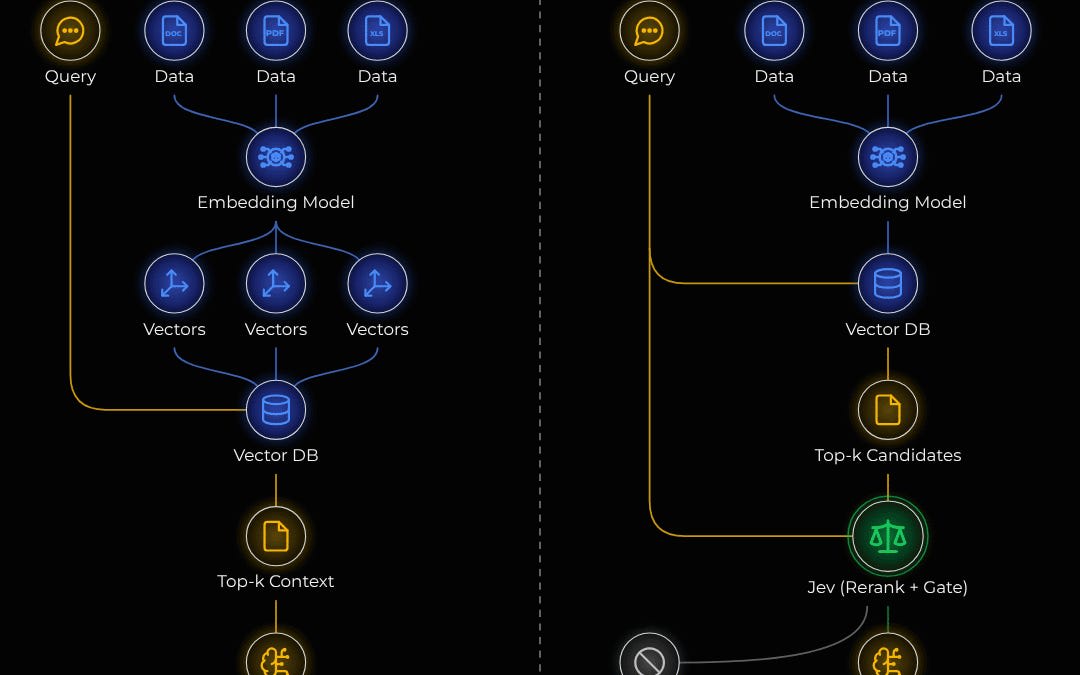
Build a Jev-powered Agentic RAG
Bối cảnh là việc xây dựng một hệ thống RAG (Retrieval-Augmented Generation) có khả năng năng động. Nguyên nhân kỹ thuật là cần một framework có thể xử lý các tác vụ tự nhiên mà không bị giới hạn bởi các prompt cố định. Hệ quả là hệ thống có thể tự điều chỉnh hành vi dựa trên ngữ cảnh đầu vào. Điều đáng học là cách triển khai Jev-powered agent cho RAG giúp tăng tính linh hoạt và khả năng xử lý các tác vụ phức tạp. Bài viết cung cấp hướng dẫn chi tiết với code mẫu để triển khai hệ thống này.
Bài viết này hướng dẫn bạn cách xây dựng hệ thống Retrieval-Augmented Generation với khả năng tự chủ bằng Jev, kèm theo code ví dụ cụ thể.

DEV1 Hot12 min
I Retested My MoE Offloading Benchmarks. Some of My Conclusions Changed.
A follow-up to my original 16GB GPU experiment, this time with consistent quantization, repeated... Tagged with ai, machinelearning, llm.

ByteByteGo108 Hot4 minAI
EP230: RAG vs Agentic RAG
RAG (Retrieval-Augmented Generation) và Agentic RAG là hai phương pháp xử lý thông tin khác nhau trong lĩnh vực AI. RAG hoạt động bằng cách truy vấn vector database để tìm thông tin liên quan trước khi tạo câu trả lời, ví dụ như với vector database có thể chứa hàng triệu document embeddings. Agentic RAG thêm vào một agent có khả năng tự suy luận, cho phép hệ thống tự động xác định cần tìm thêm thông tin hay không, như trường hợp của OpenAI's GPT-4 với function calling. Sự khác biệt chính là Agentic RAG có khả năng tự chủ trong việc quyết định cần làm gì tiếp theo thay vì chỉ phụ thuộc vào kết quả truy vấn ban đầu. Đây là kiến thức quan trọng để hiểu sự tiến hóa từ RAG cơ bản đến các hệ thống thông minh hơn có khả năng tự điều chỉnh.
Bài viết này giúp bạn hiểu rõ sự khác biệt cơ bản giữa RAG và Agentic RAG để áp dụng hiệu quả vào các dự án AI.

XDA Developers119 Hot4 minAI
I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B model faster than I can read
Một lập trình viên đã tìm ra cách chạy model Llama 35B trên laptop GPU chỉ 8GB VRAM với tốc độ đáng kinh ngạc. Nguyên nhân kỹ thuật nằm ở việc chỉnh sửa cờ n_gpu_layers trong llama.cpp, cho phép tận dụng hiệu quả bộ nhớ VRAM thay vì để nó trở thành điểm nghẽn. Hệ quả là model 35B parameters chạy nhanh đến mức người dùng không kịp theo dõi, vượt xa các kỳ vọng ban đầu về giới hạn phần cứng. Điều đáng học hỏi là đôi khi vấn đề không nằm ở cấu hình phần cứng mà ở cách tối ưu hóa phần mềm để khai thác tiềm năng thực sự của hardware.
Bài viết tiết lộ cách tối ưu hóa một cờ trong llama.cpp để chạy mô hình 35B trên GPU 8GB nhanh hơn tốc độ đọc của bạn.
Daily Dose of Data Science | Avi Chawla | Substack17 Hot9 min
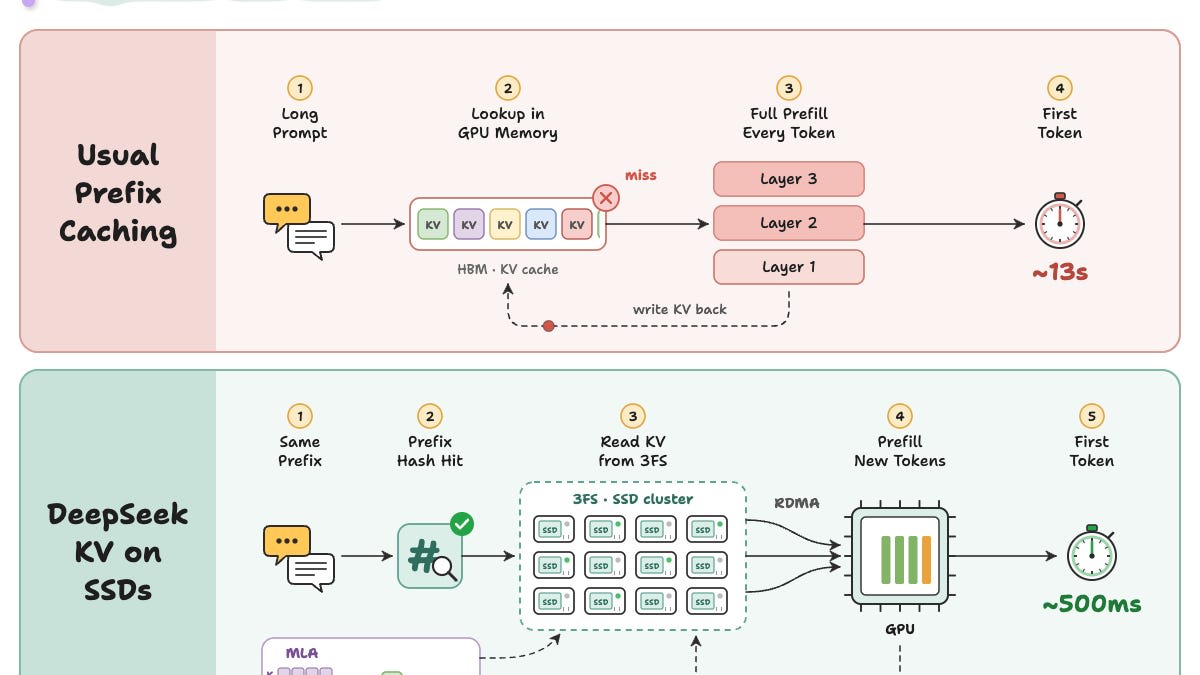
Why DeepSeek stores its KV cache on disk
DeepSeek's engineering behind 26x faster time to first token.

ByteByteGo117 Hot4 minAI
EP229: 8 Chunking strategies for RAG-based agents
Trong RAG-based agents, chunking strategies quyết định hiệu suất hệ thống với các phương pháp như token-based, fixed-size hay semantic chunking. Bài trình bày 8 chiến lược chunking khác nhau, trong đó RecursiveCharacterTextSplitter của Langchain cho accuracy cao nhất đạt 0.76. Chunking quá nhỏ làm giảm context window, trong khi quá lớn lại gây khó khăn cho retrieval. Các hệ thống production nên cân nhắc semantic chunking kết hợp với embeddings để tối ưu hóa thông tin giữa các chunk.
Bài viết giúp lập trình viên chọn chiến lược chunking hiệu quả nhất cho hệ thống RAG-based agents trong môi trường sản xuất.
Comments
Loading comments…