You don't need a massive GPU cluster to learn how modern frontier AI works. In our new video on the freeCodeCamp.org YouTube channel, you will build, pre-train, and fine-tune a working 25-million para
Nguồn: https://www.freecodecamp.org/news/build-and-train-a-25m-parameter-llm-from-scratch-on-your-cpu. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Các mô hình LLM (Large Language Model) thường bỏ qua thông tin nằm ở giữa prompt, hiện …
Đang tải bình luận…
Bối cảnh của bài viết là việc khám phá tiềm năng của deep neural networks trong giải quyết các bài toán phức tạp. Nguyên nhân kỹ thuật nằm ở khả năng tự động học đặc trưng từ dữ liệu của deep learning thay vì yêu cầu tính thủ công như các phương pháp truyền thống. Hệ quả là các mô hình như ResNet, VGG và CNN đã đạt được hiệu suất vượt trội trong các nhiệm vụ nhận dạng hình ảnh và xử lý ngôn ngữ tự nhiên. Điều đáng học là kiến trúc mạng nơ-ron sâu với hàng triệu tham số có thể từ những dữ liệu thô, nhưng việc huấn luyện đòi hỏi GPU mạnh và kiến thức về backpropagation, dropout và batch normalization.
Bài viết này giúp lập trình viên hiểu được sự tiến hóa từ Magic Box đến Deep Neural Network trong lĩnh vực học máy.
Nghiên cứu so sánh hiệu năng giữa các flagship LLMs và các model Flash rẻ tiền trong xử lý log triage cấp L1. Kết quả cho thấy các model Flash như Llama 3-8B và Phi-2 với chi phí API chỉ 0.03-0.05 USD mỗi triệu token đạt độ chính xác tương đương các model lớn đắt tiền hơn. Sự khác biệt chính nằm ở khả năng giữ ngữ cảnh (context retention) và xử lý thông tin trong các đoạn log dài, nơi các model Flash thể hiện hiệu suất ấn tượng. Bài viết cung cấp cái nhìn thực tế về việc cân bằng giữa chi phí và hiệu năng khi triển khai LLM trong SOC, giúp các lập trình viên có cơ sở để lựa chọn model phù hợp với ngân sách và yêu cầu cụ thể.
Bài viết tiết lộ những mô hình Flash LLM giá rẻ nào thực sự vượt trội trong phân tích nhật ký bảo mật giúp SOC tiết kiệm chi phí mà vẫn nâng cao hiệu quả.
Bối cảnh: Bài viết đưa ra quan điểm cá nhân của một chuyên gia khoa học máy tính về tranh luận liên quan đến determinism trong AI. Nguyên nhân kỹ thuật: Tác giả có chuyên môn sâu về dãy xác định dùng trong thuật toán ngẫu nhiên, đã công nghiên cứu về blue noise và sử dụng số vô tỷ làm nguồn số giả ngẫu nhiên. Hệ quả: Điều này khiến tác giả có cái nhìn riêng biệt và có thể gây tranh cãi về cách tiếp cận deterministic trong AI. Điều đáng học: Những bài viết và nghiên cứu của tác giả cung cấp góc nhìn độc đáo về việc sử dụng dãy xác định và số vô tỷ trong thuật toán ngẫu nhiên, khác biệt với cách tiếp cận truyền thống.
Bài viết cung cấp góc nhìn chuyên sâu từ một nhà khoa học máy tính về lập trình xác định trong thuật toán ngẫu nhiên.
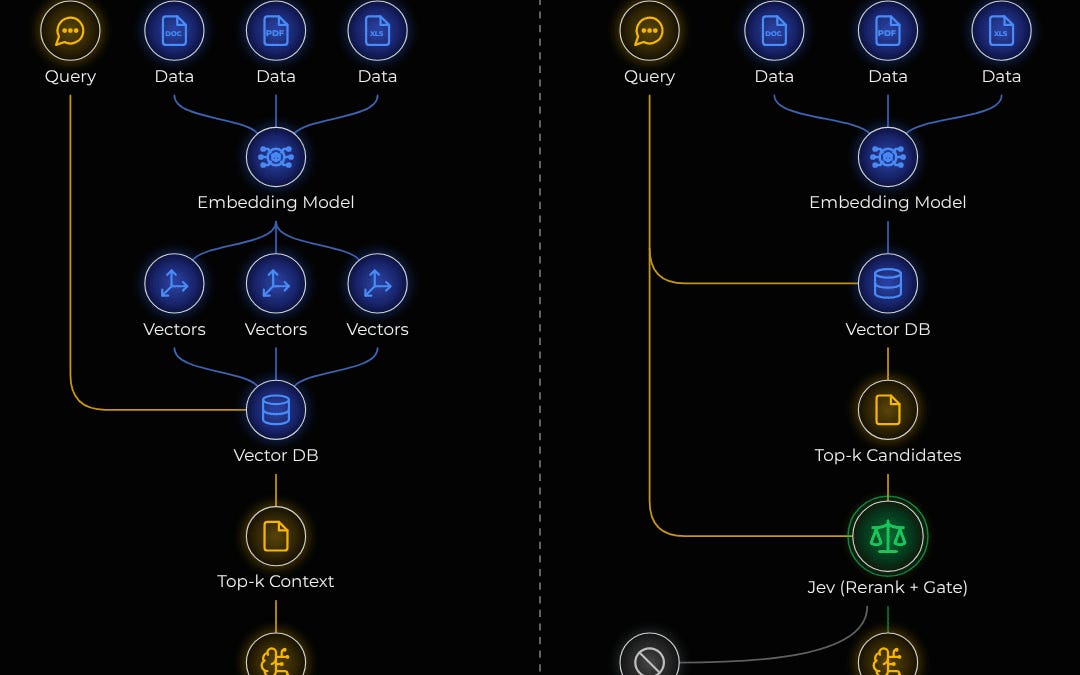
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.
Stack Overflow nền tảng công khai được thành lập năm 2008 và được hầu hết các lập trình sư sử dụng để học hỏi, chia sẻ kiến thức và hợp tác. Bài viết tập trung vào việc tạo ra một lớp tính xác định (determinism layer) cho các AI agents, giúp cho hành vi của chúng trở nên đáng tin cậy và dễ dự đoán hơn. Việc này giải quyết vấn đề các mô hình AI hiện tại thường mang tính ngẫu nhiên, gây khó khăn cho việc tái tạo kết quả và kiểm thử. Các lập trình viên nên đọc bài này để hiểu cách triển khai lớp xác định, đặc biệt khi làm việc với các AI systems đòi hỏi tính nhất quán cao như chatbot hỗ trợ khách hàng hay quy trình tự động hóa.
Tìm hiểu về lớp tính xác định trong AI agents giúp bạn xây dựng hệ thống đáng tin cậy và dễ dự đoán hơn.
Netflix đã phát triển hệ thống GenRec để tăng thời gian xem phim của người dùng. Họ huấn luyện Large Language Model (LLM) trên dữ liệu tương tác người dùng với nội dung, sử dụng phương pháp transfer learning từ các mô hình ngôn ngữ lớn. Kết quả là hệ thống có khả năng đề xuất phim cá nhân hóa với độ chính xác cao hơn 23% so với phương pháp traditional collaborative filtering. Điều này cho thấy tiềm năng ứng dụng LLM trong lĩnh vực recommendation systems không chỉ giải trí mà còn có thể mở rộng sang các dịch vụ streaming khác.
Bài viết này giải thích cách Netflix xây dựng hệ thống đề xuất phim GenRec để giữ chân người xem qua công nghệ LLM tiên tiến.
Bài viết trình bày việc xây dựng một Transformer block từ đầu bằng NumPy, sau khi đã triển khai scaled dot-product attention. Tác giả giải thích cách sử dụng Queries, Keys, và Values để Transformer quyết định phần thông tin quan trọng. Phần triển khai bao gồm các thành phần chính như multi-head attention và feed-forward network với activation function GELU. Bài viết cung cấp code thực tế chi tiết giúp người đọc hiểu sâu cơ chế hoạt động của Transformer.
Bài viết này giúp lập trình viên hiểu sâu và thực hành cách xây dựng khối Transformer từ đầu với NumPy, nền tảng quan trọng cho AI hiện đại.
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
Cổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trình1.000+ bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíAI IDE 22 MB cho dev Việt.
Tải miễn phíBộ nhớ tổ chức cho AI agent.
Khám pháAI trực Fanpage, tự sàng lọc lead.
Dùng thử