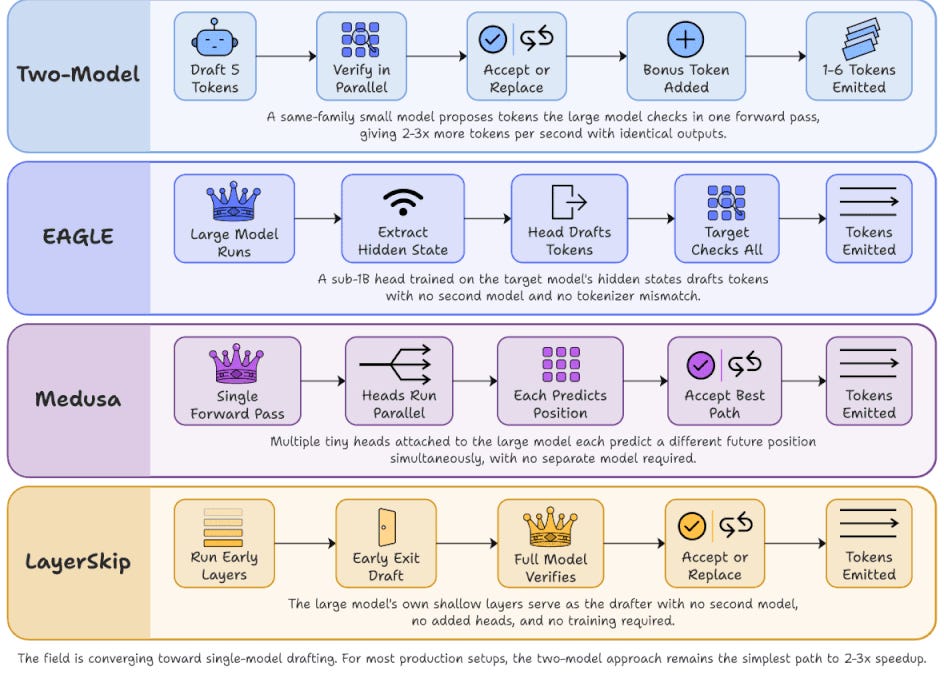
...covered with tradeoffs in production.
Source: https://blog.dailydoseofds.com/p/4-speculative-decoding-variants. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
Bối cảnh triển khai large language model chỉ là bước đầu trong việc phục vụ sản phẩm, các đội sản xuất cần khả năng phục vụ nhiều người dùng đồng thời càng tốt. Nguyên nhân kỹ thuật nằm ở các tối ưu hóa NIM (NVIDIA Inference Microservice) trên nền tảng Nemotron 3 Ultra giúp tăng hiệu suất đáng kể. Hệ quả là hệ thống có thể xử lý 2.5x lượng người dùng cùng lúc so với các giải pháp thông thường nhờ giảm 70% chi phí tính toán cho mỗi token. Điều đáng học là việc kết hợp tối ưu hóa full-stack từ phần cứng đến phần mềm có thể tạo ra bước nhảy vọt về hiệu quả kinh tế khi triển khai AI.
Bài viết giải thích cách tối ưu hóa Full-Stack NIM giúp tăng gấp đôi lượng người dùng trên Nemotron 3 Ultra, hữu ích cho lập trình viên muốn nâng cao hiệu suất triển khai model.
Đang tải bình luận…
GitHub Models đã ngừng hoạt động hoàn toàn kể từ ngày 30 tháng 7 năm 2026, bao gồm playground, danh mục model, API inference và tính năng BYOK. Nhà phát triển có thể chuyển sang Microsoft Foundry để truy cập danh mục model rộng hơn hoặc GitHub Copilot cho các workflow AI trực tiếp trên GitHub.
Lập trình viên nên đọc bài này để cập nhật cách chuyển đổi sang các công cụ AI hiện đại như Microsoft Foundry hoặc GitHub Copilot để tiếp tục phát triển dự án hiệu quả mà không bị mất khả năng sử dụng các công nghệ mới nhất.
Bối cảnh là chi phí inference cho Large Language Models (LLMs) đang trở thành thách thức lớn trong hệ thống multi-agent. Nguyên nhân kỹ thuật là việc sử dụng static model assignment - phân bổ mô hình cố định cho các task - dẫn đến lãng phí tài nguyên. Hệ quả là nghiên cứu đề xuất adaptive model routing giúp giảm 67% chi phí inference bằng cách lựa chọn LLM phù hợp nhất cho từng task cụ thể. Điều đáng học là phương án này không chỉ giảm cost mà vẫn giữ được hiệu suất nhờ tận dụng strengths của các mô hình khác nhau như GPT-4, LLaMA 2 hay Mixtral.
Bài viết này giúp lập trình viên giảm chi phí inference và tăng hiệu năng hệ thống LLM đa tác vụ bằng cách lựa chọn mô hình thông minh.
Bối cảnh là việc xây dựng các workflow lập trình có tính agent (tự chủ) trong thế giới AI mã nguồn mở. Nguyên nhân kỹ thuật là nhu cầu cấu trúc hóa stack AI qua 5 lớp MIGHT (Model, Inference, Gateways/routers, Harness, Tools), với các lựa chọn cụ thể như model Kimi K3 hoặc GLM 5.3 Flash, inference provider Together AI, gateways OpenRouter và Vercel AI Gateway, cùng harness như OpenCode, PI, và Amp. Hệ quả là stack composable giúp mỗi lớp có thể thay đổi độc lập, tối ưu hóa hiệu suất và chi phí. Điều đáng học là các phương pháp quản lý context, bắt đầu session mới, và quy trình plan-implement-review đa model để phát triển hiệu quả hơn.
Bài này giúp lập trình viên hiểu rõ cách xây dựng workflow AI mã nguồn mở với kiến trúc MIGHT linh hoạt, cho phép tối ưu hóa từng thành phần riêng biệt.
Nhiều đội ngũ xây dựng ứng dụng LLM thường thêm một lớp router production-grade để quản lý luồng gọi mô hình và cân bằng tải. Tuy nhiên, router này tạo ra một bước mạng bổ sung, cần serialize/deserialize prompt và phản hồi, đồng thời thực hiện các quy tắc định tuyến phức tạp, khiến latency trung bình tăng lên và tiêu thụ tài nguyên tăng theo. Kết quả là, chi phí tổng thể của việc sử dụng router có thể vượt quá lợi ích mà nó mang lại, đặc biệt khi lưu lượng truy vấn thấp hoặc mô hình đã được tối ưu để gọi trực tiếp. Thí nghiệm trong bài cho thấy trong một số trường hợp, thời gian phản hồi tăng khoảng 30‑40% và chi phí CPU/tài nguyên tăng 20‑25% so với việc không định tuyến. Điều này nhắc nhở các lập trình viên cần đo lường overhead thực tế của lớp router trước khi quyết định triển khai, và cân nhắc các giải pháp đơn giản hơn hoặc gọi trực tiếp khi không cần khả năng mở rộng cao.
Đọc bài này giúp lập trình viên hiểu được những chi phí ẩn và cách tối ưu hóa khi triển khai router cho ứng dụng LLM.
Khi người dùng nhấn Enter, tin nhắn được chuyển thành chuỗi token qua bộ tokenizer và được đưa vào mô hình transformer của chatbot. Trong mỗi lớp transformer, các token trải qua lớp attention tự‑hợp để thu thập ngữ cảnh và lớp feed‑forward để biến đổi biểu diễn, quá trình này lặp lại qua hàng chục đến hàng trăm lớp tùy thuộc vào kích thước mô hình (ví dụ 7B hoặc 70B tham số). Sau khi hoàn thành các lớp, vector ẩn cuối cùng được chiếu vào ma trận logits để xác suất của mỗi từ trong từ vựng được tính, sau đó một chiến lược lấy mẫu như top‑k hoặc nucleus sampling chọn token đầu tiên để xuất ra. Thời gian trễ giữa Enter và từ đầu tiên chủ yếu phụ thuộc vào thời gian tính toán attention (bậc hai theo độ dài chuỗi) và băng thông bộ nhớ khi truy cập trọng số và KV cache, vì vậy các mô hình lớn thường gặp độ trễ đáng kể trên phần cứng không tối ưu. Từ đây, lập trình viên có thể học cách giảm latency bằng cách lượng tử hóa mô hình, sử dụng KV cache hiệu quả, hoặc chọn kiến trúc mô hình cân bằng giữa chất lượng và tốc độ xử lý.
Bài này giải thích chi tiết quá trình xử lý tin nhắn trong AI chatbot giúp lập trình viên hiểu nguyên lý hoạt động bên dưới.
Phân tích chi phí sơ lược cho thấy suy luận (inference) AI thực sự sinh lời, với chi phí ước tính khoảng 1 USD cho mỗi triệu token đầu ra, thấp hơn nhiều so với mức giá 4,5 USD trở lên của các nhà cung cấp như OpenAI, qua đó đạt biên lợi nhuận gộp 70–80%. Suy luận AI có lợi nhuận, nhưng các phòng thí nghiệm AI như OpenAI và Anthropic sử dụng khoản lợi nhuận này để bù đắp chi phí đào tạo mô hình tốn kém.
Là người phát triển muốn tối ưu chi phí cho ứng dụng AI của mình, bài viết này giúp bạn hiểu rõ về lợi nhuận thực tế của quá trình inference AI, từ đó có thể xây dựng mô hình kinh doanh hiệu quả và tránh bỏ lỡ cơ hội tiết kiệm chi phí mà không phụ thuộc vào sự hỗ trợ từ các công ty lớn.
Bối cảnh: Nhiều nhà phát triển AI muốn chạy mô hình trên máy cá nhân để tiết kiệm chi phí và bảo vệ dữ liệu, nhưng họ thường cảm thấy bối rối khi phải chọn giữa hàng chục mô hình khác nhau. Nguyên nhân kỹ thuật: Bài viết chỉ ra rằng sự thiếu hụt các chỉ số chuẩn hoá về mức tiêu thụ VRAM, thời gian suy luận và chất lượng đầu ra khiến việc so sánh trực tiếp trở nên khó khăn. Hệ quả: Do thiếu thông tin cụ thể, các đội thường lãng phí thời gian thử nghiệm nhiều mô hình không phù hợp, dẫn đến hiệu suất kém hoặc thậm chí không thể chạy do bộ nhớ vượt quá khả năng phần cứng. Điều đáng học: tác giả khuyên dùng công cụ đo lường tài nguyên như nvidia-smi hoặc các script benchmark nội bộ, đồng thời ưu tiên mô hình đã được lượng tử hoá (quantization) để vừa giảm kích thước vừa giữ độ chính xác chấp nhận được. Kết luận: Khi biết cách đo lường và áp dụng lượng tử hoá phù hợp, lập trình viên có thể tự tin chọn mô hình local tối ưu cho phần cứng của mình mà không cần phải đoán mò.
Bài viết này sẽ giúp bạn lựa chọn và triển khai mô hình AI cục bộ hiệu quả nhất cho dự án cụ thể của mình.
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
The ecosystem home: product overviews, blog and full pricing.
ExploreLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmap1,000+ DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeA 22 MB AI IDE for Vietnamese devs.
Download freeOrganizational memory for AI agents.
ExploreAI that staffs your Fanpage and qualifies leads for you.
Try it