Loading feed…

TechCentral0 Hot0 comments5 min read
A Finnish supercomputer could help close South Africa’s AI computing gap
Finland has offered to help South African researchers reach its Lumi supercomputer, as the CSIR warns of South Africa's AI computing gap.
Source: https://techcentral.co.za/finnish-supercomputer-lumi-south-africa-ai-computing-gap/287806. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you

XDA Developers116 Hot4 minAI
I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B model faster than I can read
Một lập trình viên đã tìm ra cách chạy model Llama 35B trên laptop GPU chỉ 8GB VRAM với tốc độ đáng kinh ngạc. Nguyên nhân kỹ thuật nằm ở việc chỉnh sửa cờ n_gpu_layers trong llama.cpp, cho phép tận dụng hiệu quả bộ nhớ VRAM thay vì để nó trở thành điểm nghẽn. Hệ quả là model 35B parameters chạy nhanh đến mức người dùng không kịp theo dõi, vượt xa các kỳ vọng ban đầu về giới hạn phần cứng. Điều đáng học hỏi là đôi khi vấn đề không nằm ở cấu hình phần cứng mà ở cách tối ưu hóa phần mềm để khai thác tiềm năng thực sự của hardware.
Bài viết tiết lộ cách tối ưu hóa một cờ trong llama.cpp để chạy mô hình 35B trên GPU 8GB nhanh hơn tốc độ đọc của bạn.

The Next Web1 Hot4 min
Alphabet’s AI commitments pass $1tn, its quarterly filing shows
Alphabet commitments include $924bn of purchases. Its filing says AI agents have taken ‘actions outside of their intended scope’ in testing.
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 minAI
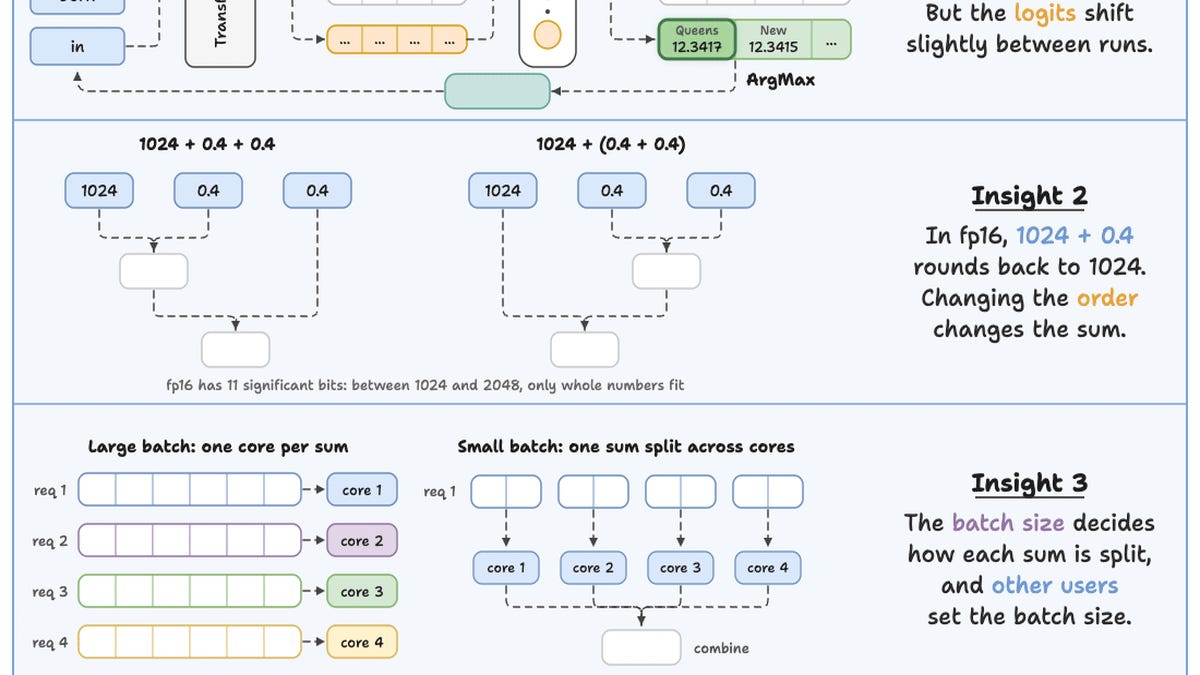
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

XDA Developers1 Hot4 min
I tested Nvidia’s Nemotron 3.5 Bolt, and it changed what I thought my 16GB GPU could do
A 16GB GPU can run agentic AI now, and it's surreal

XDA Developers2 Hot5 min
5 GPUs that are finally too old for modern games in 2026
Every good thing must come to an end

XDA Developers1 Hot6 minAI
Jellyfin supports 7 hardware transcoding methods — here's which one your server can use
Jellyfin hiện hỗ trợ 7 phương pháp transcoding phần cứng khác nhau, giúp giảm tải cho CPU của server. Nguyên nhân kỹ thuật là do Jellyfin tích hợp với các API như NVIDIA NVENC, AMD VCE và Intel Quick Sync để tận dụng khả năng mã hóa/hủy mã hóa của bộ xử lý đồ họa. Hệ quả là server có thể xử lý nhiều luồng media hơn với nhiệt độ và tiêu thụ năng lượng thấp hơn. Điều đáng học là bạn có thể tối ưu hóa hiệu năng Jellyfin bằng cách kiểm tra transcoding method đang được sử dụng và cấu hình phù hợp với phần cứng của mình.
Bài viết này giúp bạn xác định phương pháp chuyển mã hardware tối ưu nhất cho server Jellyfin, giảm tải cho CPU và tăng hiệu suất phát lại.

Google Developers37 Hot1 minAI
Colab is now part of your Google AI plan
Google vừa tích hợp Colab vào Google AI plan, mang lại lợi ích cao cấp cho người đăng ký. Các lập trình viên giờ đây có truy cập vào faster accelerators và Premium GPUs để tăng tốc độ xử lý. Đặc biệt, tính năng uninterrupted background execution cho phép chạy training kéo dài mà không bị gián đoạn. Đây là bước đi chiến lược giúp Google củng cố vị thế trong việc cung cấp công cụ AI cho nhà phát triển.
Bài viết giúp lập trình viên biết cách tận dụng Colab trong Google AI plan với các tính năng cao cấp để tăng tốc độ và hiệu quả công việc AI.

The New Stack1 Hot3 minAI
AI is changing Kubernetes; is your platform ready for 2027?
Vì Kubernetes đang chuẩn bị cho sự bùng nổ workload AI vào năm 2027, The New Stack đã xuất bản ebook tài trợ bởi HPE với 10 checklist thực tế để đánh giá nền tảng Kubernetes của bạn. Các công nghệ như NVIDIA Triton Inference Server và Kubernetes Operators đang trở thành yếu tố then chốt trong việc tích hợp AI vào hệ thống container. Sự kết hợp này tạo ra thách thức lớn về hiệu năng và quản lý tài nguyên, đặc biệt khi xử lý các mô hình AI ngày càng lớn hơn. Bài viết cung cấp những đánh giá cụ thể về khả năng scaling, quản lý GPU và bảo mật multi-tenant - những yếu tố mà các đội ngũ Kubernetes cần chuẩn bị ngay từ bây giờ.
Lập trình viên nên đọc bài này để biết 10 kiểm tra thực tế giúp chuẩn bị nền tảng Kubernetes xử lý tải trọng AI và tác nhân cho năm 2027.
Comments
Loading comments…