Loading feed…

The Quantum Insider0 Hot0 comments3 min read
Alice & Bob Decodes LDPC-Cat Codes on GPUs With NVIDIA NVQLink
AI summary
Alice & Bob đã chứng minh khả năng giải mã LDPC-cat bằng GPU sử dụng kết nối NVIDIA NVQLink và dữ liệu tổng hợp. Công nghệ này tận dụng băng thông cao của NVQLink để đạt tốc độ xử lý vượt trội so với các giải pháp truyền thống. Các bài kiểm tra với dữ liệu tổng hợp cho thấy hiệu năng cải thiện đáng kể trong quá trình giải mã mã LDPC-cat. Đáng chú ý là kết nối NVQLink giảm thiểu độ trễ truyền dữ liệu giữa GPU, tối ưu hóa hiệu suất tổng thể. Đây là bước tiến quan trọng cho các ứng dụng đòi hỏi xử lý dữ liệu lớn với độ tin cậy cao.
AI summaries can be wrong. Read the original before relying on anything important.
Why read it: Bài viết này giúp lập trình viên hiểu cách tối ưu hóa giải mã LDPC-cat trên GPU bằng NVIDIA NVQLink để tăng hiệu suất xử lý dữ liệu.
What do you remember?
Answer 3 short questions to earn reward points for this article. Only do it if you want the points.
up to +17 points
3 questions · under a minute · optional
Source: https://thequantuminsider.com/2026/10/13/alice-bob-decodes-ldpc-cat-codes-on-gpus-with-nvidia-nvqlink. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you

OpenBao31 Hot3 minAI
Announcing OpenBao v2.7!
OpenBao v2.7 ra mắt với tính năng quan trọng là khả năng mở rộng ngang cho PostgreSQL, giúp tăng hiệu quả xử lý. Phiên bản này tích hợp hỗ trợ External HSM và KMS-Backed Keys, tăng cường bảo mật khóa dữ liệu. Đặc biệt, OpenBao v2.7 triển khai Post-Quantum Cryptography để chuẩn bị cho các mối đe dọa từ máy lượng tử trong tương lai. Những cải tiến này giúp OpenBao trở thành giải pháp quản lý bí mật mạnh mẽ hơn, phù hợp với cơ sở hạ tầng phức tạp và nhu cầu bảo mật cao.
OpenBao v2.7 mang đến khả năng mở rộng ngang cơ sở dữ liệu PostgreSQL, hỗ trợ HSM và KMS ngoài, cùng mật mã học lượng tử hậu thập niên cho hệ thống bảo mật mạnh mẽ hơn.

XDA Developers3 Hot6 minAI
4 reasons why I paid for Windows 11 Pro and why I'll never switch to Linux
Ngành công nghiệp phần mềm hỗ trợ chủ yếu cho Windows với nhiều ứng dụng chuyên nghiệp thiết yếu. Các driver phần cứng quan trọng như NVIDIA DLSS và AMD FSR chưa được tối ưu trên Linux. Windows 11 Pro mang lại tính năng Virtualization-Based Security giúp bảo vệ hệ thống hiệu quả hơn. Sự tương thích với phần mềm chuyên dụng như Adobe Creative Cloud và Microsoft 365 là yếu tố quyết định. Nếu bạn làm việc trong môi trường đòi hỏi tính ổn định và hỗ trợ kỹ thuật, Windows 11 Pro vẫn là lựa chọn tối ưu.
Bài viết này giúp lập trình viên hiểu được những lý do thực tế khi lựa chọn Windows 11 Pro thay vì Linux trong môi trường làm việc hiện đại.
XDA Developers1 Hot2 minAI
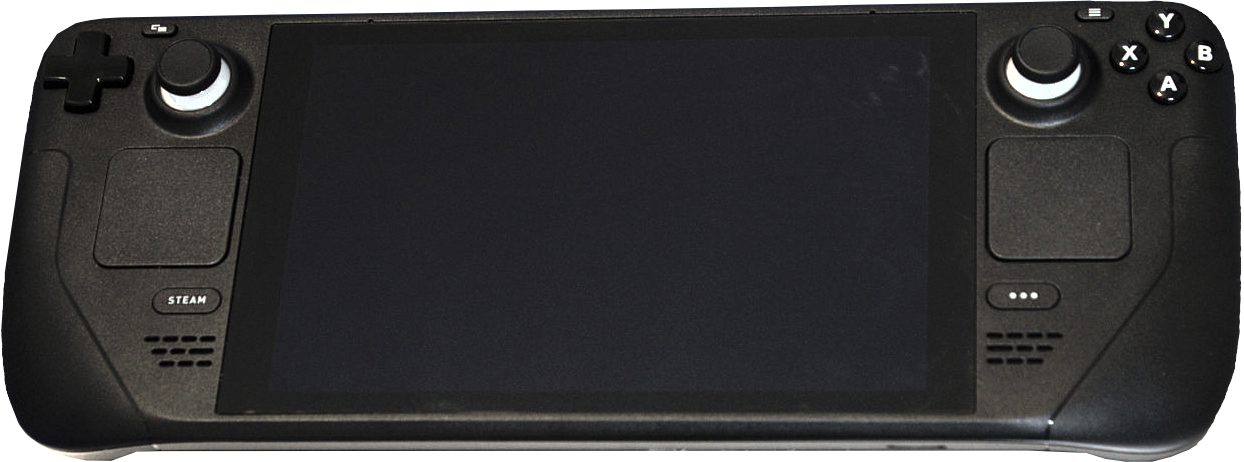
The HelixSR mod adds DLSS 3.7 to the Steam Deck and AMD handhelds, and early reports claim it runs better than FSR4
HelixSR mod mang tính năng DLSS 3.7 đến Steam Deck và thiết bị cầm tay AMD, các báo cáo ban đầu cho thấy hiệu năng tốt hơn so với FSR4. Mod này hoạt động bằng cách tích hợp DLSS Frame Generation vào driver AMD, tạo ra một giải pháp độc đáo vượt qua sự cạnh tranh truyền thống giữa hai gã khổng lồ GPU. Người dùng Steam Deck OLED và các thiết bị AMD ROG Ally đã báo cáo tăng FPS đáng kể khi sử dụng HelixSR. Điều đáng học hỏi là việc cộng đồng tự mình tạo ra các giải pháp vượt qua giới hạn phần cứng, chứng tỏ nhu cầu thực tế cho công nghệ DLSS ngay cả trên nền tảng đối thủ.
Mod HelixSR mang DLSS 3.7 cho thiết bị cầm tay AMD, cung cấp hiệu năng vượt trội so với FSR4 như một bất ngờ cho thị phần phần cứng của chính AMD.

XDA Developers1 Hot5 minAI
MoE models changed what "fits on my GPU" means, and most hardware advice hasn't caught up
Bối cảnh: Các mô hình Mixture of Experts (MoE) đã thay đổi hoàn toàn khái niệm "mô hình nào có thể chạy được trên GPU của tôi" khi một chiếc GPU 10 năm tuổi nay có thể xử lý được các mô hình ngôn ngữ lớn (LLM) lên tới 26 tỷ tham số. Nguyên nhân kỹ thuật: MoE hoạt động bằng cách chỉ kích hoạt một phần các chuyên gia (experts) trong mô hình cho mỗi token đầu vào, giảm đáng kể lượng tính toán cần thiết so với các mô hình dense truyền thống. Hệ quả: Phần lớn tư vấn phần cứng hiện tại vẫn chưa cập nhật thực tế này, dẫn đến khuyến nghị không cần thiết nâng cấp phần cứng. Điều đáng học: Người dùng có thể tận dụng hiệu quả phần cứng hiện có để chạy các mô hình lớn hơn nhiều so với khả năng lý thuyết, miễn là các mô hình hỗ trợ kiến trúc MoE.
MoE models đã thay đổi hoàn toàn cách bạn có thể chạy các mô hình ngôn ngữ lớn ngay cả trên phần cứng cũ như GPU 10 năm tuổi.

Google Developers37 Hot1 minAI
Colab is now part of your Google AI plan
Google vừa tích hợp Colab vào Google AI plan, mang lại lợi ích cao cấp cho người đăng ký. Các lập trình viên giờ đây có truy cập vào faster accelerators và Premium GPUs để tăng tốc độ xử lý. Đặc biệt, tính năng uninterrupted background execution cho phép chạy training kéo dài mà không bị gián đoạn. Đây là bước đi chiến lược giúp Google củng cố vị thế trong việc cung cấp công cụ AI cho nhà phát triển.
Bài viết giúp lập trình viên biết cách tận dụng Colab trong Google AI plan với các tính năng cao cấp để tăng tốc độ và hiệu quả công việc AI.

NVIDIA Developer48 Hot13 minAI
Introducing CUDA Rust: Two Tracks for Writing GPU Kernels
Vào tháng 9 năm 2026, NVIDIA đã công bố định hướng lập trình GPU gốc bằng Rust. Công ty đang phát triển hai hướng tiếp cận riêng cho CUDA Rust, cạnh tranh với các công cụ trưởng thành như CUDA C++ và CUDA Python. Việc này giải quyết nhu cầu về ngôn ngữ an toàn bộ nhớ hơn cho lập trình GPU, vốn hiện chủ yếu dựa vào C++. Lập trình viên nên cân nhắc track phù hợp giữa Rust CUDA Compiler (RCC) và Rust-CUDA crate tùy thuộc vào nhu cầu dự án. Sự phát triển này đánh dấu bước tiến quan trọng khi Rust đang dần trở thành lựa chọn thay thế cho C++ trong các hệ thống hiệu năng cao.
Bài này giúp lập trình viên Rust nắm bắt hướng đi mới của NVIDIA cho lập trình GPU native.

The Next Web0 Hot2 minAI
Super Micro case ‘fixer’ pleads guilty to sending AI servers to China
Ting-Wei Sun đã nhận tội trong một kế hoạch trị giá 2.5 tỷ đô la nhằm chuyển hướng máy chủ AI trang bị Nvidia sang Trung Quốc. Kế hoạch này liên quan đến việc sửa đổi vỏ máy chủ Super Micro để che giấu thông tin nhạy cảm. Hậu quả là công ty Super Micro, đồng sáng lập Wally Liaw đang đối mặt với các cáo buộc nghiêm trọng. Vụ việc cho thấy những lỗ hổng an ninh trong chuỗi cung ứng công nghệ cao. Người làm kỹ thuật nên học cách kiểm tra kỹ lưỡng phần cứng và bảo mật thiết bị trước khi triển khai.
Vụ án này cảnh báo lập trình viên về rủi ro pháp lý khi chuyển giao công nghệ AI sang các thị trường hạn chế.

Hackaday2 Hot3 minAI
AI On Your Gaming PC
Strata cho phép mô hình LLM 125 tỷ tham số chạy trên phần cứng gaming-grade với sự hỗ trợ của Qwen3.8 mixture-of-experts 24,576 chuyên gia chỉ kích hoạt 10 chuyên gia mỗi token. VRAM hoạt động như cache cho chuyên gia được sử dụng thường xuyên, phần lớn mô hình nằm trong RAM, và bảng tra cứu 29 GB nằm trên SSD. Kỹ thuật speculative decoding giúp đạt tốc độ 50-90 token/giây trên RTX 5070 12 GB VRAM. Dù có API tương thích OpenAI và Anthropic, chất lượng trả lời còn hạn chế so với các mô hình lớn hơn, với yêu cầu thực tế khoảng 32 GB RAM, 12 GB VRAM và 80 GB lưu trữ.
Bài viết này giúp bạn hiểu cách triển khai AI quy mô lớn trên máy tính cá nhân mà không cần GPU chuyên dụng từ trung tâm dữ liệu.
Bình luận
Đang tải bình luận…