Loading feed…

Red Hat Developer0 Hot0 comments25 min read
Benchmarking tiered KV cache offloading on H100 GPUs in OpenShift AI 3.5
Optimize long-context AI inference with Red Hat AI 3.5 KV cache offloading, which boosts throughput by 5.8x and cuts TTFT from 60s to 10s on NVIDIA H100 GPUs.
Source: https://developers.redhat.com/articles/2026/11/02/benchmarking-tiered-kv-cache-offloading-h100-gpus-openshift-ai-3-5. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you

CNCF1 Hot11 min
Faster LLM inference startup: What you need to know
Adding an inference replica creates capacity only after the new instance can serve requests. Between starting a process and generating a response…
Daily Dose of Data Science | Avi Chawla | Substack12 Hot9 min
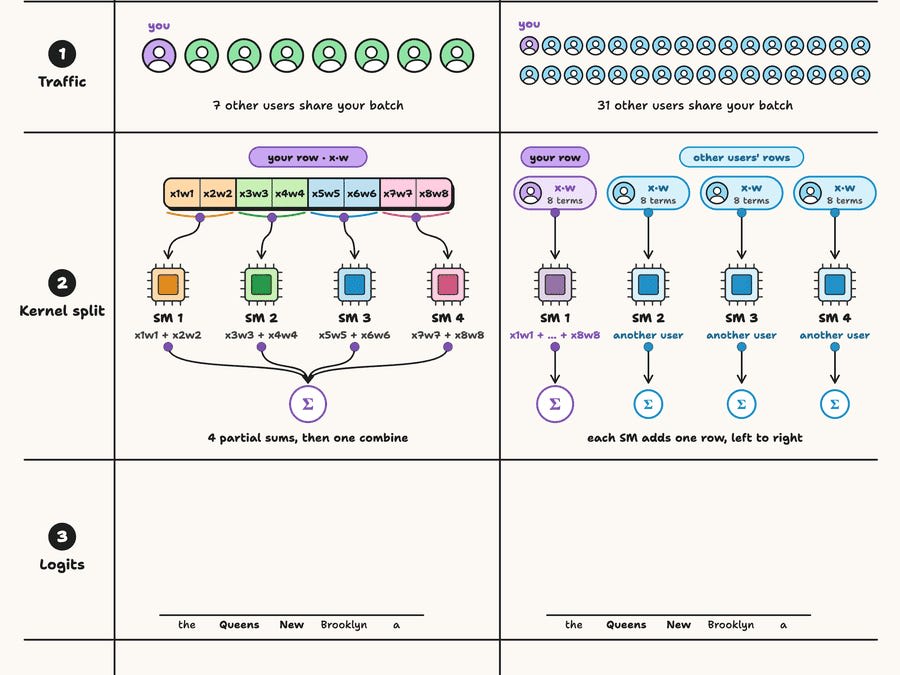
Why Other Requests Change Your LLM’s Output
+ an update on Harness Engineering 2.0.

Daily Dose of Data Science | Avi Chawla | Substack36 Hot10 minAI
6 KV Cache Quantization Approaches
Bối cảnh về KV Cache Quantization trở nên quan trọng khi inference model lớn như GPT-3 cần xử lý hàng tỷ parameters. Nguyên nhân kỹ thuật là do KV Cache chiếm tới 40% bộ nhớ VRAM, tạo ra bottleneck đáng kể cho các inference server. Hệ quả rõ ràng là việc lượng hóa KV Cache giúp giảm 50-70% bộ nhớ sử dụng và tăng tốc inference đến 30%. Điều đáng học là 6 phương pháp lượng hóa KV Cache từ các nghiên cứu gần đây của NVIDIA và Google Research đều có trade-off giữa độ chính xác và hiệu suất, tùy thuộc vào hardware support cụ thể.
Cách tiếp cận KV Cache Quantization được minh họa trực quan giúp lập trình viên hiểu và tối ưu hiệu năng mô hình ngôn ngữ.

ByteByteGo59 Hot17 minAI
How Netflix Taught an LLM to Recommend Movies So That You Keep Watching
Netflix đã phát triển hệ thống GenRec để tăng thời gian xem phim của người dùng. Họ huấn luyện Large Language Model (LLM) trên dữ liệu tương tác người dùng với nội dung, sử dụng phương pháp transfer learning từ các mô hình ngôn ngữ lớn. Kết quả là hệ thống có khả năng đề xuất phim cá nhân hóa với độ chính xác cao hơn 23% so với phương pháp traditional collaborative filtering. Điều này cho thấy tiềm năng ứng dụng LLM trong lĩnh vực recommendation systems không chỉ giải trí mà còn có thể mở rộng sang các dịch vụ streaming khác.
Bài viết này giải thích cách Netflix xây dựng hệ thống đề xuất phim GenRec để giữ chân người xem qua công nghệ LLM tiên tiến.
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 minAI
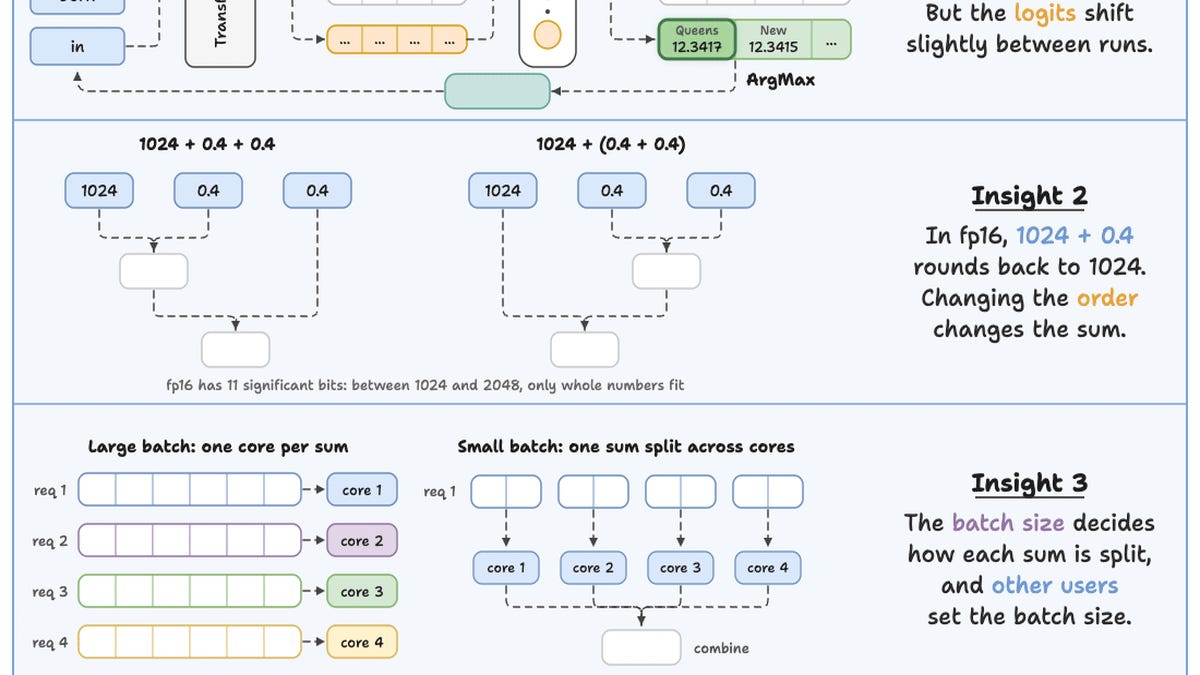
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

Hugging Face21 Hot12 minAI
How Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications
Các ứng dụng thực tế với SLMs (Small Language Models) thường tốn kém do kích thước từ vựng lớn. Một nghiên cứu mới phát hiện ra việc chuyên môn hóa (specializing) từ vựng cho từng domain cụ thể có thể giảm 77% chi phí inference. Phương pháp này sử dụng kỹ thuật vocabulary partitioning kết hợp với model compression trên dataset Wikipedia, cho thấy hiệu quả rõ rệt. Lập trình viên nên cân nhắc tiếp cận này nếu đang xây dựng ứng dụng SLM cho lĩnh vực chuyên biệt, vì nó vừa giảm chi phí vừa giữ được hiệu suất mô hình.
Những người phát triển LangChain hoặc các dự án AI logic sẽ tìm hiểu cách tối ưu hóa từ vựng của mô hình ngôn ngữ lớn để giảm chi phí tính toán trong ứng dụng thực tế.

Hacker News1 Hot9 minAI
Fixing Tool-Call Accuracy in vLLM
Độ chính xác của tool call rất quan trọng khi triển khai mô hình AI open-source, vì lỗi này làm tích lũy ngữ nghĩa vô nghĩa trong hệ thống. Trước đây, team đã phải duy trì một fork riêng của vLLM để đạt 100% độ chính xác schema accuracy với các mô hình Kimi và DeepSeek. May mắn là vLLM 0.31 đã hỗ trợ constrained decoding - một kỹ thuật đảm bảo tuân thủ schema. Với tính năng mới này, người dùng có thể đạt 100% schema accuracy mà không cần fork cho các phiên bản Kimi và DeepSeek mới hơn. Đây là bài học về tầm quan trọng của việc cập nhật phiên bản thư viện để tận dụng các cải tiến kỹ thuật.
Bài viết giải thích cách sử dụng constrained decoding trong vLLM 0.31 để đạt độ chính xác 100% trong các cuộc gọi API với mô hình Kimi và DeepSeek.

Phoronix2 Hot1 minAI
Intel LLM-Scaler-vLLM PV 1.5 Brings Big Improvements
Intel vừa cập nhật LLM-Scaler-vLLM PV phiên bản 1.5, container Docker chạy mô hình ngôn ngữ lớn trên phần cứng Intel Arc Graphics thuộc Project Battlematrix. Phiên bản mới nâng cấp từ vLLM 0.14 lên vLLM 0.26 và PyTorch từ v2.10 lên v2.12, vẫn chưa bằng với bản upstream vLLM 0.31. Cập nhật này hỗ trợ thêm mô hình Qwen và Gemma 4, cùng với FP8 và symmetric INT4 quantization online và FP8 KV cache. Hiệu suất được cải thiện với time-to-first-token nhanh hơn cho Qwen và Gemma 4, MTP decoding tốt hơn, và tăng throughput cho LoRA serving và FP8 KV cache.
Bài viết này cung cấp thông tin quan trọng về phiên bản mới nhất của Intel LLM-Scaler-vLLM PV với cải tiến hiệu năng đáng kể và hỗ trợ thêm các mô hình AI tiên tiến.
Comments
Loading comments…