Loading feed…

databricks0 Hot0 comments3 min read
Building live intelligence: Databricks AI Search supports Streaming Tables, Materialized Views, and Managed tables using Iceberg
AI S
Source: https://www.databricks.com/blog/building-live-intelligence-databricks-ai-search-supports-streaming-tables-materialized-views. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you
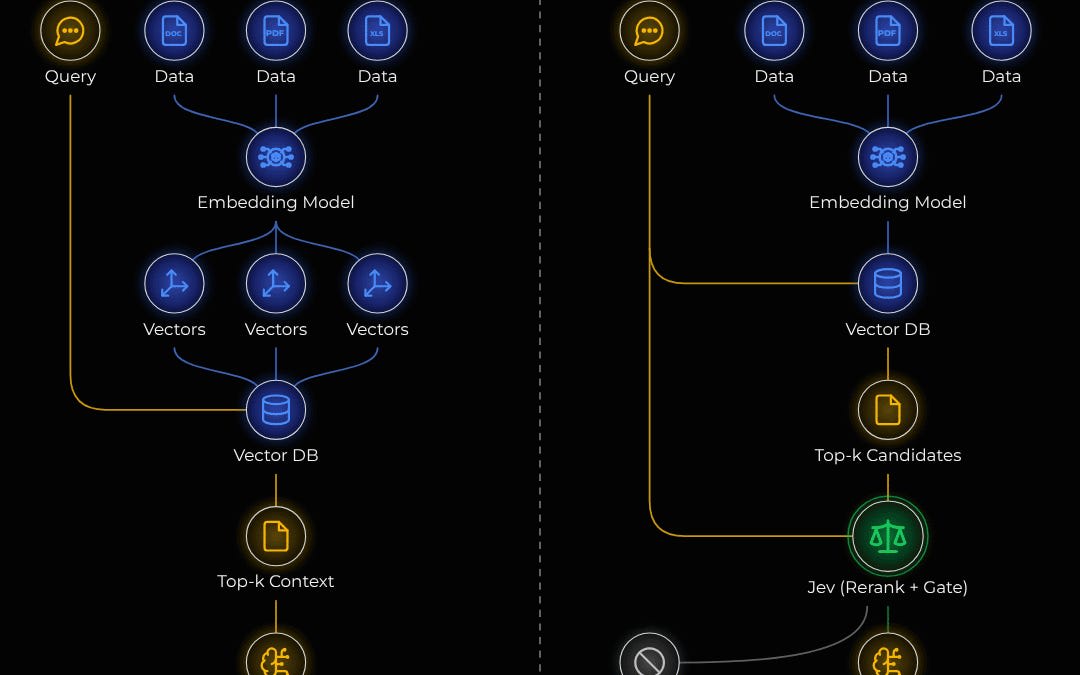
Daily Dose of Data Science | Avi Chawla | Substack185 Hot9 minAI
Build a Jev-powered Agentic RAG
Bối cảnh là việc xây dựng một hệ thống RAG (Retrieval-Augmented Generation) có khả năng năng động. Nguyên nhân kỹ thuật là cần một framework có thể xử lý các tác vụ tự nhiên mà không bị giới hạn bởi các prompt cố định. Hệ quả là hệ thống có thể tự điều chỉnh hành vi dựa trên ngữ cảnh đầu vào. Điều đáng học là cách triển khai Jev-powered agent cho RAG giúp tăng tính linh hoạt và khả năng xử lý các tác vụ phức tạp. Bài viết cung cấp hướng dẫn chi tiết với code mẫu để triển khai hệ thống này.
Bài viết này hướng dẫn bạn cách xây dựng hệ thống Retrieval-Augmented Generation với khả năng tự chủ bằng Jev, kèm theo code ví dụ cụ thể.

BigData Boutique blog17 Hot13 minAI
Vector Database Comparison 2026: Pinecone vs Weaviate vs Qdrant vs OpenSearch
So sánh các vector database Pinecone, Weaviate, Qdrant và OpenSearch cùng các object-storage engine turbopuffer, Amazon S3 Vectors và WarpSearch tập trung vào các yếu tố indexing, hybrid search, quantization, filtering, deployment và pricing. Nguyên nhân kỹ thuật là sự khác biệt về kiến trúc và độ hỗ trợ các tính năng vector search cao cấp, ví dụ Pinecone có hỗ trợ real-time index updates tốt nhất. Hệ quả là sự lựa chọn phù hợp tùy thuộc vào nhu cầu cụ thể như ứng dụng cần low-latency queries có thể chọn Qdrant với hỗ trợ quantization 8-bit. Điều đáng học là khi nào việc chạy thêm một vector store thứ hai không đáng giá về chi phí và quản lý.
Bài cung cấp phân tích chi tiết giúp lập trình viên lựa chọn vector database phù hợp nhất cho dự án của họ.

Machine Learning Pills67 Hot4 minAI
An Animated Guide to RAG: How AI Finds Answers in Your Documents
Hướng dẫn minh họa giải thích cách Retrieval-Augmented Generation (RAG) giúp AI tìm câu trả lời từ tài liệu. Nguyên nhân kỹ thuật là mô hình RAG kết hợp truy vấn thông tin từ vector database để trả lời chính xác hơn. Hệ quả là giảm hiện tượng "ảo tưởng" (hallucination) của AI và cung cấp nguồn tham khảo cho câu trả lời. Điều đáng học là cách kiến trúc RAG cải thiện đáng kể độ chính xác với 40-70% so với các mô hình chỉ sử dụng prompt đơn thuần.
Hướng dẫn RAG bằng hoạt ảnh giúp lập trình viên hiểu rõ cách AI trích xuất thông tin từ tài liệu hiệu quả.

ByteByteGo77 Hot15 minAI
How Uber Built a Genie to Answer Questions Correctly
Uber xây dựng Genie để xử lý câu hỏi của tài xế và hành khách. Hệ thống sử dụng Elasticsearch để tìm kiếm kiến thức từ 1.5 triệu tài liệu và kết nối với 60 service backend khác nhau. Phần xử lý ngôn ngữ tự nhiên (NLP) giúp Genie hiểu ngữ cảnh và trích xuất thông tin chính xác. Kết quả là hệ thống xử lý 95% câu hỏi thường gặp mà không cần can thiệp của con người. Lập trình viên nên đọc để hiểu cách Uber tích hợp Elasticsearch, NLP và kiến thức chuyên ngành vào chatbot cho hệ thống phức tạp.
Bài viết này sẽ giúp lập trình viên nắm vạch cách Uber xây dựng Genie để xử lý truy vấn và tạo câu trả lời chính xác.
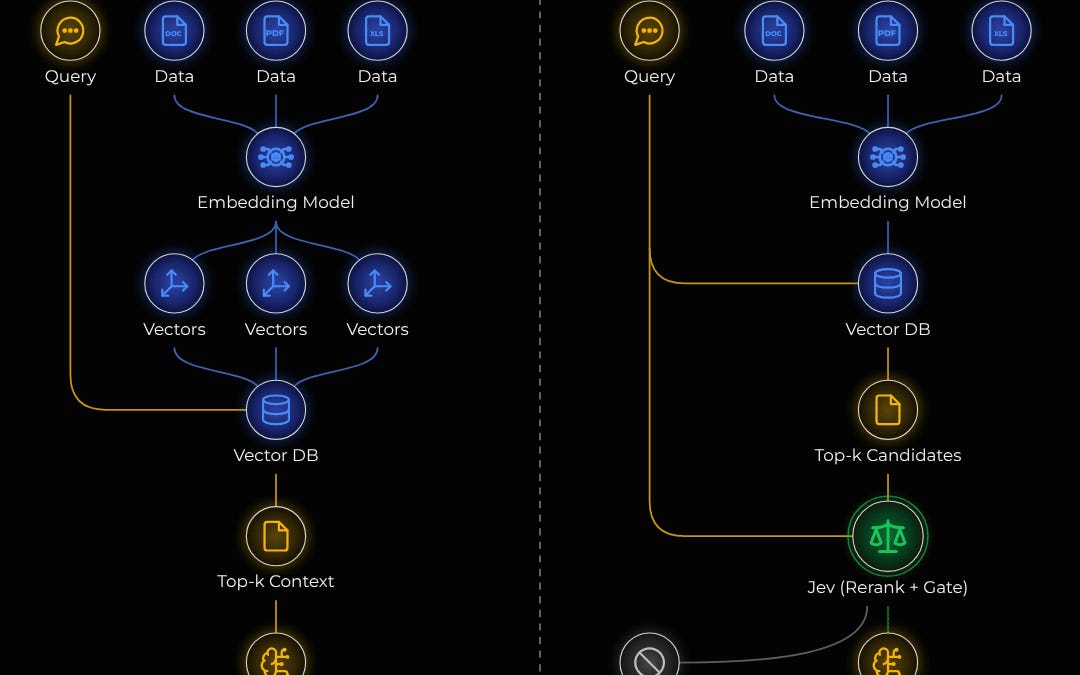
Daily Dose of Data Science | Avi Chawla | Substack108 Hot6 minAI
RAG vs. Jev + RAG, clearly explained!
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.

Medium1 Hot7 min
I Took a Memory Leak Arena to Google Ananta. It Got Picked
adk-leak-arena and adk-memshield: a red-team harness and an RLS memory service for Google ADK, shown at FORK. BUILD. MERGE. at Google Ananta.


databricks2 Hot8 minAI
The media industry is becoming a prediction economy
Ngành công nghiệp truyền thông đang chuyển đổi thành một nền kinh tế dự đoán, với Netflix đầu tư 1 tỷ USD vào việc phân tích dữ liệu người dùng để tối ưu hóa nội dung. Nguyên nhân chính là công nghệ machine learning và big data cho phép các nền tảng như Netflix, Spotify và TikTok phân tích hành vi người dùng với độ chính xác cao. Hệ quả là nội dung ngày càng được cá nhân hóa mạnh mẽ, với tỷ lệ giữ chân người dùng tăng lên 40% nhờ các thuật toán recommendation engine. Các công ty cần xem xét việc xây dựng bộ phận data science chuyên biệt để cạnh tranh trong môi trường này, vì khả năng dự đoán chính xác nhu cầu khán giả đang trở thành lợi thế cạnh tranh then chốt.
Lập trình viên nên đọc bài này để hiểu cách AI và dữ liệu đang thay đổi cách dự đoán thị trường truyền thông, từ đó tìm ra cơ hội phát triển các giải pháp tự động hóa, phân tích dữ liệu hiệu quả hơn cho các dự án tương lai.
Comments
Loading comments…