Loading feed…

Facebook Engineering
0 Hot0 comments12 min read
Meta Andromeda: Powering the Next Generation of Ads Retrieval Through Model-System Co-Design
Meta's next-generation Andromeda ads retrieval system now scores every eligible ad and surfaces top candidates at over one billion ads per second, a 100x throughput jump over the 2024 system. A new mixture-of-experts retrieval architecture reaches near ranking-level model quality at about 300x fewer inference FLOPs. A fused GPU kernel and co-located index matching, scoring and top-K selection on a single GPU cut network traffic by roughly 100x. Joint work with NVIDIA pushed the gating kernel to over 10 billion ads per second per GH200 GPU, with INT8 quantization adding up to a further 2x. Since 2025, the system has driven a 2.4% increase in conversions on Facebook.
Source: https://engineering.fb.com/2026/10/28/ml-applications/meta-andromeda-next-gen-ads-retrieval-gpu-co-design. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you

The Next Web1 Hot4 min
Canada joins Nvidia in backing Cohere’s record C$7bn Series E
The Toronto AI company targets C$7bn at a C$35.7bn valuation, with Canada, Nvidia and Schwarz Group among its backers.

XDA Developers116 Hot4 minAI
I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B model faster than I can read
Một lập trình viên đã tìm ra cách chạy model Llama 35B trên laptop GPU chỉ 8GB VRAM với tốc độ đáng kinh ngạc. Nguyên nhân kỹ thuật nằm ở việc chỉnh sửa cờ n_gpu_layers trong llama.cpp, cho phép tận dụng hiệu quả bộ nhớ VRAM thay vì để nó trở thành điểm nghẽn. Hệ quả là model 35B parameters chạy nhanh đến mức người dùng không kịp theo dõi, vượt xa các kỳ vọng ban đầu về giới hạn phần cứng. Điều đáng học hỏi là đôi khi vấn đề không nằm ở cấu hình phần cứng mà ở cách tối ưu hóa phần mềm để khai thác tiềm năng thực sự của hardware.
Bài viết tiết lộ cách tối ưu hóa một cờ trong llama.cpp để chạy mô hình 35B trên GPU 8GB nhanh hơn tốc độ đọc của bạn.

The Next Web1 Hot3 min
Mistral releases open weights for its 1 trillion-parameter Large 4 model
Mistral has released the weights of Mistral Large 4 on Hugging Face, after three weeks of extra training lifted its coding and cyber defence scores.
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 minAI
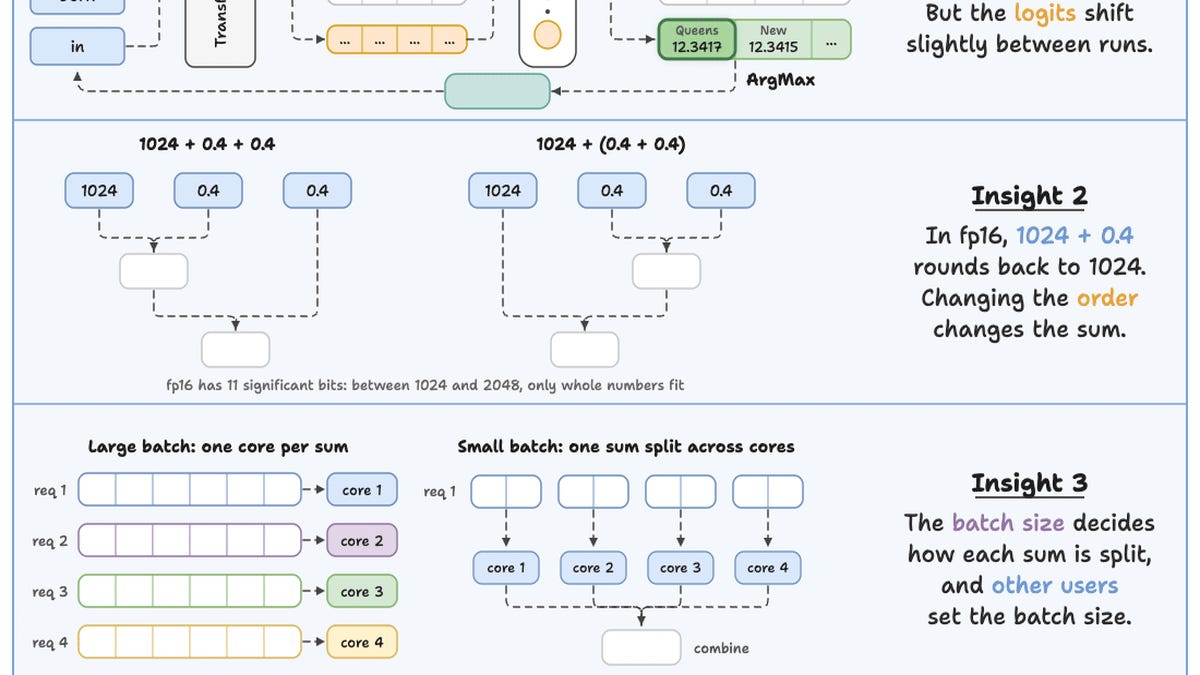
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

freeCodeCamp198 Hot2 minAI
Build and Train a 25M Parameter LLM From Scratch on Your CPU
Bối cảnh: Bạn không cần cụm GPU khổng lồ để học cách AI hiện đại hoạt động. Nội dung video hướng dẫn xây dựng, pre-train và fine-tune một mô hình LLM 25 triệu parameter chỉ trên CPU. Nguyên nhân kỹ thuật: Video trình bày quy trình chi tiết từ đầu đến cuối với các công cụ như PyTorch, tạo tập dataset từ văn bản thuần túy. Hệ quả: Người xem sẽ có được kiến thức thực tế về cách LLM hoạt động mà không cần tài nguyên đắt đỏ. Điều đáng học: Dù quy mô nhỏ hơn các frontier model như GPT-4 hay Llama 2, quy trình này giúp hiểu nền tảng của deep learning trong NLP.
Bài hướng dẫn này giúp bạn xây dựng và huấn luyện một mô hình ngôn ngữ quy mô 25 triệu tham số ngay trên CPU mà không cần cluster GPU đắt đỏ.

XDA Developers1 Hot4 min
I tested Nvidia’s Nemotron 3.5 Bolt, and it changed what I thought my 16GB GPU could do
A 16GB GPU can run agentic AI now, and it's surreal

XDA Developers2 Hot5 min
5 GPUs that are finally too old for modern games in 2026
Every good thing must come to an end

ByteByteGo59 Hot17 minAI
How Netflix Taught an LLM to Recommend Movies So That You Keep Watching
Netflix đã phát triển hệ thống GenRec để tăng thời gian xem phim của người dùng. Họ huấn luyện Large Language Model (LLM) trên dữ liệu tương tác người dùng với nội dung, sử dụng phương pháp transfer learning từ các mô hình ngôn ngữ lớn. Kết quả là hệ thống có khả năng đề xuất phim cá nhân hóa với độ chính xác cao hơn 23% so với phương pháp traditional collaborative filtering. Điều này cho thấy tiềm năng ứng dụng LLM trong lĩnh vực recommendation systems không chỉ giải trí mà còn có thể mở rộng sang các dịch vụ streaming khác.
Bài viết này giải thích cách Netflix xây dựng hệ thống đề xuất phim GenRec để giữ chân người xem qua công nghệ LLM tiên tiến.
Comments
Loading comments…