Loading feed…

PyTorch0 Hot0 comments4 min read
Nebius Joins the PyTorch Foundation as a Platinum Member
Nebius has joined the PyTorch Foundation as a Platinum member. The AI cloud company has long supported vLLM with compute for development, testing and benchmarking, including multi-node work on models like DeepSeek R1. As a Platinum member, Nebius plans to contribute to PyTorch and vLLM performance on the latest hardware and gets one seat on the Governing Board. Ryan Hanrui Wang, Nebius's SVP of Applied AI, joins the board and will represent Nebius on the Technical Advisory Council.
Source: https://pytorch.org/blog/nebius-joins-the-pytorch-foundation-as-a-platinum-member. 8 Sync News only summarizes and links out; content copyright belongs to the authors and original sources.
8 Sync ecosystem
One account, the whole ecosystem
Read the news here, practice coding, follow structured courses and train for IELTS on our sibling products — all connected through one 8 Sync account.
8syncdev.com
8syncdev.comThe ecosystem home: product overviews, blog and full pricing.
ExploreCourses
course.8syncdev.comLearn along a clear roadmap: videos, auto-graded quizzes, certificates and mentors who ship for a living.
View the roadmapCoding practice
coding.8syncdev.com1,000 DSA problems in Vietnamese, auto-graded across 7 languages — many FREE, right in your browser.
Practice for freeIELTS
ielts.8syncdev.comAI grading for all four IELTS skills with detailed rubric feedback.
Try it freeZUS — AI IDE
zus.8syncdev.comA 22 MB AI IDE for Vietnamese devs.
Download freemind0
mind0.8syncdev.comOrganizational memory for AI agents.
ExploreAcoLeads
home-acoleads.8syncdev.comAI that staffs your Fanpage and qualifies leads for you.
Try itRecommended for you

CNCF1 Hot11 min
Faster LLM inference startup: What you need to know
Adding an inference replica creates capacity only after the new instance can serve requests. Between starting a process and generating a response…

Sebastian Raschka77 Hot12 minAI
Build Your Own Reasoning Model: A Full Video Course
Khóa học video kéo dài 11 giờ tập trung vào việc xây dựng model reasoning với Python và PyTorch. Nội dung bao gồm các kỹ thuật advanced như evaluation, inference-time scaling, reinforcement learning và distillation. Qua khóa học, bạn sẽ học cách tối ưu hiệu suất của các reasoning model hiện đại. Các bài thực hành code chi tiết giúp hiểu sâu về quy trình training và fine-tuning. Giá trị lớn nhất nằm ở việc kết hợp lý thuyết với thực hành để xây dựng được hệ thống AI có khả năng reasoning mạnh mẽ.
Lập trình viên muốn nâng cấp kiến thức về mô hình học máy từ cơ bản đến ứng dụng thực tế—đặc biệt là trong scaling mô hình, reinforcement learning, và distillation—để áp dụng ngay trong dự án AI của mình với Python và PyTorch.
Daily Dose of Data Science | Avi Chawla | Substack12 Hot9 min
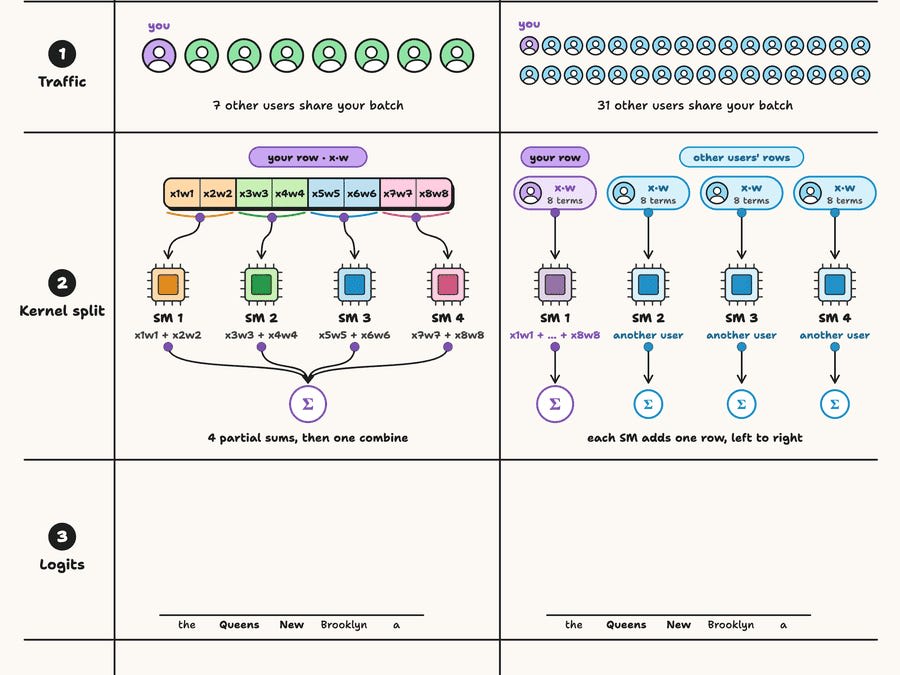
Why Other Requests Change Your LLM’s Output
+ an update on Harness Engineering 2.0.

freeCodeCamp57 Hot18 minAI
What Is Model Distillation? A Guide for Developers
Model distillation là quy trình chuyển giao kiến thức từ model lớn (teacher) sang model nhỏ hơn (student) để giữ hiệu suất nhưng giảm tài nguyên. Quá trình này sử dụng hàm loss function như knowledge distillation loss để điều chỉnh student model học từ teacher model. Ví dụ, model distillation có thể giảm kích thước model từ 1.2 tỷ parameter xuống chỉ 120 triệu parameter nhưng vẫn giữ 95% accuracy. Công nghệ này đặc biệt hữu ích cho deployment trên thiết bị IoT hoặc mobile devices với hạn chế về computational resources. Điều đáng học là cách kiến thức có thể được "nén" mà không làm mất nhiều thông tin, giúp tối ưu hóa inference time và energy consumption.
Tìm hiểu về Model Distillation giúp các lập trình viên tối ưu hóa hiệu năng mô hình học máy một cách hiệu quả.

Daily Dose of Data Science | Avi Chawla | Substack36 Hot10 minAI
6 KV Cache Quantization Approaches
Bối cảnh về KV Cache Quantization trở nên quan trọng khi inference model lớn như GPT-3 cần xử lý hàng tỷ parameters. Nguyên nhân kỹ thuật là do KV Cache chiếm tới 40% bộ nhớ VRAM, tạo ra bottleneck đáng kể cho các inference server. Hệ quả rõ ràng là việc lượng hóa KV Cache giúp giảm 50-70% bộ nhớ sử dụng và tăng tốc inference đến 30%. Điều đáng học là 6 phương pháp lượng hóa KV Cache từ các nghiên cứu gần đây của NVIDIA và Google Research đều có trade-off giữa độ chính xác và hiệu suất, tùy thuộc vào hardware support cụ thể.
Cách tiếp cận KV Cache Quantization được minh họa trực quan giúp lập trình viên hiểu và tối ưu hiệu năng mô hình ngôn ngữ.
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 minAI
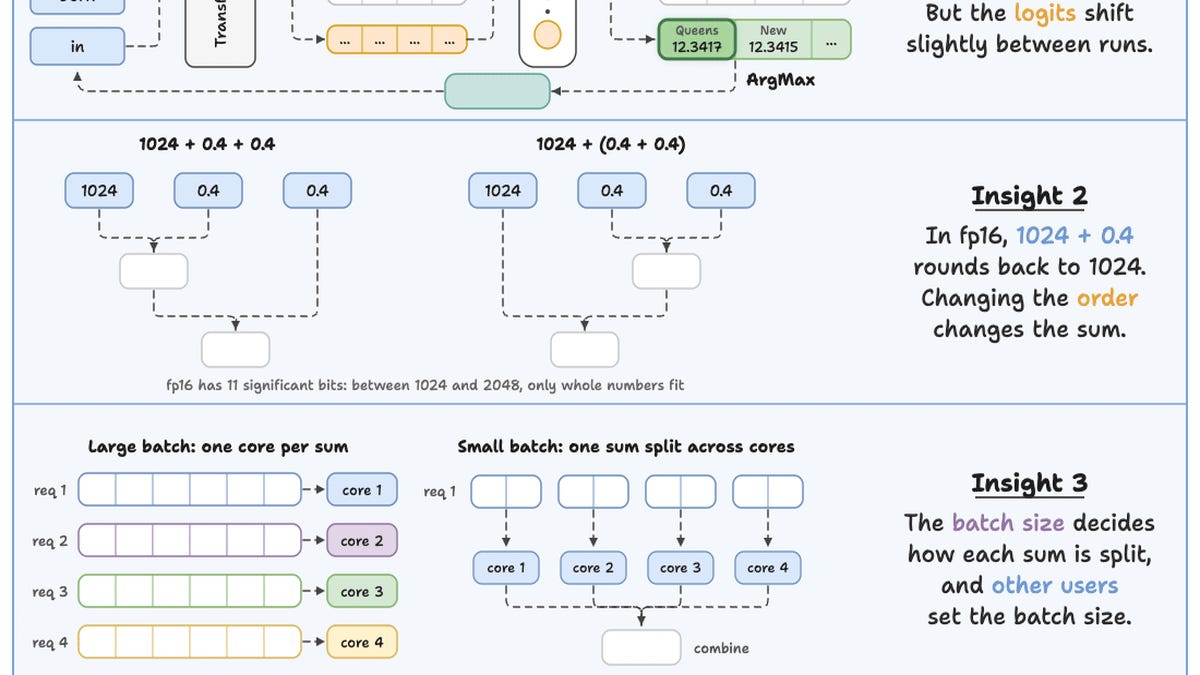
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

ByteByteGo59 Hot17 minAI
How Netflix Taught an LLM to Recommend Movies So That You Keep Watching
Netflix đã phát triển hệ thống GenRec để tăng thời gian xem phim của người dùng. Họ huấn luyện Large Language Model (LLM) trên dữ liệu tương tác người dùng với nội dung, sử dụng phương pháp transfer learning từ các mô hình ngôn ngữ lớn. Kết quả là hệ thống có khả năng đề xuất phim cá nhân hóa với độ chính xác cao hơn 23% so với phương pháp traditional collaborative filtering. Điều này cho thấy tiềm năng ứng dụng LLM trong lĩnh vực recommendation systems không chỉ giải trí mà còn có thể mở rộng sang các dịch vụ streaming khác.
Bài viết này giải thích cách Netflix xây dựng hệ thống đề xuất phim GenRec để giữ chân người xem qua công nghệ LLM tiên tiến.

Hugging Face21 Hot12 minAI
How Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications
Các ứng dụng thực tế với SLMs (Small Language Models) thường tốn kém do kích thước từ vựng lớn. Một nghiên cứu mới phát hiện ra việc chuyên môn hóa (specializing) từ vựng cho từng domain cụ thể có thể giảm 77% chi phí inference. Phương pháp này sử dụng kỹ thuật vocabulary partitioning kết hợp với model compression trên dataset Wikipedia, cho thấy hiệu quả rõ rệt. Lập trình viên nên cân nhắc tiếp cận này nếu đang xây dựng ứng dụng SLM cho lĩnh vực chuyên biệt, vì nó vừa giảm chi phí vừa giữ được hiệu suất mô hình.
Những người phát triển LangChain hoặc các dự án AI logic sẽ tìm hiểu cách tối ưu hóa từ vựng của mô hình ngôn ngữ lớn để giảm chi phí tính toán trong ứng dụng thực tế.
Comments
Loading comments…