Đang tải bảng tin…

Phoronix0 Hot0 bình luận2 phút đọc
AMD's ROCm HRX Loom v0.1 Released For Targeting AMD CPUs, GPUs & NPUs
AMD released Loom SDK v0.1, the first tagged version of its compiler and IR stack within ROCm HRX (HIP Runtime Extended). Loom compiles kernels and asynchronous device programs and specializes them for execution on CPUs, AMD GPUs, and AMD NPUs. It targets AMDGPU HSA emission for GPU execution and SPIR-V/Vulkan for portable execution, with x86 and WebAssembly support still maturing. The SDK packages a compiler, runtime, Python APIs, and command-line tools including loom-fetch and loom-serve, and it's available on GitHub or via pip as the hrx-loom package.
Nguồn: https://www.phoronix.com/news/AMD-ROCm-HRX-Loom-0.1. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

The Register1 Hot4 phút
Howler will have AI answer your questions, then burn the chat
Ask AI dumb things and leave no local chat history, all with the style of a kids' fantasy novel – or rather, one of its magical letters

The Next Web1 Hot2 phút
Baseten’s joey-1 makes AI decisions for a penny per million tokens
Baseten's open-weights joey-1 is a 2B model that picks answers instead of writing text, costing $0.01 per million tokens with 20ms response times.

XDA Developers116 Hot4 phútAI
I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B model faster than I can read
Một lập trình viên đã tìm ra cách chạy model Llama 35B trên laptop GPU chỉ 8GB VRAM với tốc độ đáng kinh ngạc. Nguyên nhân kỹ thuật nằm ở việc chỉnh sửa cờ n_gpu_layers trong llama.cpp, cho phép tận dụng hiệu quả bộ nhớ VRAM thay vì để nó trở thành điểm nghẽn. Hệ quả là model 35B parameters chạy nhanh đến mức người dùng không kịp theo dõi, vượt xa các kỳ vọng ban đầu về giới hạn phần cứng. Điều đáng học hỏi là đôi khi vấn đề không nằm ở cấu hình phần cứng mà ở cách tối ưu hóa phần mềm để khai thác tiềm năng thực sự của hardware.
Bài viết tiết lộ cách tối ưu hóa một cờ trong llama.cpp để chạy mô hình 35B trên GPU 8GB nhanh hơn tốc độ đọc của bạn.

Hacker News241 Hot2 phútAI
Pele – Mermaid diagrams as themeable SVG
Pele là một thư viện open source nhẹ giúp tạo các diagram Mermaid thành định dạng SVG. Thư viện này sử dụng CSS variables để cho phép tùy biến theme cho diagram, giúp lập trình viên có thể thay đổi màu sắc, kiểu dáng dễ dàng mà không cần chỉnh sửa trực tiếp code SVG. Với kích thước nhỏ nhẹ, Pele phù hợp cho các dự án cần hiển thị diagram nhưng cần tối ưu hiệu năng. Bạn có thể tích hợp Pele vào các dự án web hiện tại để tạo ra các diagram có thể tùy chỉnh theme linh hoạt thông qua CSS variables.
Pele cho phép lập trình viên tùy biến Mermaid diagrams bằng CSS variables, mang lại sự linh hoạt trong việc thiết kế giao diện.


The Next Web1 Hot3 phút
Mistral releases open weights for its 1 trillion-parameter Large 4 model
Mistral has released the weights of Mistral Large 4 on Hugging Face, after three weeks of extra training lifted its coding and cyber defence scores.

Hacker News46 Hot1 phútAI
Color Names
Dự án cung cấp không gian chứa 31,970 tên màu, mỗi cái tên được chọn bởi một cá nhân. …
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 phútAI
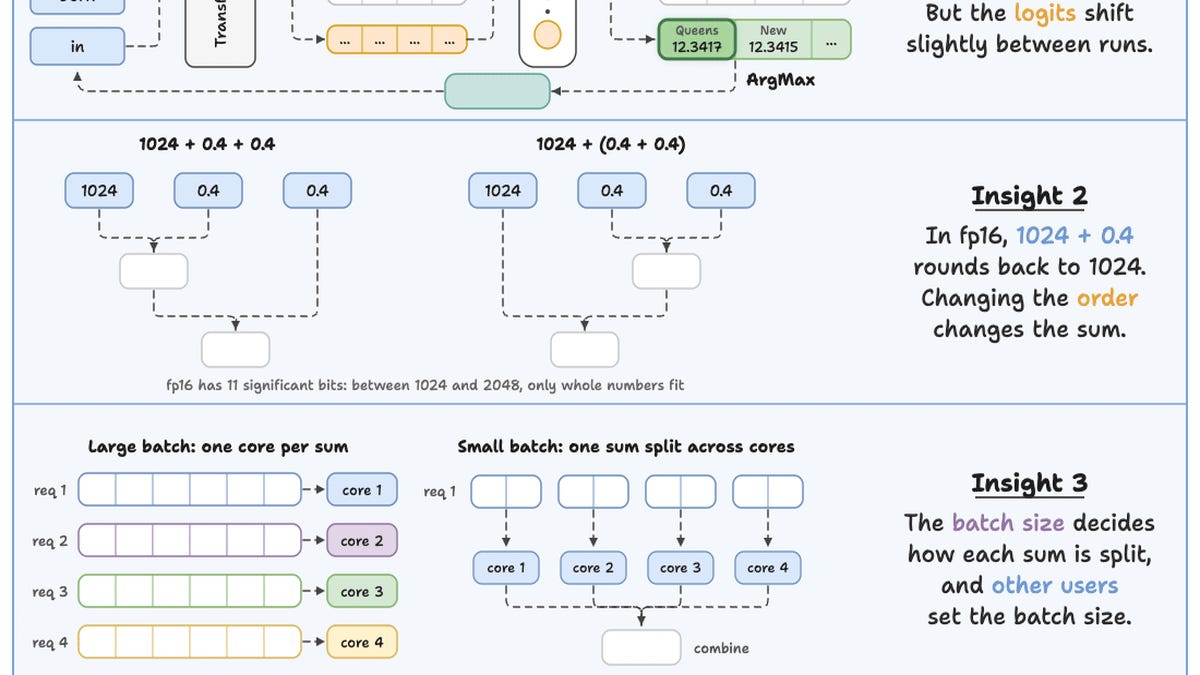
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.
Bình luận
Đang tải bình luận…