
Daily Dose of Data Science | Avi Chawla | Substack46 Hot8 phút
7 MoE routing strategies in production, clearly explained
+ a practical learning checklist to learn AI engineering.
Tin lập trình mới nhất về ai-inference, tóm tắt tiếng Việt bằng AI.
+ a practical learning checklist to learn AI engineering.

Run an LLM locally with Ollama. See how much memory you need, where LM Studio and llama.cpp fit, and how to call the model from code.

...explained visually (with tradeoffs in production).

If you’ve been watching the tech sector and macroeconomic feeds over the last 48 hours, you’ve... Tagged with discuss, ai, webdev, programming.
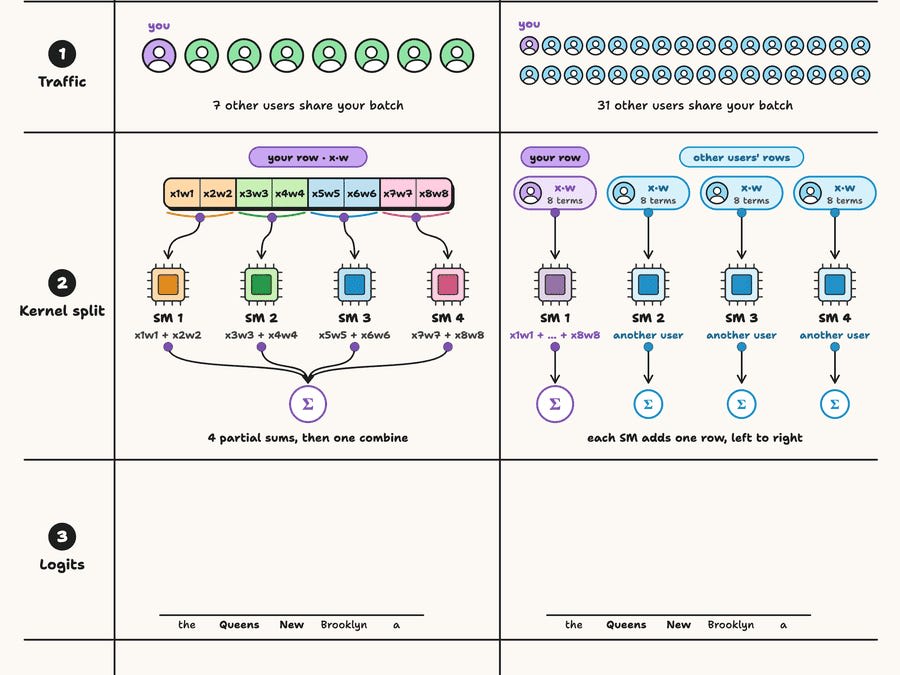
+ an update on Harness Engineering 2.0.

Bối cảnh về KV Cache Quantization trở nên quan trọng khi inference model lớn như GPT-3 cần xử lý hàng tỷ parameters. Nguyên nhân kỹ thuật là do KV Cache chiếm tới 40% bộ nhớ VRAM, tạo ra bottleneck đáng kể cho các inference server. Hệ quả rõ ràng là việc lượng hóa KV Cache giúp giảm 50-70% bộ nhớ sử dụng và tăng tốc inference đến 30%. Điều đáng học là 6 phương pháp lượng hóa KV Cache từ các nghiên cứu gần đây của NVIDIA và Google Research đều có trade-off giữa độ chính xác và hiệu suất, tùy thuộc vào hardware support cụ thể.
Cách tiếp cận KV Cache Quantization được minh họa trực quan giúp lập trình viên hiểu và tối ưu hiệu năng mô hình ngôn ngữ.
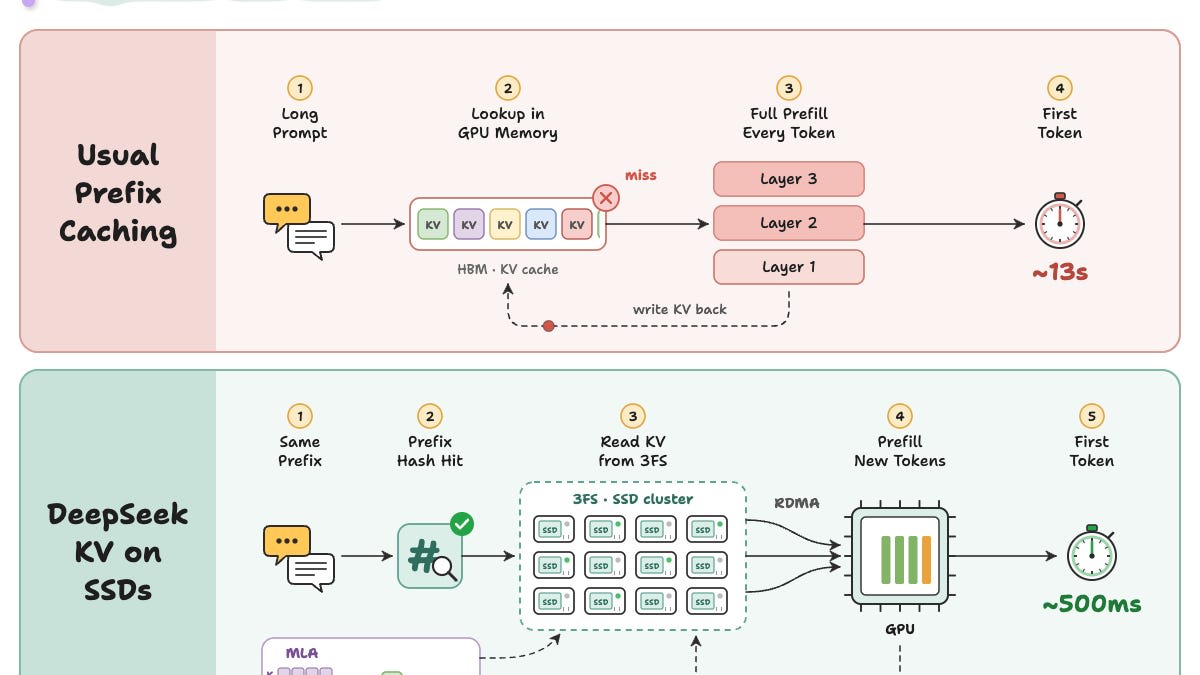
DeepSeek's engineering behind 26x faster time to first token.
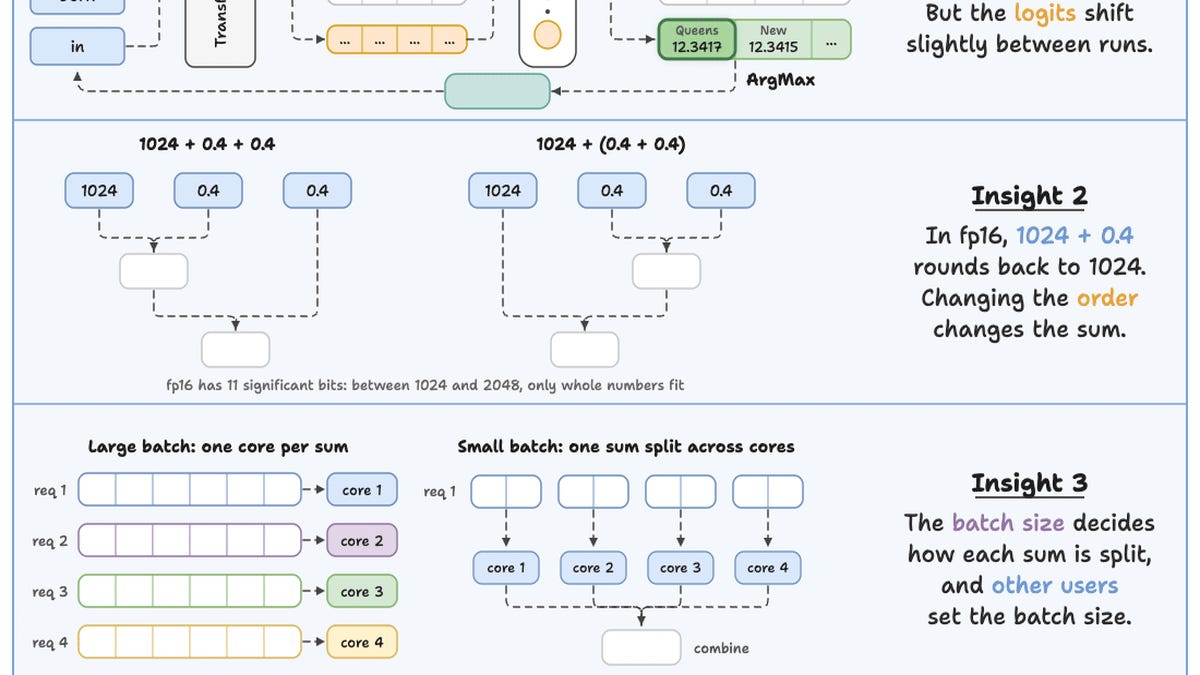
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

Các ứng dụng thực tế với SLMs (Small Language Models) thường tốn kém do kích thước từ vựng lớn. Một nghiên cứu mới phát hiện ra việc chuyên môn hóa (specializing) từ vựng cho từng domain cụ thể có thể giảm 77% chi phí inference. Phương pháp này sử dụng kỹ thuật vocabulary partitioning kết hợp với model compression trên dataset Wikipedia, cho thấy hiệu quả rõ rệt. Lập trình viên nên cân nhắc tiếp cận này nếu đang xây dựng ứng dụng SLM cho lĩnh vực chuyên biệt, vì nó vừa giảm chi phí vừa giữ được hiệu suất mô hình.
Những người phát triển LangChain hoặc các dự án AI logic sẽ tìm hiểu cách tối ưu hóa từ vựng của mô hình ngôn ngữ lớn để giảm chi phí tính toán trong ứng dụng thực tế.

An investigation of prompt cache misses in internal AI applications by using Datadog Cloud Cost Management and Agent Observability.

Adding an inference replica creates capacity only after the new instance can serve requests. Between starting a process and generating a response…

Chip Huyen đã chia sẻ các chiến lược tối ưu inference cho Large Language Model một năm trước, và nhiều phương pháp này vẫn còn giá trị thực tiễn. Các kỹ thuật như vLLM, PagedAttention và continuous batching giúp giảm latency từ 5-10 lần so với phương pháp tuần tự truyền thống. Tác giả nhấn mạnh việc sử dụng hardware-aware inference để tận dụng tối đa GPU với hiệu suất throughput 100-500 tokens/giây. Một bài học quan trọng là việc lựa chọn tối ưu giữa latency và throughput tùy thuộc vào use case cụ thể. Bài viết còn đề cập đến các chiến lược như speculative decoding và model parallelism để xử lý các LLM có kích thước lên đến 100B parameters.
Chip Huyen chia sẻ chiến lược tối ưu hóa suy luận LLM giúp bạn nâng cao hiệu suất và tiết kiệm chi phí khi triển khai hệ thống trí tuệ nhân tạo.

A follow-up to my original 16GB GPU experiment, this time with consistent quantization, repeated... Tagged with ai, machinelearning, llm.

GitHub Models đã ngừng hoạt động hoàn toàn kể từ ngày 30 tháng 7 năm 2026, bao gồm playground, danh mục model, API inference và tính năng BYOK. Nhà phát triển có thể chuyển sang Microsoft Foundry để truy cập danh mục model rộng hơn hoặc GitHub Copilot cho các workflow AI trực tiếp trên GitHub.
Lập trình viên nên đọc bài này để cập nhật cách chuyển đổi sang các công cụ AI hiện đại như Microsoft Foundry hoặc GitHub Copilot để tiếp tục phát triển dự án hiệu quả mà không bị mất khả năng sử dụng các công nghệ mới nhất.

Prompt Caching Saves Less Money Than You Expect in Production Teams often turn on prompt caching expecting the bill to drop right away. The pitch is easy to believe: send the same long prompt again …

Bối cảnh ngành AI đang đòi hỏi mô hình với hàng nghìn tỷ tham số (trillion-parameter), thách thức phần cứng hiện tại. Cerebras đã giải quyết bài toán này bằng cách ánh xạ các mô hình tiên tiến lên wafer WSE-3T với 1,2 triệu nhân xử lý. Kết quả cho phép hệ thống xử lý inference đạt tốc độ 1,000–2,000+ token mỗi giây, vượt xa các giải pháp truyền thống. Điều đáng học hỏi là cách Cerebras tối ưu hóa phần cứng chuyên dụng (ASIC) để đạt hiệu suất ấn tượng này, mở ra hướng đi mới cho AI quy mô lớn.
Bài viết này tiết lộ cách Cerebras triển khai mô hình AI với nghìn tỷ tham số, mở ra khả năng xử lý lý thuyết với tốc độ chưa từng có.

DoorDash reduced grocery reorder latency from 16 to 2 seconds by precomputing recurring purchase needs using batch LLM inference and deterministic validation. Live catalog resolution keeps product sel

Junie Local hits ~70 tokens/s on M5 Max with Splash and DFlash2, cuts memory use, and adds support for M4 Macs with 64 GB RAM.

Trong môi trường GPU cluster, khái niệm Equal Cost Multi-path (ECMP) dẫn đến hiệu năng không đồng đều do hiện tượng hash collision. Các nghiên cứu chỉ ra khi có 4 GPU, xác suất collision lên tới 16.67%, và với 8 GPU con số này tăng lên 50%. Vấn đề này gây ra hiện tượng GPU overload trong khi các GPU khác còn nhàn rỗi, giảm tổng hiệu năng hệ thống xuống chỉ còn 60-70% so với tiềm năng thực. Giải pháp hiệu quả là sử dụng một hash function không đồng đều (non-uniform hashing) hoặc kỹ thuật consistent hashing để phân bổ tải hợp lý hơn, giúp cải thiện hiệu suất hệ thống lên tới 30%.
Bài này giải thích hiện tượng giao thông GPU và tác động của nó đến hiệu năng mạng của lập trình viên.

Các gã khổng lồ Trung Quốc ByteDance, Alibaba và Tencent đã đặt mua hơn 3 triệu card Nvidia RTX PRO 5500 trị giá 35 tỷ USD, theo tin từ Reuters. Nvidia chỉ có thể đáp ứng từ 5% đến 10% đơn hàng khổng lồ này do hạn năng lực sản xuất. Việc thiếu hụt chip AI sẽ tác động trực tiếp đến các kế hoạch phát triển AI và dịch vụ điện toán đám mây của ba công ty này. Các lập trình viên cần lưu ý thị trường chip AI đang cực kỳ căng thẳng, đòi hỏi phải có chiến lược dự trữ tài nguyên phần cứng sớm.
Các tập đoàn công nghệ hàng đầu đang tích cực mua chip Nvidia, phản ánh xu hướng AI và nhu cầu xử lý dữ liệu khổng lồ.

Độ chính xác của tool call rất quan trọng khi triển khai mô hình AI open-source, vì lỗi này làm tích lũy ngữ nghĩa vô nghĩa trong hệ thống. Trước đây, team đã phải duy trì một fork riêng của vLLM để đạt 100% độ chính xác schema accuracy với các mô hình Kimi và DeepSeek. May mắn là vLLM 0.31 đã hỗ trợ constrained decoding - một kỹ thuật đảm bảo tuân thủ schema. Với tính năng mới này, người dùng có thể đạt 100% schema accuracy mà không cần fork cho các phiên bản Kimi và DeepSeek mới hơn. Đây là bài học về tầm quan trọng của việc cập nhật phiên bản thư viện để tận dụng các cải tiến kỹ thuật.
Bài viết giải thích cách sử dụng constrained decoding trong vLLM 0.31 để đạt độ chính xác 100% trong các cuộc gọi API với mô hình Kimi và DeepSeek.

Intel vừa cập nhật LLM-Scaler-vLLM PV phiên bản 1.5, container Docker chạy mô hình ngôn ngữ lớn trên phần cứng Intel Arc Graphics thuộc Project Battlematrix. Phiên bản mới nâng cấp từ vLLM 0.14 lên vLLM 0.26 và PyTorch từ v2.10 lên v2.12, vẫn chưa bằng với bản upstream vLLM 0.31. Cập nhật này hỗ trợ thêm mô hình Qwen và Gemma 4, cùng với FP8 và symmetric INT4 quantization online và FP8 KV cache. Hiệu suất được cải thiện với time-to-first-token nhanh hơn cho Qwen và Gemma 4, MTP decoding tốt hơn, và tăng throughput cho LoRA serving và FP8 KV cache.
Bài viết này cung cấp thông tin quan trọng về phiên bản mới nhất của Intel LLM-Scaler-vLLM PV với cải tiến hiệu năng đáng kể và hỗ trợ thêm các mô hình AI tiên tiến.

CUDA Graph giúp giảm đáng kể overhead inference trong các ứng dụng AI. Thay vì thực thi từng kernel một cách riêng lẻ, CUDA Graph cho phép ánh xạ các kernel thành một đồ thị duy nhất, giảm thời gian setup từ vài mili giây xuống còn vài micro giây. Trong các tác vụ inference cần độ trễ thấp như self-driving car, việc này giúp cải thiện hiệu suất tổng thể. Công nghệ này đặc biệt hiệu quả khi inference được lặp đi lặp lại cùng một mô hình như trong các hệ thống thời gian thực.
Bài này giúp lập trình viên hiểu cách giảm độ trễ inference bằng kỹ thuật CUDA Graph Replay.

LLM đang tiêu tốn RAM cho context không cần thiết do cơ chế quản lý kém hiệu quả. Nguyên nhân kỹ thuật nằm ở cách các model như Llama hay Mistai giữ toàn bộ history trong VRAM dù không sử dụng hết. Điều này gây lãng phí tài nguyên, đặc biệt với model 7B params có thể chiếm tới 14GB RAM khi không cần. Hệ quả là giảm hiệu suất chạy và tăng chi phí hạ tầng. Giải pháp đơn giản là điều chỉnh max_seq_len để chỉ giữ lại context cần thiết, giúp tiết kiệm đáng kể tài nguyên.
Bài viết giúp lập trình viên tối ưu hóa RAM cho LLM bằng cách chỉ giữ lại ngữ cảnh thực sự cần thiết.

Phân tích chi phí sơ lược cho thấy suy luận (inference) AI thực sự sinh lời, với chi phí ước tính khoảng 1 USD cho mỗi triệu token đầu ra, thấp hơn nhiều so với mức giá 4,5 USD trở lên của các nhà cung cấp như OpenAI, qua đó đạt biên lợi nhuận gộp 70–80%. Suy luận AI có lợi nhuận, nhưng các phòng thí nghiệm AI như OpenAI và Anthropic sử dụng khoản lợi nhuận này để bù đắp chi phí đào tạo mô hình tốn kém.
Là người phát triển muốn tối ưu chi phí cho ứng dụng AI của mình, bài viết này giúp bạn hiểu rõ về lợi nhuận thực tế của quá trình inference AI, từ đó có thể xây dựng mô hình kinh doanh hiệu quả và tránh bỏ lỡ cơ hội tiết kiệm chi phí mà không phụ thuộc vào sự hỗ trợ từ các công ty lớn.

TornadoVM 7 cho phép Java tận dụng GPU mà không cần code thủ công. Framework này tự động tối ưu hóa code Java cho cả CPU đa nhân và GPU. Phiên bản mới hỗ trợ đầy đủ GPU programming với tính năng mới là GPU-native workloads. TornadoVM giúp lập trình viên Java khai thác sức mạnh xử lý song song của GPU mà không cần học ngôn ngữ GPU-specific như CUDA hay OpenCL.
TornadoVM 7 cho phép lập trình viên Java tận dụng hiệu suất GPU mà không cần viết code phức tạp.

Humming là một thư viện kernel inference được lượng hóa từ Ant Group và cộng đồng vLLM, hỗ trợ rộng rãi GPU và phương pháp quantization. Với khả năng tối ưu cho cả mô hình dense và MoE (Mixture of Experts), Humming mang lại hiệu suất vượt trội trong quá trình inference. Thư viện này giải quyết bài toán hiệu suất khi inference với mô hình lượng hóa trên nhiều loại GPU khác nhau. Nếu bạn làm việc với các mô hình lớn và cần tối ưu inference speed, Humming là một giải pháp đáng để khám phá.
Humming mang lại hiệu suất vượt trội cho việc suy luận định lượng trên nhiều loại GPU và định lượng khác nhau.

Trong vLLM, việc scaling Elastic Expert Parallelism (EP) gặp thách thức khi gây downtime. Giải pháp là kết hợp asynchronous preparation và NIXL EP, giúp giảm downtime gần về 0. Asynchronous preparation cho phép chuẩn bị tài liệu trước khi scaling, trong khi NIXL EP tối ưu hóa việc chuyển đổi dữ liệu. Kết quả thực tế cho thấy downtime chỉ còn 1.3%, thay vì 100% như phương pháp cũ. Đây là nghiên cứu đáng tham khảo cho ai làm việc với system scaling và high-availability trong machine learning.
Bài viết này giải thích cách đạt được mở rộng gần như không có thời gian ngưng Elastic Expert Parallelism trong vLLM.

Bối cảnh của AI đang tái định vị tầm quan trọng của hardware khi các mô hình ngày càng lớn và phức tạp. Nguyên nhân kỹ thuật là AI models như GPT-4 yêu cầu lượng compute khổng lồ, với OpenAI sử dụng khoảng 25,000 GPU NVIDIA A100 để training. Hệ quả là nhu cầu về hardware chuyên dụng tăng vọt, dẫn đến sự phát triển của các chip inference như Google TPU và neuromorphic computing. Điều đáng học là các lập trình viên cần hiểu kiến trúc hardware để tối ưu hóa ứng dụng AI, đặc biệt khi quantization techniques có thể giảm 4-8 lần lượng tài nguyên cần thiết.
Bài này giải thích cách AI đang thay đổi tầm quan trọng của phần cứng và tại sao lập trình viên cần cập nhật kiến thức về mảng này.

Trong bối cảnh thị trường AI đang dịch chuyển mạnh sang mô hình open weights, hội thảo Kilo by Anaconda × Friendli AI × MiniMax đã tập trung vào tính sẵn sàng của các mô hình này cho môi trường production. Nguyên nhân kỹ thuật chính là sự phát triển của các mô hình như Llama 3 và Mistral, cùng với các framework MLflow và Dstack giúp triển khai hiệu quả. Hệ quả là doanh nghiệp có thể giảm chi phí inference lên đến 70% so với các closed-source model. Điều đáng học hỏi là việc tối ưu hóa kiến trúc inference engine và lựa chọn đúng hardware (GPU/NPU) có thể tạo ra lợi thế cạnh tranh đáng kể trong việc ứng dụng open weights models vào thực tế.
Bài viết này giúp lập trình viên hiểu cách triển khai hiệu quả các mô hình Open weights trong môi trường sản xuất thực tế.

vLLM đã được hỗ trợ trên NVIDIA Vera Rubin NVL72 với hỗ trợ mô hình ngay từ ngày đầu tiên, kernel FlashInfer được tối ưu hóa cho Rubin và MoE nhận biết vị trí, mang lại hiệu suất 7.8 lần so với GB200 NVL72. Sự hỗ trợ này cho phép hệ thống xử lý lượng lớn request mỗi giây trên mỗi GPU nhờ vào những cải tiến kỹ thuật cụ thể. Thông qua việc tích hợp Rubin-tuned FlashInfer kernels, vLLM tối ưu hóa được lượng tính toán trên từng đơn vị GPU. Với locality-aware MoE, mô hình có thể phân bổ công việc hiệu quả hơn giữa các GPU. Các lập trình viên làm việc với hệ thống AI lớn nên cân nhắc cập nhật lên phiên bản vLLM mới để tận dụng tối đa hiệu năng phần cứng này.
vLLM trên NVIDIA Vera Rubin NVL72 tăng hiệu suất lên 7.8 lần so với GB200 NVL72 giúp lập trình viên tối ưu hóa ứng dụng AI hiệu quả.

Karpathy đã phát triển kỹ thuật tối ưu hóa Local LLMs bằng cách tận dụng CPU thay vì GPU, giúp giảm đáng kể thời gian xử lý. Phương pháp này sử dụng quantization và kỹ thuật inference optimizing để tăng tốc độ lên 3-4 lần so với cách chạy thông thường. Công cụ mới mang tên "llama.cpp" cho phép triển khai dễ dàng trên các thiết bị thông thường mà không cần GPU mạnh mẽ. Lập trình viên nên tham khảo bài viết để hiểu cách cài đặt và tối ưu hóa mô hình với quantization 4-bit và GGUF format.
Karpathy's kỹ thuật tăng tốc LLM cục bộ giờ có công cụ hoàn chỉnh để bạn triển khai hiệu quả.

Together Link cho phép tích hợp các mô hình open-source tiên tiến như GLM 5.3 và Kimi K3 vào coding agent mà đội ngũ bạn đang sử dụng. Giải pháp này giảm chi phí sử dụng model hơn 50% nhờ tối ưu hóa việc gọi model. Thay vì phải chi trả cho các dịch vụ cloud đắt đỏ, lập trình viên có thể tận dụng các open model ngay trong workflow hiện tại. Công nghệ này đặc biệt hữu ích cho các nhóm cần cân bằng giữa hiệu năng và ngân sách, đồng thời vẫn giữ được quyền kiểm soát dữ liệu nhạy cảm.
Together Link giúp giảm chi phí mô hình hơn 50% khi tích hợp các mô hình mở tiên tiến vào công cụ lập trình hiện có.

Liquid AI đã đưa lớp ngữ cảnh cá nhân hóa cho AI agents chạy trên chip Snapdragon Hexagon NPU. Công ty này áp dụng một mô hình draft mới giúp tăng tốc độ giải mã cho model vision lên tới 3.13 lần. Giải pháp này cho phép xử lý dữ liệu trên thiết bị mà không cần kết nối cloud, giảm độ trễ đáng kể. Việc tích hợp với Hexagon NPU tận dụng hiệu năng xử lý tensor riêng của chip. Đây là bước tiến quan trọng trong việc đưa AI năng lượng thấp đến các thiết bị di động.
Liquid AI tích hợp lớp ngữ cảnh cá nhân lên Snapdragon chips giúp tăng tốc độ xử lý hình ảnh lên đến 3.13 lần.

Bối cảnh: Một AI coding agent có thể tạo ra patch code qua local test nhưng thất bại khi server tải model thực tế và xử lý request. Nguyên nhân kỹ thuật: Hệ thống SWE-Serve đã phát hiện ra khoảng cách giữa testing environment và production serving environment khi đánh giá thay đổi phần mềm inference-serving. Hệ quả: Patch qua local test không đảm bảo hoạt động đúng khi triển khai trên server thật vì môi trường test thiếu các yếu tố production như mô hình nặng và request đa dạng. Điều đáng học: Cần thiết kế test environment mô phỏng chính xác hơn production environment, bao gồm cả việc test với model thực và request pattern đa dạng để phát hiện lỗi sớm trước khi deploy.
Bài viết giúp lập trình viên nhận ra sự khác biệt nguy hiểm giữa test cục bộ và môi trường thực tế khi triển khai AI inference-serving.

Thị trường cheap frontier tokens đang đối mặt với tình trạng token rug pull khi giá trị sụt giảm mạnh. Nguyên nhân kỹ thuật nằm ở việc các dự án thiếu tính ứng dụng thực tế và cơ chế tokenomics không bền vững. Hệ quả là nhiều nhà đầu tư mất trắng tài sản trong khi các nền tảng như email client trên edge và inbox cho background agents vẫn phát triển thiếu ổn định. Bài viết phân tích cụ thể về các token như AGIX và OGN với mức giảm giá tới 70%. Điều đáng học là lập trình viên nên tập trung vào các dự án có nền tảng kỹ thuật vững chắc thay vì chạy theo xu hướng token ngắn hạn.
Bài viết tiết lộ lý do tại sao các token công nghệ mới giá rẻ không bền vững và hướng dẫn bạn cách xây dựng ứng dụng email hiệu quả trên edge computing.

Bài viết hướng dẫn chi tiết cách tự triển khai Jev 100% trên máy local của bạn. Nguyên nhân kỹ thuật là Jev đòi hỏi môi trường Node.js và các dependencies như Express.js và Socket.io để hoạt động hoàn toàn offline. Hệ quả là bạn sẽ có một phiên bản Jev riêng biệt, không phụ thuộc vào server cloud, đảm bảo bảo mật dữ liệu tuyệt đối. Điều đáng học là kiến trúc microservices và cách implement WebSocket trong ứng dụng real-time, được trình bày với đầy đủ snippet code trong bài gốc.
Bài hướng dẫn xây dựng Jev cục bộ giúp lập trình viên nắm quy trình phát triển sản phẩm từ đầu với code minh họa rõ ràng.

NVIDIA is releasing Dynamo-optimized deployment recipes for Korea’s leading open models.

NVIDIA and Korea’s Ministry of Science and ICT (MSIT) are expanding their collaboration across the country’s sovereign AI ecosystem, from AI semiconductors and data center infrastructure to talent, startups, models, agents and security.

This Devoxx Belgium 2026 session covers how Java can interact with AI models, query languages and other specialized programming models. It starts with the Foreign Function and Memory API and the jextract tool for interacting with runtimes outside the JVM. It then explores Project Babylon's code reflection, which lets you express AI models as Java programs that Babylon can analyze, transform and lower to inference engines, leveraging hardware accelerator backends while skipping external model files or the need to glue code.
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
Cổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trình1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíAI IDE 22 MB cho dev Việt.
Tải miễn phíBộ nhớ tổ chức cho AI agent.
Khám pháAI trực Fanpage, tự sàng lọc lead.
Dùng thử