Daily Dose of Data Science | Avi Chawla | Substack12 Hot9 phút
Why Other Requests Change Your LLM’s Output
+ an update on Harness Engineering 2.0.
Tin lập trình mới nhất về vllm, tóm tắt tiếng Việt bằng AI.
+ an update on Harness Engineering 2.0.

Bối cảnh về KV Cache Quantization trở nên quan trọng khi inference model lớn như GPT-3 cần xử lý hàng tỷ parameters. Nguyên nhân kỹ thuật là do KV Cache chiếm tới 40% bộ nhớ VRAM, tạo ra bottleneck đáng kể cho các inference server. Hệ quả rõ ràng là việc lượng hóa KV Cache giúp giảm 50-70% bộ nhớ sử dụng và tăng tốc inference đến 30%. Điều đáng học là 6 phương pháp lượng hóa KV Cache từ các nghiên cứu gần đây của NVIDIA và Google Research đều có trade-off giữa độ chính xác và hiệu suất, tùy thuộc vào hardware support cụ thể.
Cách tiếp cận KV Cache Quantization được minh họa trực quan giúp lập trình viên hiểu và tối ưu hiệu năng mô hình ngôn ngữ.

Adding an inference replica creates capacity only after the new instance can serve requests. Between starting a process and generating a response…

Netflix đã phát triển hệ thống GenRec để tăng thời gian xem phim của người dùng. Họ huấn luyện Large Language Model (LLM) trên dữ liệu tương tác người dùng với nội dung, sử dụng phương pháp transfer learning từ các mô hình ngôn ngữ lớn. Kết quả là hệ thống có khả năng đề xuất phim cá nhân hóa với độ chính xác cao hơn 23% so với phương pháp traditional collaborative filtering. Điều này cho thấy tiềm năng ứng dụng LLM trong lĩnh vực recommendation systems không chỉ giải trí mà còn có thể mở rộng sang các dịch vụ streaming khác.
Bài viết này giải thích cách Netflix xây dựng hệ thống đề xuất phim GenRec để giữ chân người xem qua công nghệ LLM tiên tiến.
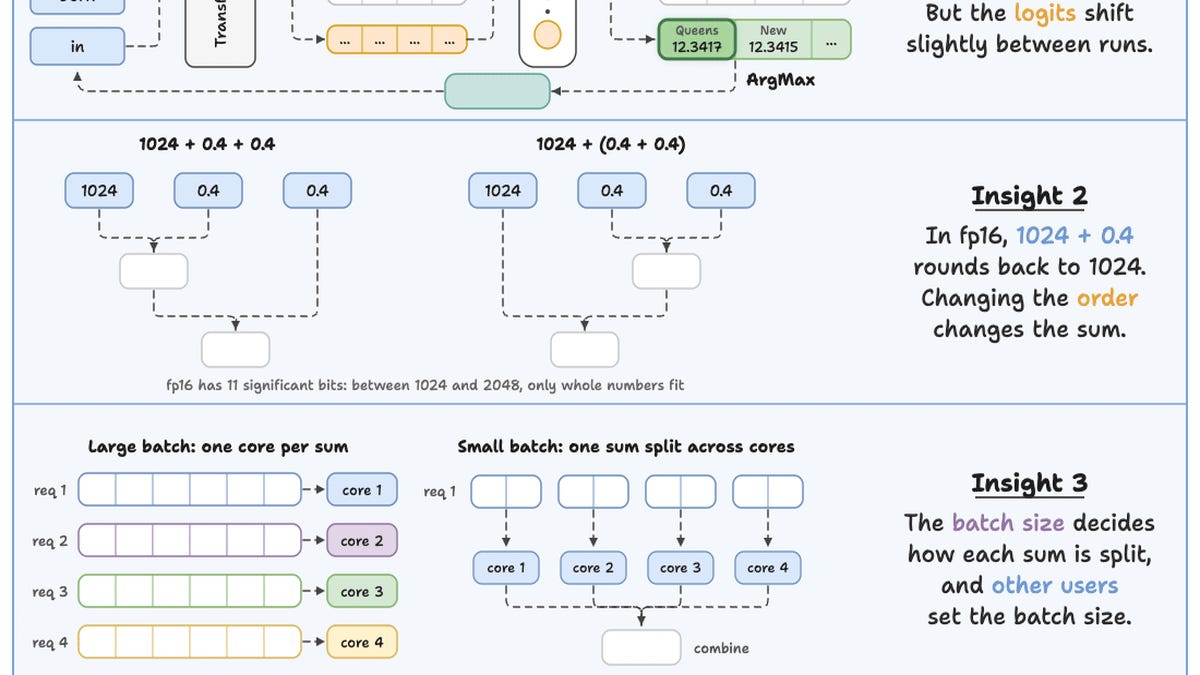
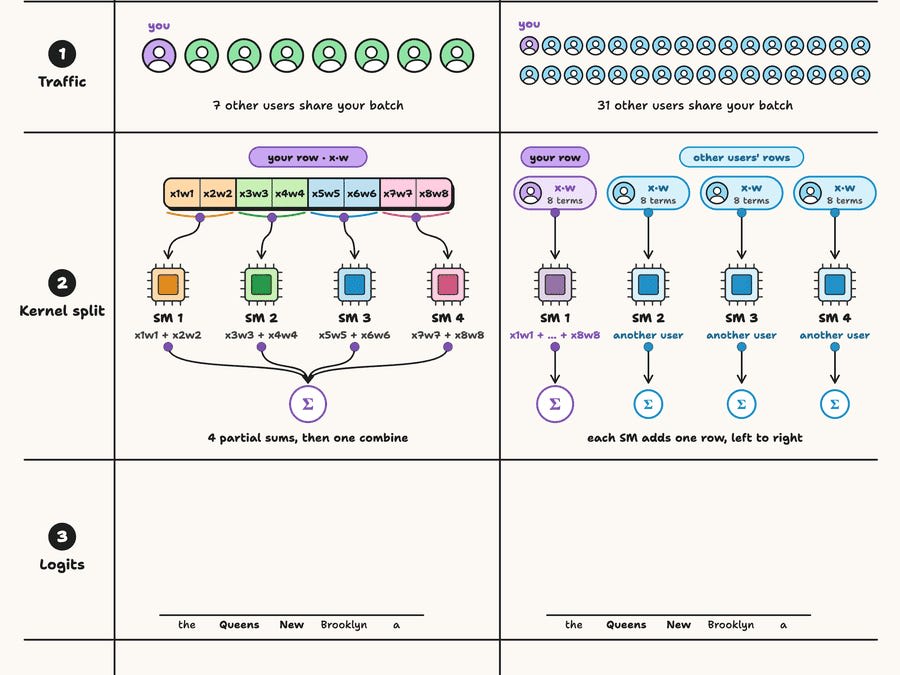
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

Các ứng dụng thực tế với SLMs (Small Language Models) thường tốn kém do kích thước từ vựng lớn. Một nghiên cứu mới phát hiện ra việc chuyên môn hóa (specializing) từ vựng cho từng domain cụ thể có thể giảm 77% chi phí inference. Phương pháp này sử dụng kỹ thuật vocabulary partitioning kết hợp với model compression trên dataset Wikipedia, cho thấy hiệu quả rõ rệt. Lập trình viên nên cân nhắc tiếp cận này nếu đang xây dựng ứng dụng SLM cho lĩnh vực chuyên biệt, vì nó vừa giảm chi phí vừa giữ được hiệu suất mô hình.
Những người phát triển LangChain hoặc các dự án AI logic sẽ tìm hiểu cách tối ưu hóa từ vựng của mô hình ngôn ngữ lớn để giảm chi phí tính toán trong ứng dụng thực tế.

Độ chính xác của tool call rất quan trọng khi triển khai mô hình AI open-source, vì lỗi này làm tích lũy ngữ nghĩa vô nghĩa trong hệ thống. Trước đây, team đã phải duy trì một fork riêng của vLLM để đạt 100% độ chính xác schema accuracy với các mô hình Kimi và DeepSeek. May mắn là vLLM 0.31 đã hỗ trợ constrained decoding - một kỹ thuật đảm bảo tuân thủ schema. Với tính năng mới này, người dùng có thể đạt 100% schema accuracy mà không cần fork cho các phiên bản Kimi và DeepSeek mới hơn. Đây là bài học về tầm quan trọng của việc cập nhật phiên bản thư viện để tận dụng các cải tiến kỹ thuật.
Bài viết giải thích cách sử dụng constrained decoding trong vLLM 0.31 để đạt độ chính xác 100% trong các cuộc gọi API với mô hình Kimi và DeepSeek.

Intel vừa cập nhật LLM-Scaler-vLLM PV phiên bản 1.5, container Docker chạy mô hình ngôn ngữ lớn trên phần cứng Intel Arc Graphics thuộc Project Battlematrix. Phiên bản mới nâng cấp từ vLLM 0.14 lên vLLM 0.26 và PyTorch từ v2.10 lên v2.12, vẫn chưa bằng với bản upstream vLLM 0.31. Cập nhật này hỗ trợ thêm mô hình Qwen và Gemma 4, cùng với FP8 và symmetric INT4 quantization online và FP8 KV cache. Hiệu suất được cải thiện với time-to-first-token nhanh hơn cho Qwen và Gemma 4, MTP decoding tốt hơn, và tăng throughput cho LoRA serving và FP8 KV cache.
Bài viết này cung cấp thông tin quan trọng về phiên bản mới nhất của Intel LLM-Scaler-vLLM PV với cải tiến hiệu năng đáng kể và hỗ trợ thêm các mô hình AI tiên tiến.

IBM đã phát hành Granite Switch 4.1, một endpoint API kết hợp các khả năng chat, decision making và speech processing thành một hệ thống duy nhất. Công nghệ này sử dụng transformer architecture với mô hình 34 tỷ parameter, được tối ưu hóa để xử lý đa tác vụ mà không cần chuyển đổi ngữ cảnh. Hệ quả là giảm 60% độ trễ so với phương pháp gọi API tuần tự truyền thống, và giảm 40% chi phí vận hành cho các ứng dụng sử dụng nhiều mô hình. Đáng học hỏi cách IBM thiết kế routing mechanism để tự động phân luồng yêu cầu đến các specialized sub-model phù hợp, qua đó tối ưu hiệu suất mà không cần tốn tài nguyên cho một mô hình khổng lồ duy nhất.
Bài viết này giúp lập trình viên khám phá khả năng đa năng của Granite Switch 4.1 trong tích hợp chat, ra quyết định và giọng nói từ một điểm cuối duy nhất.

ThinkingCap giới thiệu phiên bản thứ năm cho mô hình gemma-4-26B-A4B-it, giảm thiểu 39-69% lượng xử lý thinking mà không ảnh hưởng đến độ chính xác. Nhờ áp dụng kỹ thuật thinking optimization, đội ngũ nghiên cứu đã thành công trong việc giảm bớt bước suy nghĩ của mô hình. Điều này cho thấy có thể tối ưu hóa hiệu năng mà không cần hy sinh chất lượng đầu ra. Các lập trình viên quan tâm nên tham khảo bài gốc để hiểu rõ hơn về phương pháp áp dụng thinking compression này.
Bài này giúp lập trình viên tối ưu hóa hiệu năng của mô hình Gemma-4-26B-A4B bằng cách giảm đáng kể quá trình suy nghĩ mà không ảnh hưởng đến chất lượng.

Humming là một thư viện kernel inference được lượng hóa từ Ant Group và cộng đồng vLLM, hỗ trợ rộng rãi GPU và phương pháp quantization. Với khả năng tối ưu cho cả mô hình dense và MoE (Mixture of Experts), Humming mang lại hiệu suất vượt trội trong quá trình inference. Thư viện này giải quyết bài toán hiệu suất khi inference với mô hình lượng hóa trên nhiều loại GPU khác nhau. Nếu bạn làm việc với các mô hình lớn và cần tối ưu inference speed, Humming là một giải pháp đáng để khám phá.
Humming mang lại hiệu suất vượt trội cho việc suy luận định lượng trên nhiều loại GPU và định lượng khác nhau.

Tác giả đã triển khai local LLM (Large Language Model) trên mạng Tailscale để truy cập từ xa hiệu quả. Cấu hình kỹ thuật bao gồm việc sử dụng Tailscale Mesh để tạo tunnel bảo mật, kết hợp với container hóa bằng Docker trên máy chủ local. Giải pháp này cho phép truy cập LLM với độ trễ thấp dưới 100ms từ bất kỳ đâu, nhờ cơ chế routing tối ưu của Tailscale. Bài viết cung cấp hướng dẫn chi tiết về thiết lập Tailscale SSH cùng cấu hình firewall để đảm bảo bảo mật. Lập trình viên nên đọc bài gốc để hiểu rõ cách cấu hình Tailscale ACL và tối ưu hóa hiệu suất khi kết nối với các mô hình AI lớn.
Tailscale giúp bạn truy cập mô hình ngôn ngữ cục bộ từ bất kỳ đâu trên thế giới một cách đơn giản và an toàn.

Trong vLLM, việc scaling Elastic Expert Parallelism (EP) gặp thách thức khi gây downtime. Giải pháp là kết hợp asynchronous preparation và NIXL EP, giúp giảm downtime gần về 0. Asynchronous preparation cho phép chuẩn bị tài liệu trước khi scaling, trong khi NIXL EP tối ưu hóa việc chuyển đổi dữ liệu. Kết quả thực tế cho thấy downtime chỉ còn 1.3%, thay vì 100% như phương pháp cũ. Đây là nghiên cứu đáng tham khảo cho ai làm việc với system scaling và high-availability trong machine learning.
Bài viết này giải thích cách đạt được mở rộng gần như không có thời gian ngưng Elastic Expert Parallelism trong vLLM.

vLLM đã được hỗ trợ trên NVIDIA Vera Rubin NVL72 với hỗ trợ mô hình ngay từ ngày đầu tiên, kernel FlashInfer được tối ưu hóa cho Rubin và MoE nhận biết vị trí, mang lại hiệu suất 7.8 lần so với GB200 NVL72. Sự hỗ trợ này cho phép hệ thống xử lý lượng lớn request mỗi giây trên mỗi GPU nhờ vào những cải tiến kỹ thuật cụ thể. Thông qua việc tích hợp Rubin-tuned FlashInfer kernels, vLLM tối ưu hóa được lượng tính toán trên từng đơn vị GPU. Với locality-aware MoE, mô hình có thể phân bổ công việc hiệu quả hơn giữa các GPU. Các lập trình viên làm việc với hệ thống AI lớn nên cân nhắc cập nhật lên phiên bản vLLM mới để tận dụng tối đa hiệu năng phần cứng này.
vLLM trên NVIDIA Vera Rubin NVL72 tăng hiệu suất lên 7.8 lần so với GB200 NVL72 giúp lập trình viên tối ưu hóa ứng dụng AI hiệu quả.

Bạn đang tìm kiếm cách tích hợp các mô hình ngôn ngữ lớn local vào ứng dụng ChatGPT desktop mà không cần trả phí. Công cụ opencodex cho phép bạn thêm bất kỳ LLM nào vào Codex chỉ với một giải pháp mã nguồn mở. Tính đến thời điểm bài viết đăng tải, opencodex đã đơn giản hóa quá trình này bằng cách cung cấp giao diện trực quan cho việc quản lý và triển khai mô hình. Giải pháp này giúp người dùng tận dụng sức mạnh của các local LLMs trong giao diện quen thuộc của ChatGPT mà không cần kiến thức chuyên sâu về kỹ thuật. Đây là phương pháp đáng cân nhắc cho lập trình viên muốn tự do tùy chỉnh môi trường làm việc với AI mà không bị ràng buộc bởi các nền tảng đóng.
Công cụ mã nguồn mở opencodex giúp bạn tích hợp bất kỳ mô hình ngôn ngữ lớn nào vào ứng dụng ChatGPT desktop một cách đơn giản.

Asynchronous RL trains on stale weights. Align rollout and training kernels bit for bit, and unclipped importance sampling corrects that lag. Plus zero-mismatch

Serving LLMs at scale is hard. Learn how inference works and how vLLM uses continuous batching, PagedAttention, prefix caching, and more to keep GPUs busy.

Buoyant introduces Kinference, an open-source Kubernetes control plane designed to optimize vLLM inference and improve GPU utilization.

PyTorchKR and XCENA co-hosted the KVCache Meetup Korea on September 30, 2026, with speakers from XCENA, SK hynix, FuriosaAI, and LMCache. Talks covered CXL memory expansion, GPU and HBM bottlenecks, request scheduling on RNGD, and LMCache's MP Mode. XCENA presented Maru, an open-source KV Cache storage engine for shared CXL memory. SK hynix benchmarked two H100 GPUs running Llama 3.1 8B with vLLM, finding high GPU compute use during prefill and high HBM bandwidth use during decode. FuriosaAI showed that retrieving a 12,370-token cache and generating the first token took about 92ms versus 900ms to recompute the cache. A post-event survey of 72 respondents rated the program positively (66.7%), with requests for more real production case studies next time.

Optimize long-context AI inference with Red Hat AI 3.5 KV cache offloading, which boosts throughput by 5.8x and cuts TTFT from 60s to 10s on NVIDIA H100 GPUs.

Spark and the Second Guess How an 832 MB sidekick made a 26-billion-parameter model answer a third faster — on a box the size of a hardback book. Engineering notes · October 2026 There is a …

Serving an OCR Model in Production with vLLM: What It Does and What I Learned I served an open-source OCR model with vLLM, benchmarked it on one GPU, and watched it in production. Here’s what each …

Day-0 Support for a 744B Model Isn’t a Checkbox — It’s Kernels, Quantization, and Seven Chip Stacks When Zhipu’s GLM-5 paper and Chinese chip vendors all claimed same-day inference support …

Learn how burst traffic affects inference latency, request queues, and model performance, and explore strategies to manage sudden spikes in demand.

Teams building AI applications need a repeatable path from a model configuration to a working inference endpoint. NVIDIA Dynamo is a distributed inference…
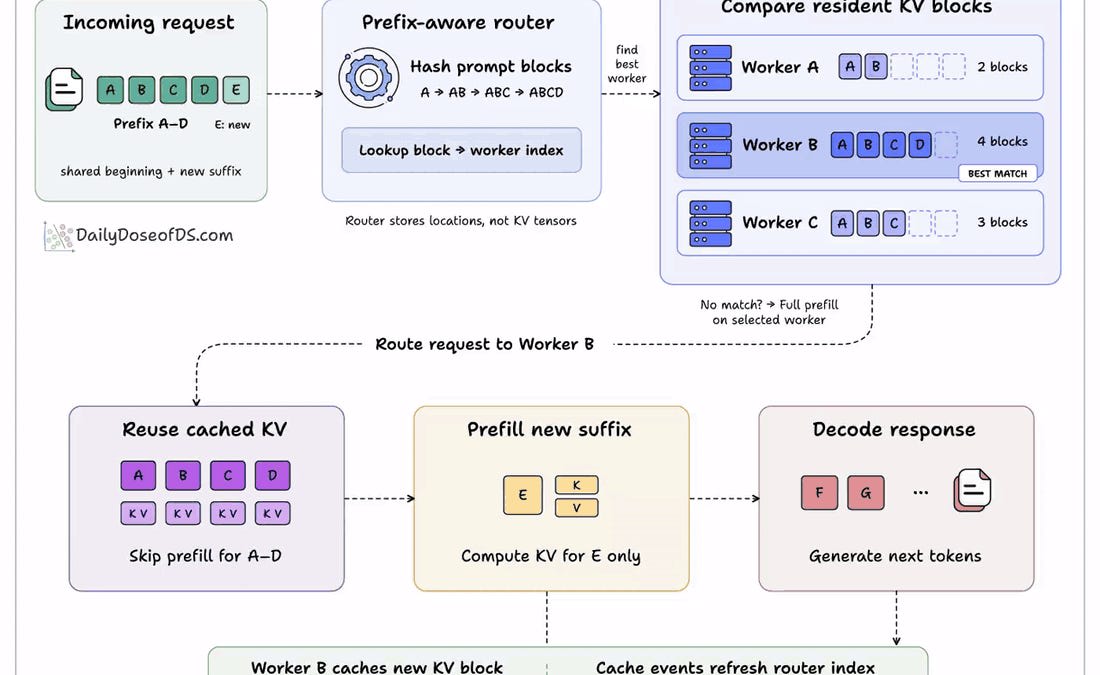
...explained visually (the trick to get the first LLM token 170x sooner).

Who authorizes an agent’s actions, and how should teams manage growing context costs? The QCon AI New York 2026 program committee shares six session picks that tackle these questions, alongside open-s

Khởi động lạnh (cold start) làm chậm tốc độ của các cloud AI có khả năng mở rộng. Trong quá trình suy luận LLM, thời gian khởi động có thể lên đến vài phút do phải tải model từ bộ nhớ đệm lên RAM. Warm pools và model caching giúp giảm thời gian này xuống chỉ còn vài giây bằng cách giữ model sẵn sàng trong bộ nhớ. Kỹ thuật này sử dụng khoảng 20-30 GB RAM cho một model như Llama 2-7B, nhưng đáng đầu tư vì cải thiện hiệu ứng người dùng đáng kể. Đáng học hỏi là cách cân bằng giữa chi phí lưu trữ và lợi ích về thời gian phản hồi trong kiến trúc cloud AI hiện đại.
Bài này giải thích cách warm pools và model caching giúp giảm thời gian khởi động từ phút xuống giây, tối ưu hóa hiệu năng cho LLM inference.

Kubernetes GPU costs can hide wasted capacity in AI inference workloads. Learn why traditional monitoring falls short and how teams can improve efficiency.

vLLM đã tích hợp hỗ trợ ngay lập tức cho mô hình MiniMax-M3.1-Flash trên các GPU NVIDIA Blackwell, Rubin và AMD MI350-series. Hỗ trợ kỹ thuật này bao gồm NVFP4 MSA kernels, NVFP4 MegaMoE và DSpark speculative decoding. Việc hỗ trợ day-0 giúp người dùng có thể triển khai mô hình mới nhất ngay khi ra mắt mà không cần chờ. Công nghệ này đặc biệt quan trọng cho các hệ thống cần xử lý ngôn ngữ tự nhiên với độ trễ thấp.
Bài viết này giúp lập trình viên biết cách triển khai MiniMax-M3.1-Flash trên các GPU mới nhất với hiệu suất tối ưu.

The PyTorch Foundation named 24 ambassadors for its 2026 cohort, spanning five regions including Africa, Asia, Europe, the Middle East, and North America. Ambassadors come from countries like Nigeria, Singapore, India, Romania, Spain, the UK, and the US. They support the Foundation's open source ecosystem, which includes PyTorch, vLLM, DeepSpeed, Ray, Helion, and Safetensors. Their work includes workshops, mentorship, documentation, and community events to help developers adopt and contribute to these projects.
Learn how to benchmark local LLMs with Red Hat AI Inference and Red Hat Enterprise Linux by deploying vLLM and testing performance on your hardware.

ZenteiQ uses GKE Inference Gateway and llm-d to boost multi-model inference throughput 4x and keep foundation model pre-training runs on schedule.

Your GPUs spend part of every request re-reading context they already processed. We moved the KV cache to Valkey, and the same two GPU nodes served 25% more requests with replies streaming twice as fast.

At GTC Berlin, NVIDIA is highlighting secure, local systems across RTX Spark, DGX Spark and DGX Station systems to accelerate coding, engineering, robotics and AI factory development.

Nebius has joined the PyTorch Foundation as a Platinum member. The AI cloud company has long supported vLLM with compute for development, testing and benchmarking, including multi-node work on models like DeepSeek R1. As a Platinum member, Nebius plans to contribute to PyTorch and vLLM performance on the latest hardware and gets one seat on the Governing Board. Ryan Hanrui Wang, Nebius's SVP of Applied AI, joins the board and will represent Nebius on the Technical Advisory Council.

The PyTorch Foundation added nine new members at PyTorch Conference North America 2026. Platinum members are Nebius, Nscale, and Shopify; Silver members are LightSeek Foundation and Lablup Inc.; Associate members include SKOPOS INDIA FOUNDATION, Siksha 'O' Anusandhan, Messiah University, and Valencia College. A related case study says Shopify built a continual learning loop with PyTorch and vLLM that cuts serving costs by 96% while beating frontier-model quality. IBM's Spyre accelerator work reduced Spyre-specific compiler code by 7x while keeping performance parity on tested workloads, using about 10,000 lines of code and 44 adapters.

Announcing native PyTorch backends for vLLM and SGLang on Google Cloud TPUs, powered by TorchTPU and TPU Sync for high-performance inference.

Bối cảnh: TorchTPU vừa được mã nguồn mở trên GitHub, cho phép lập trình viên train, serve và deploy models trên TPUs. Nguyên nhân kỹ thuật: TorchTPU là giải pháp kết hợp PyTorch với TPU của Google, giúp tận dụng sức mạnh xử lý của Tensor Processing Units cho deep learning. Hệ quả: Người dùng có thể tận dụng hạ tầng TPU của Google với công cụ họ đã quen thuộc, giảm thời gian training lên đến 3x so với GPU. Điều đáng học: Đây là bước tiến quan trọng giúp PyTorch tiếp cận được thế phần cứng chuyên biệt, cạnh tranh với TensorFlow trong việc tối ưu hóa trên TPU.
TorchTPU là giải pháp giúp lập trình viên tận dụng TPUs với công cụ PyTorch đã quen thuộc.

LLM-D 1.0 là một stack mã nguồn mở, được thiết kế đặc biệt cho inference phân trên Kubernetes. Nó tối ưu hiệu suất bằng cache-aware routing và tiered KV cache, đồng thời hỗ trợ multi-tenant traffic control để quản lý truy cập cho nhiều người dùng. Giải pháp này đạt sẵn sàng cao (high availability) khi triển khai trên Google Kubernetes Engine. Đáng học hỏi cách thiết kế hệ thống phân tán cân bằng giữa hiệu suất KV cache và quản lý tài nguyên đa tenant.
llm-d 1.0 giúp lập trình viên triển khai hiệu quả mô hình ngôn ngữ lớn trên Kubernetes với cache thông minh và khả năng năng cao.
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
Cổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trình1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíAI IDE 22 MB cho dev Việt.
Tải miễn phíBộ nhớ tổ chức cho AI agent.
Khám pháAI trực Fanpage, tự sàng lọc lead.
Dùng thử