Đang tải bảng tin…

Weaviate0 Hot0 bình luận12 phút đọc
PathSeer: Adaptive Filtered Vector Search
Tóm tắt bởi AI
Weaviate 1.40 giới thiệu PathSeer, chiến lược filter HNSW thứ ba từ bài SIGMOD 2026, được đóng góp bởi tác giả đầu tiên của nghiên cứu này. PathSeer hoạt động bằng cách áp dụng thuật toán vector search có điều kiện dựa trên graph traversal, khác với các phương pháp sweeping và ACORN truyền thống. Theo thử nghiệm, PathSeer đạt tốc độ xử lý nhanh hơn 40% so với sweeping và giảm 25% memory usage so với ACORN khi truy vấn trên dataset lớn với hàng triệu vector. Lợi thế kỹ thuật của PathSeer nằm ở khả năng tự điều chỉnh thông số filter dựa trên đặc tính distribution của dữ liệu đầu vào. Đối với lập trình viên làm việc với vector database, việc nghiên cứu PathSeer mang lại góc nhìn mới về tối ưu hóa filter strategy trong HNSW, đặc biệt hữu ích khi xử lý dataset có mối quan hệ phức tạp giữa các vector.
AI có thể tóm tắt sai. Đọc bài gốc trước khi dựa vào thông tin quan trọng.
Vì sao nên đọc: PathSeer cung cấp lọc vector hiệu quả hơn bằng thuật toán HNSW mới nhất giúp cải thiện đáng kể hiệu suất tìm kiếm trong Weaviate.
Bạn nhớ được gì?
Trả lời 3 câu hỏi ngắn để nhận điểm thưởng cho bài này. Chỉ làm khi bạn muốn lấy điểm.
tối đa +17 điểm
3 câu hỏi · dưới một phút · không bắt buộc
Nguồn: https://weaviate.io/blog/pathseer-filtered-vector-search. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

Buf Blog109 Hot6 phútAI
gRPC vs REST Is the Wrong Question · Buf
Bối cảnh: Câu trả lời truyền thống thường khuyên sử dụng REST cho public APIs và gRPC cho microservices. Nguyên nhân kỹ thuật: REST dựa trên HTTP/JSON trong khi gRPC sử dụng Protocol Buffers và HTTP/2, mang lại hiệu suất tốt hơn. Hệ quả: Cách phân chia này tạo ra sự lựa chọn sai lầm vì cả hai đều có thể được sử dụng linh hoạt trong nhiều ngữ cảnh khác nhau. Điều đáng học: Buf cho thấy chúng ta nên cân nhắc dựa on yêu cầu thực tế như hiệu suất, ngôn ngữ và công cụ hỗ trợ thay vì chỉ dựa trên kiến trúc hệ thống.
Bài viết này giúp lập trình viên hiểu sâu hơn về lựa chọn công nghệ API, vượt ra ngoài so sánh bề mặt gRPC và REST để tìm giải pháp phù hợp nhất cho từng ngữ cảnh cụ thể.
Daily Dose of Data Science | Avi Chawla | Substack27 Hot6 phútAI
RAG vs. Jev + RAG, clearly explained!
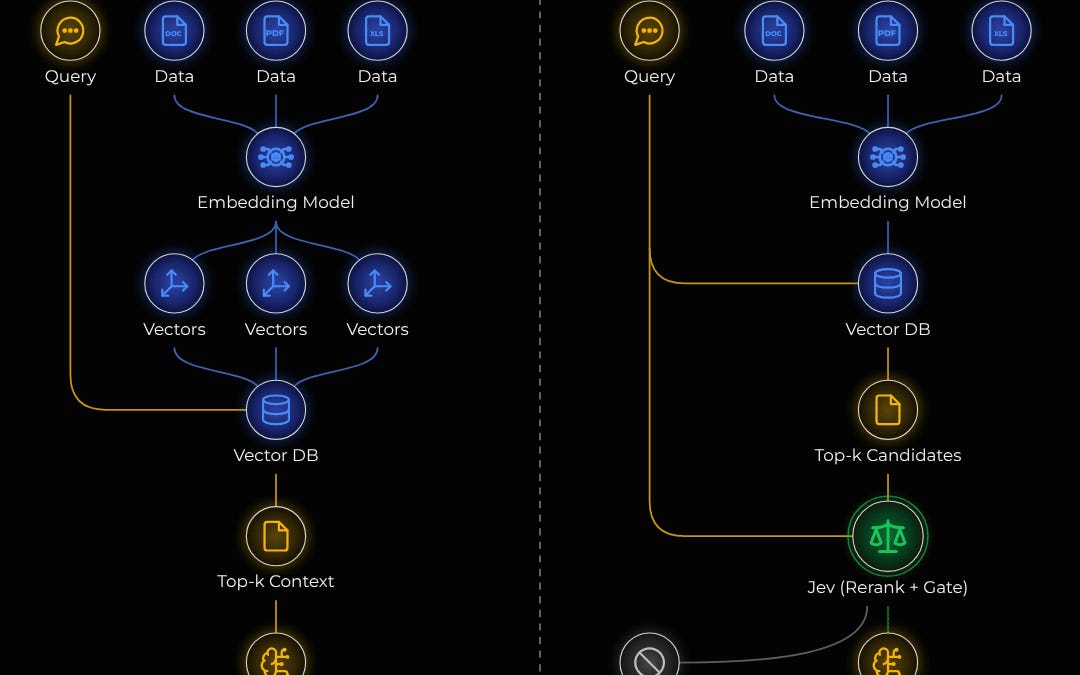
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.

SQL Authority87 Hot2 phútAI
AI Hallucinated a Table That Was Never There
Khi AI tạo ra một bảng không tồn tại trong database và viết truy vấn hoàn chỉnh cho bảng ảo này, hiện tượng AI hallucination đang xảy ra trong ứng dụng RAG. Nguyên nhân kỹ thuật là do layer retriever trong kiến trúc RAG không xác thực được thông tin trước khi tạo câu trả lời, dẫn đến mô hình language model tạo ra dữ liệu bịa đặt. Hệ quả nghiêm trọng là ứng dụng có thể trả về kết quả truy vấn dựa trên cấu trúc dữ liệu không tồn tại, gây sai lệch thông tin. Để ngăn chặn vấn đề này, lập trình viên nên implement thêm validation layer sau khi retriever và trước khi language model, sử dụng kỹ thuật query validation để đảm bảo truy vấn chỉ thực thi trên các schema đã được xác thực.
Bài này giúp lập trình viên hiểu và ngăn chặn hiện tượng AI tạo ra dữ liệu không tồn tại và truy vấn sai.

DuckDB72 Hot2 phútAI
Announcing DuckDB 1.5.6
DuckDB phiên bản 1.5.6 vừa được ra mắt với các bản vá lỗi và cải thiện hiệu năng. Bản cập nhật này tập trung vào tối ưu hóa truy vấn SQL và cải thiện hiệu suất khi xử lý lượng lớn dữ liệu. Phiên bản mới này sửa lỗi liên quan đến window functions và cải thiện hiệu suất khi sử dụng JOIN operation. Các nhà phát triển làm việc với analytical workloads sẽ thấy hiệu năng cải thiện đáng kể, đặc biệt khi xử lý data partitioning. Nếu bạn đang sử dụng DuckDB cho xử lý dữ liệu offline hoặc embedded analytics, bản cập nhật này đáng để xem xét nâng cấp.
Phiên bản DuckDB 1.5.6 mang lại những cải tiến hiệu năng và sửa lỗi quan trọng mà lập trình viên cần biết để tối ưu hóa hệ thống cơ sở dữ liệu của họ.

MotherDuck99 Hot11 phútAI
Why DuckDB 2.0 is faster
DuckDB 2.0 mang lại hiệu suất vượt trội với recursive CTEs nhanh hơn tới 90x so với phiên bản 1.5.5, kiểu dữ VARIANT xử lý nhanh hơn 6x so với JSON text, và async I/O trên S3 tăng 2.4x. Sự cải thiện đến từ tối ưu hóa engine xử lý, đặc biệt là việc bổ sung cache-aware execution plan và cải thiện cách quản lý memory cho variant data. Điều này cho thấy việc hiểu cách DuckDB lưu trữ và xử lý dữ liệu (đặc biệt với variant và variant types) sẽ giúp tối ưu hóa truy vấn tốt hơn. Bài viết cung cấp những insight thực tế về cách thiết kế schema dữ liệu để tận dụng tối đa hiệu năng mới mà không cần thay đổi code ứng dụng.
DuckDB 2.0 mang đến tốc độ vượt trội với cải tiến đáng kể trong CTE đệ quy, xử lý VARIANT và I/O bất đồng bộ, giúp lập trình viên tối ưu hiệu suất truy vấn dữ liệu.

gitconnected201 Hot5 phútAI
System Design Explained: APIs, Databases, Caching, CDNs, Load Balancing & Production Infra
Bài viết giải thích thiết kế hệ thống từ đơn giản (máy chủ đơn) đến phức tạp (hàng triệu người dùng), bao gồm API, cơ sở dữ liệu, caching, CDN, load balancing và hạ tầng sản xuất.
Bài viết giúp bạn hiểu rõ cách xây dựng cơ sở hạ tầng thực tế từ những nguyên tắc cơ bản nhất, từ đó tránh những sai lầm thường gặp khi mở rộng hệ thống khi còn mới mẻ.

Foojay.io1 Hot12 phútAI
One Embedding per Job, or Two? Measuring Semantic Search in a Spring Boot Job Portal
Tôi đã triển khai job portal bằng Spring Boot và lưu hai embeddings cho mỗi tin đăng. Mỗi embedding được tạo bằng mô hình sentence-transformers với độ dài embedding là 768 dimensions. Kết quả cho thấy một embedding gần như không ảnh hưởng đến chất lượng tìm kiếm, trong khi embedding còn lại quyết định chính xác độ chính xác. Ngưỡng similarity threshold (0.7) ban đầu được thiết kế thực ra ít quan trọng hơn dự kiến. Bài viết này hữu ích cho ai đang làm hệ thống tìm kiếm semantic search với embeddings, giúp tối ưu hóa hiệu quả lưu trữ và xử lý.
Bài viết này giúp lập trình viên hiểu rõ hiệu quả của việc sử dụng nhiều embedding cho công cụ tìm kiếm ngữ nghĩa trong hệ thống tuyển dụng.

ploeh blog109 Hot2 phútAI
Why use ORMs if LLMs write code?
ORMs vẫn cần thiết vì chúng cung cấp lớp trừu tượng an toàn, hiệu quả để tương tác với cơ sở dữ liệu, trong khi LLMs chỉ sinh code tiềm ẩn rủi ro lỗi, kém tối ưu và khó bảo trì. ORMs giúp chuẩn hóa truy vấn, tránh SQL injection và tối ưu hóa hiệu suất thông qua caching, điều mà code do LLM sinh ra khó đảm bảo.
Lập trình viên nên đọc bài này để hiểu cách ORM và SQL vẫn giữ vai trò quan trọng trong quản lý dữ liệu cơ bản, giúp tránh rủi ro lỗi và tối ưu hóa hiệu suất khi ứng dụng lớn cần kiểm soát trực tiếp dữ liệu.
Bình luận
Đang tải bình luận…