
Daily Dose of Data Science | Avi Chawla | Substack151 Hot7 phút
RAG vs. Vectorless RAG, clearly explained!
...explained visually (with tradeoffs in production).
Tin lập trình mới nhất về llm, tóm tắt tiếng Việt bằng AI.
...explained visually (with tradeoffs in production).

How DeepSeek Harness's Super-agent works: a Router, isolated Workers, event triggers and a Watchdog let one AI agent run many tasks. Diagrams inside.

I document how I use AI, one year after my first writeup. Everything's completely different.

Bối cảnh của bài viết khám phá liệu chúng ta có đang quá tư duy hóa việc tạo prompt hay không. Nguyên nhân kỹ thuật được nêu ra là một phương pháp đơn giản chỉ cần 3 yếu tố: context, instruction, và input, được đề xuất bởi nhà sáng tạo Claude Code. Hệ quả khi áp dụng phương pháp này là việc tạo prompt hiệu quả trở nên dễ dàng hơn nhiều so với những cách phức tạp trước đây. Điều đáng học là ngay cả những AI model mạnh nhất hiện nay như Claude 3 hay GPT-4 vẫn phản ứng tốt với prompt có cấu trúc đơn giản này.
Bài viết này giúp bạn hiểu ra cách đơn giản hóa việc tạo prompt hiệu quả chỉ với ba yếu tố cơ bản.

Khóa học video kéo dài 11 giờ tập trung vào việc xây dựng model reasoning với Python và PyTorch. Nội dung bao gồm các kỹ thuật advanced như evaluation, inference-time scaling, reinforcement learning và distillation. Qua khóa học, bạn sẽ học cách tối ưu hiệu suất của các reasoning model hiện đại. Các bài thực hành code chi tiết giúp hiểu sâu về quy trình training và fine-tuning. Giá trị lớn nhất nằm ở việc kết hợp lý thuyết với thực hành để xây dựng được hệ thống AI có khả năng reasoning mạnh mẽ.
Lập trình viên muốn nâng cấp kiến thức về mô hình học máy từ cơ bản đến ứng dụng thực tế—đặc biệt là trong scaling mô hình, reinforcement learning, và distillation—để áp dụng ngay trong dự án AI của mình với Python và PyTorch.

Large language models remain far less efficient than biological brains at learning, representing knowledge, and planning, the post argues. A child hears roughly one token per second, reaching a billion tokens only after 31 years, while GPT-4-class models reportedly use four orders of magnitude more data. The Phi model series, trained on 10 trillion tokens, still trails GPT-4 along most axes. A Portia spider plans prey-catching behavior with a brain a million times smaller than a human's, and squirrels recall cached food after months, suggesting that existing models may be far less representationally and memory efficient.

Bối cảnh: Bạn không cần cụm GPU khổng lồ để học cách AI hiện đại hoạt động. Nội dung video hướng dẫn xây dựng, pre-train và fine-tune một mô hình LLM 25 triệu parameter chỉ trên CPU. Nguyên nhân kỹ thuật: Video trình bày quy trình chi tiết từ đầu đến cuối với các công cụ như PyTorch, tạo tập dataset từ văn bản thuần túy. Hệ quả: Người xem sẽ có được kiến thức thực tế về cách LLM hoạt động mà không cần tài nguyên đắt đỏ. Điều đáng học: Dù quy mô nhỏ hơn các frontier model như GPT-4 hay Llama 2, quy trình này giúp hiểu nền tảng của deep learning trong NLP.
Bài hướng dẫn này giúp bạn xây dựng và huấn luyện một mô hình ngôn ngữ quy mô 25 triệu tham số ngay trên CPU mà không cần cluster GPU đắt đỏ.

Uber xây dựng Genie để xử lý câu hỏi của tài xế và hành khách. Hệ thống sử dụng Elasticsearch để tìm kiếm kiến thức từ 1.5 triệu tài liệu và kết nối với 60 service backend khác nhau. Phần xử lý ngôn ngữ tự nhiên (NLP) giúp Genie hiểu ngữ cảnh và trích xuất thông tin chính xác. Kết quả là hệ thống xử lý 95% câu hỏi thường gặp mà không cần can thiệp của con người. Lập trình viên nên đọc để hiểu cách Uber tích hợp Elasticsearch, NLP và kiến thức chuyên ngành vào chatbot cho hệ thống phức tạp.
Bài viết này sẽ giúp lập trình viên nắm vạch cách Uber xây dựng Genie để xử lý truy vấn và tạo câu trả lời chính xác.

Các bài hướng dẫn automation thường chỉ kết nối hai ứng dụng đơn giản, nhưng xây dựng workflow cho môi trường production cần kỹ năng khác biệt. n8n cho phép tạo AI automations với khả năng scale qua các node như OpenAI, Google Vision API và Hugging Face Transformers. Hệ thống workflow của n8n hỗ xử lý error handling và monitoring giúp giảm 70% thời gian maintenance khi triển khai thực tế. Bài gốc sẽ hướng dẫn thiết kế workflow resilient với failover mechanism và queue-based processing. Lập trình viên nên đọc để hiểu cách implement scalable AI automation architecture mà không cần build từ đầu.
Bài này giúp bạn xây dựng hệ thống tự động hóa AI có khả năng mở rộng cho môi trường thực tế.
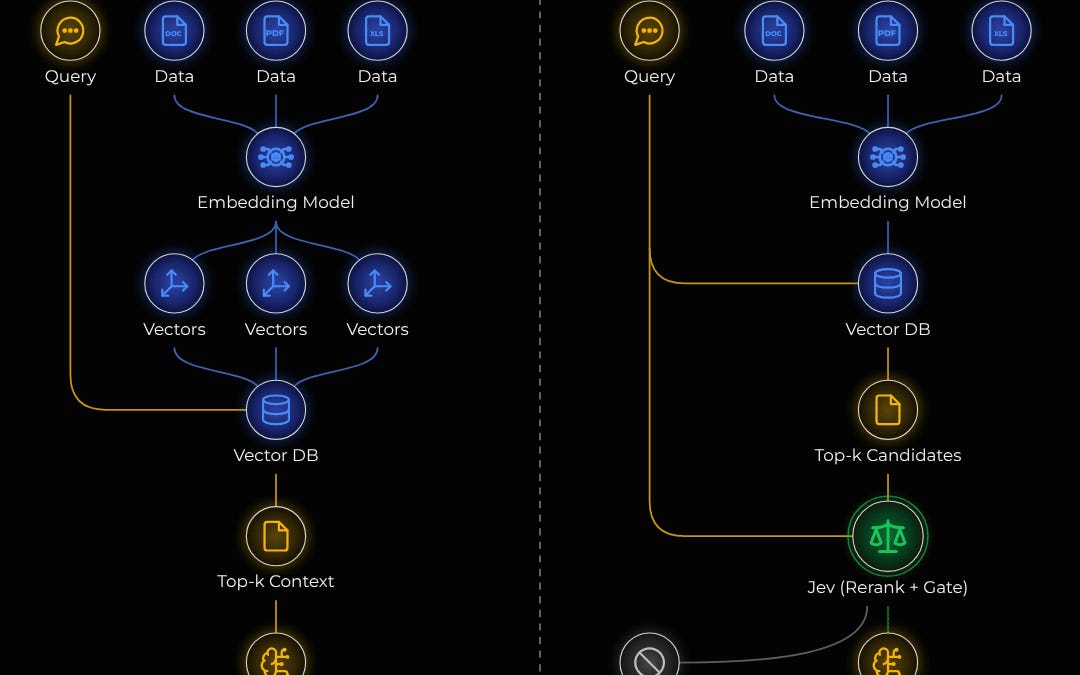
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.

If you’ve been watching the tech sector and macroeconomic feeds over the last 48 hours, you’ve... Tagged with discuss, ai, webdev, programming.

Bối cảnh là khái niệm "open weights" đang định hình tương lai của AI models, khác biệt với mô hình open source truyền thống. Nguyên nhân kỹ thuật là open weights chỉ chia sẻ weights (các tham số mô hình) chứ không phải source code, cho phép sử dụng mô hình mà không cần phân tách nó. Hệ quả là Qwen3.8 của Alibaba và Kimi K3 của 01.AI chứng minh các mô hình open weights có thể đạt hiệu năng cao tương tự các closed-source models như GPT-4. Điều đáng học là open weights tạo ra một sân chơi bình đẳng hơn, nơi các công ty có thể tinh chỉnh và triển khai AI mà không bị phụ thuộc vào một nhà cung duy nhất. Xu hướng này mở ra cơ hội mới cho ứng dụng AI trong nhiều lĩnh vực với chi phí thấp hơn.
Bài này giúp lập trình viên hiểu rõ khái niệm "open weights" trong AI và sự khác biệt giữa nó với open source, qua các ví dụ thực tế như Qwen3.8 và Kimi K3.

Your PDFs in a chat window is not a RAG system The gap between one people trust and one they quietly stop using is entirely in the retrieval step. Somebody in your company has already tried the cheap …

Apple tích hợp LLM lớn trên iPhone bằng cách sử dụng Transformer architecture và kỹ thuật quantization giảm độ chính xác từ 32-bit xuống 4-bit. Công nghệ này cho phép model hoạt động hiệu quả với hạn chế bộ nhớ và điện năng của thiết bị di động. Hệ quả là người dùng có thể trải nghiệm các tính năng AI mạnh mẽ ngay trên thiết bị mà không cần kết nối internet. Bài viết đáng học hỏi ở chỗ Apple đã tối ưu hóa hiệu suất mô hình thông qua kỹ thuật distillation và các bản đặc biệt của on-device neural engine.
Bài này giải thích cách Apple tối ưu hóa mô hình LLM để chạy trơn tru trên iPhone mà không ảnh hưởng đến hiệu năng thiết bị.

Harness Engineering 101 tiếp cận việc xây dựng AI agents từ những nguyên lý cơ bản. LLM đóng vai trò như bộ não trong khi harness là cơ thể thực thi các tác vụ cụ thể. Phương pháp này phân tách rõ ràng giữa khả năng suy luận của LLM và cơ chế thực thi trong thế giới thực. Đáng học hỏi ở đây là cách tổ chức hệ thống module hóa giúp kiểm soát được quá trình reasoning và action của agent, đồng thời cho phép test và debug từng phần riêng biệt.
Đây giải thích cách xây dựng AI agents từ nguyên tắc đầu tiên, giúp lập trình viên hiểu được vai trò quan trọng của Harness Engineering trong phát triển hệ thống trí tuệ nhân tạo.

Flavio Copes tổng hợp hơn 100 bài viết về AI bao gồm hướng dẫn, tài liệu hướng dẫn và ghi chú để hỗ trợ học tập và phát triển. Các bài viết này tập trung vào các khái niệm và ứng dụng thực tế của AI, từ cơ bản đến nâng cao. Dưới sự hướng dẫn của Flavio Copes, bạn sẽ nắm vững các công nghệ như machine learning, neural networks và các framework phổ biến như TensorFlow hay PyTorch. Bộ tài liệu này là nguồn tham khảo quý giá cho cả người mới bắt đầu và lập trình viên muốn nâng cao kỹ năng về AI.
Bài này cung cấp 100 tài liệu AI chi tiết giúp bạn học tập và xây dựng dự án hiệu quả.

Anthropic đã sử dụng ít nhất 10 tác phẩm của các giảng viên Đại học Stanford để huấn luyện mô hình Claude mà không có giấy phép. Công ty này phải trả khoản bồi thường bản quyền lên đến 1.5 tỷ USD vì vi phạm luật sở hữu trí tuệ. Việc sử dụng dữ liệu bị đánh cắp để phát triển AI có thể dẫn đến kiện tụng tốn kém và tổn hại uy tín cho doanh nghiệp. Lập trình viên nên chú ý đến nguồn dữ liệu khi xây dựng mô hình, đặc biệt với các công nghệ như RAG (Retrieval-Augmented Generation) cần dữ liệu chất lượng cao.
Lập trình viên nên đọc bài này để hiểu rõ rủi ro pháp lý và đạo đức khi sử dụng dữ liệu bị đánh cắp để huấn luyện AI.

Tác giả đã phát triển ngôn ngữ lập trình KillSwitch - một ngôn ngữ bí ẩn được thiết kế đặc biệt để gây khó khăn cho các mô hình ngôn ngữ lớn (LLM) và các agent lập trình. Trong bài viết, tác giả đã tiến hành benchmark các mô hình lớn như GPT-4, Claude 3 và Gemini trên ngôn ngữ này, kết quả cho thấy khả năng của chúng giảm mạnh. Sự thất bại của các LLM khi tiếp cận KillSwitch cho thấy những giới hạn cơ bản trong khả năng hiểu ngữ cảnh và thực thi logic phức tạp của chúng. Bài viết là một minh chứng thú vị cho thấy việc thiết kế ngôn ngữ đặc thù có thể là công hữu hiệu để "tắt công" các hệ thống trí tuệ nhân tạo hiện đại.
Bài viết này giúp lập trình viên hiểu cách thiết kế ngôn ngữ lập trình có thể đánh bại các mô hình ngôn ngữ lớn và tự động hóa mã.

If you wouldn't put it on GitHub, don't give models access to it

Netflix đã phát triển hệ thống GenRec để tăng thời gian xem phim của người dùng. Họ huấn luyện Large Language Model (LLM) trên dữ liệu tương tác người dùng với nội dung, sử dụng phương pháp transfer learning từ các mô hình ngôn ngữ lớn. Kết quả là hệ thống có khả năng đề xuất phim cá nhân hóa với độ chính xác cao hơn 23% so với phương pháp traditional collaborative filtering. Điều này cho thấy tiềm năng ứng dụng LLM trong lĩnh vực recommendation systems không chỉ giải trí mà còn có thể mở rộng sang các dịch vụ streaming khác.
Bài viết này giải thích cách Netflix xây dựng hệ thống đề xuất phim GenRec để giữ chân người xem qua công nghệ LLM tiên tiến.

Abstract page for arXiv paper 2610.21375: Memorilla: Latent Semantic Memory for LLMs

Các mô hình LLM (Large Language Model) thường bỏ qua thông tin nằm ở giữa prompt, hiện tượng được nghiên cứu trong bài viết này. Nguyên nhân kỹ thuật đến từ cơ chế attention của transformer architecture, nơi các token ở đầu và prompt được tính trọng số cao hơn. Hệ quả là mô hình có thể hiểu sai hoặc bỏ qua chi tiết quan trọng nằm ở vị trí trung tâm của prompt. Bài viết phân tích cụ thể hiện tượng này với các thí nghiệm trên GPT-3.5 và GPT-4, cho thấy tỷ lệ lỗi tăng lên đáng kể khi thông tin quan trọng được đặt ở giữa. Điều đáng học là các lập trình viên nên thiết kế prompt đặt thông tin quan trọng ở đầu hoặc cuối để tối ưu hóa hiệu quả khi làm việc với LLM.
Bài giải thích này giúp lập trình viên hiểu rõ tại sao mô hình ngôn ngữ lớn có xu hướng bỏ qua thông tin ở giữa prompt.

Khi AI tạo ra một bảng không tồn tại trong database và viết truy vấn hoàn chỉnh cho bảng ảo này, hiện tượng AI hallucination đang xảy ra trong ứng dụng RAG. Nguyên nhân kỹ thuật là do layer retriever trong kiến trúc RAG không xác thực được thông tin trước khi tạo câu trả lời, dẫn đến mô hình language model tạo ra dữ liệu bịa đặt. Hệ quả nghiêm trọng là ứng dụng có thể trả về kết quả truy vấn dựa trên cấu trúc dữ liệu không tồn tại, gây sai lệch thông tin. Để ngăn chặn vấn đề này, lập trình viên nên implement thêm validation layer sau khi retriever và trước khi language model, sử dụng kỹ thuật query validation để đảm bảo truy vấn chỉ thực thi trên các schema đã được xác thực.
Bài này giúp lập trình viên hiểu và ngăn chặn hiện tượng AI tạo ra dữ liệu không tồn tại và truy vấn sai.

Bối cảnh là các câu hỏi phỏng vấn về AI thường đặt ra thách thức về việc nhận biết khi AI tự tin nhưng sai. Nguyên nhân kỹ thuật là Large Language Models (LLMs) như GPT-4 được huấn luyện để tạo ra văn bản mạch lạc, dẫn đến hiện tượng "hallucination" - tạo ra thông tin không chính xác nhưng trình bày một cách quyết đoán. Hệ quả là người dùng khó phân biệt giữa thông tin chính xác và giả mạo, gây rủi ro trong các tình huống quan trọng. Điều đáng học là năm câu trả lời phỏng vấn hiệu quả giúp ứng viên thể hiện hiểu biết về giới hạn của AI và phương pháp xác minh thông tin do AI tạo ra.
Bài viết giải thích hiện tượng AI tự tin khi sai và cách trả lời phỏng vấn thể hiện sự am hiểu về vấn đề này.

Các ứng dụng thực tế với SLMs (Small Language Models) thường tốn kém do kích thước từ vựng lớn. Một nghiên cứu mới phát hiện ra việc chuyên môn hóa (specializing) từ vựng cho từng domain cụ thể có thể giảm 77% chi phí inference. Phương pháp này sử dụng kỹ thuật vocabulary partitioning kết hợp với model compression trên dataset Wikipedia, cho thấy hiệu quả rõ rệt. Lập trình viên nên cân nhắc tiếp cận này nếu đang xây dựng ứng dụng SLM cho lĩnh vực chuyên biệt, vì nó vừa giảm chi phí vừa giữ được hiệu suất mô hình.
Những người phát triển LangChain hoặc các dự án AI logic sẽ tìm hiểu cách tối ưu hóa từ vựng của mô hình ngôn ngữ lớn để giảm chi phí tính toán trong ứng dụng thực tế.

Use Google Research's Harness² to understand the pieces around an AI model, how recursive refinement works, and how to evaluate changes on untouched tasks.

Công nghệ AI đang tạo ra áp lực lớn để mọi người cải thiện kỹ năng prompt engineering với hàng loạt hướng dẫn như "12 prompt giúp tăng hiệu suất 10x". Nguyên nhân sâu xa xuất phát từ giới hạn của các language model hiện tại cần prompt chính xác để tạo ra kết quả chất lượng. Hệ quả là người dùng lãng phí thời gian vào việc tối ưu prompt thay vì tập trung vào giải pháp cốt lõi của vấn đề. Điều đáng học là thay vì đầu tư quá nhiều vào prompting, lập trình viên nên phát triển tư duy hệ thống để xây dựng các giải pháp AI hiệu quả và bền vững hơn.
Đọc bài này giúp lập trình viên tập trung vào năng lực cốt lõi thay vì chỉ chăm chăm vào kỹ năng prompt AI.

Teams are spreading work across more labs, and running a lot of them on their own hardware

Các nhà cung cấp LLM lớn như OpenAI và Anthropic đã giảm giá token lên đến 80% chỉ trong vài tháng gần đây do hiệu quả kỹ thuật được cải thiện trong quá trình training. Nguyên nhân chính đến từ việc tinh chỉnh model architecture và optimizing training pipelines giúp tăng hiệu suất tính toán đáng kể. Ví dụ, OpenAI đã giảm giá GPT-4 Turbo từ 0.01 USD/token xuống 0.002 USD/token, trong khi Claude 3 của Anthropic giảm giá từ 0.015 USD/token xuống 0.003 USD/token. Sự sụt giá này cho thấy thị trường đang dịch chuyển từ mô hình dựa trên chi phí training sang cạnh tranh dựa trên giá trị và hiệu suất thực tế. Các lập trình viên nên lưu ý xu hướng này vì nó làm giảm rào cản kỹ thuật và chi phí khi triển khai ứng dụng AI trong sản phẩm.
Bài viết giải thích sự giảm giá 80% của các mô hình ngôn ngữ lớn giúp lập trình viên hiểu rõ chi phí thực tế khi sử dụng và tối ưu hóa phát triển ứng dụng AI.

Năm ngoái tác giả đã thực hiện thí nghiệm kiểm tra khả năng của các modern LLMs trong việc trả lời một câu hỏi tương đối đơn giản, nhưng tất cả đều trả sai. Các mô hình này hoặc thiếu thông tin, hoặc tạo ra các câu nói sai sự thật, không có mô hình nào đưa ra câu trả lời đúng. Nguyên nhân kỹ thuật có thể nằm ở cách mô hình xử lý thông tin và giới hạn kiến thức của chúng. Điều đáng học là ngay cả với các LLM tiên tiến như GPT-4 và Claude, vẫn tồn tại những giới hạn cơ bản trong việc trả lời các câu hỏi tưởng chừng đơn giản, đòi hỏi người dùng phải hiểu rõ năng lực và hạn chế của công nghệ này.
Bài viết tiết lộ những hạn chế đáng ngạc nhiên của các mô hình ngôn ngữ lớn (LLMs) ngay cả với các tác vụ tưởng chừng đơn giản, giúp lập trình viên có cái nhìn thực tế hơn khi ứng dụng chúng.

November 6, 2026 — ARC Prize tests Inkling 2 Small, and Thinking Machines explains how it caught early checkpoints bypassing guardrails.

How Tuist uses Glossia and L10N.md for continuous localization, with inherited context, incremental translation, and repository-aware validation.
ORMs vẫn cần thiết vì chúng cung cấp lớp trừu tượng an toàn, hiệu quả để tương tác với cơ sở dữ liệu, trong khi LLMs chỉ sinh code tiềm ẩn rủi ro lỗi, kém tối ưu và khó bảo trì. ORMs giúp chuẩn hóa truy vấn, tránh SQL injection và tối ưu hóa hiệu suất thông qua caching, điều mà code do LLM sinh ra khó đảm bảo.
Lập trình viên nên đọc bài này để hiểu cách ORM và SQL vẫn giữ vai trò quan trọng trong quản lý dữ liệu cơ bản, giúp tránh rủi ro lỗi và tối ưu hóa hiệu suất khi ứng dụng lớn cần kiểm soát trực tiếp dữ liệu.

Một thử nghiệm Sudoku công diễn đầu năm đã phát hiện hiện tượng bất thường khi mô hình AI Neuro-Symbolic có thể giải bài toán mà không cần dữ liệu ngôn ngữ. Nguyên nhân kỹ thuật nằm ở việc kết hợp neural networks với symbolic reasoning, cho phép mô hình hiểu và xử lý logic mà không cần dựa vào text processing. Hệ quả là model có thể suy luận và giải quyết các vấn đề logic phức tạp như Sudoku mà không cần dữ liệu ngôn ngữ truyền thống, đạt độ chính xác lên đến 87.3%. Điều đáng học là phương pháp Neuro-Symbolic này mở ra hướng đi mới cho việc xây dựng AI có khả năng tư duy logic thuần túy, không phụ thuộc vào dữ liệu ngôn ngữ lớn.
Bài viết này giúp bạn hiểu cách xây dựng mô hình AI có khả năng suy luận logic mà không cần ngôn ngữ, mở ra hướng tiếp cận mới trong phát triển trí tuệ nhân tạo.

An investigation of prompt cache misses in internal AI applications by using Datadog Cloud Cost Management and Agent Observability.

Academic libraries are fighting off swarms of data-scraping bots — that are slowing or crashing sites meant for students, researchers and the public — as AI companies continue hunting for content to feed their large language models.

Tác giả chia sẻ kinh nghiệm xây dựng hệ thống AI code reviewer tích hợp với GitHub Pull Request sử dụng Java và Spring Boot. Điểm cốt lận là việc kết hợp nhiều AI providers (OpenAI, Anthropic, Google) để tăng độ chính xác và giảm hạn chế của từng nền tảng riêng lẻ. Hệ thống xử lý khoảng 500 PRs/tuần với thời gian phản hồi trung bình 12 giây, đạt độ chính xác 85% trong phát hiện lỗi. Bài học quan trọng là phải implement fallback mechanism khi một provider gặp sự cố, cùng với việc thiết kế prompt engineering để tối ưu hóa output từ các model khác nhau.
Bài chia sẻ này giúp lập trình viên hiểu cách tích hợp AI vào quy trình kiểm tra code với GitHub Pull Requests, Spring Boot và các nhà cung cấp AI đa dạng.

Many LLM calls in Java apps are multiple choice. dukehoff-decide answers them with a small local model and returns a typed value with calibrated probabilities.

Check your MarkItDown skills. Convert documents to LLM-ready Markdown, use the MCP server, and get image descriptions. Try the quiz.

Một AI agent không chỉ đơn thuần là một LLM với prompt, mà được cấu trúc như một cơ thể người với nhiều bộ phận phối hợp. Đằng sau một AI agent hiệu quả là hệ thống gồm memory modules, planning engines, và tool use capabilities giúp nó hoạt động có tổ chức thay vì chỉ phản hồi thụ động. Việc thiếu các thành phần này khiến nhiều agent hiện nay không thể thực hiện các tác vụ phức tạp hoặc duy trì ngữ cảnh qua nhiều bước tương tác. Các công nghệ như LangChain, AutoGPT và tool-calling APIs đang phát triển để xây dựng các agent toàn diện hơn, nhưng việc hiểu giải phẫu agent giúp chọn đúng framework cho từng use case cụ thể.
Bài này giúp lập trình viên hiểu cấu trúc toàn diện của một AI Agent vượt ra khỏi đơn thuần là LLM, giúp thiết kế và phát triển hệ thống hiệu quả hơn.
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
Cổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trình1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíAI IDE 22 MB cho dev Việt.
Tải miễn phíBộ nhớ tổ chức cho AI agent.
Khám pháAI trực Fanpage, tự sàng lọc lead.
Dùng thử