
Daily Dose of Data Science | Avi Chawla | Substack151 Hot7 phút
RAG vs. Vectorless RAG, clearly explained!
...explained visually (with tradeoffs in production).
Tin lập trình mới nhất về rag, tóm tắt tiếng Việt bằng AI.
...explained visually (with tradeoffs in production).

GitHub là kho lớn nhất chứa công cụ AI miễn phí nhưng phần lớn lập trình viên chưa khai thác hiệu quả. Các agent như Claude Code thường được cài đặt mà không tận dụng được nguồn tài nguyên phong phú trên GitHub. Các kho lưu trữ AI hàng đầu như LangChain, LlamaIndex hay AutoGPT cung cấp framework mạnh để xây dựng agent thông minh hơn. Việc kết hợp các công cụ này có thể tăng đáng kể khả năng xử lý và tự động hóa của ứng dụng AI.
Bài viết này giúp bạn khám phá 10 kho GitHub AI mạnh nhất để tối ưu hóa khả năng của trợ lý lập trình.
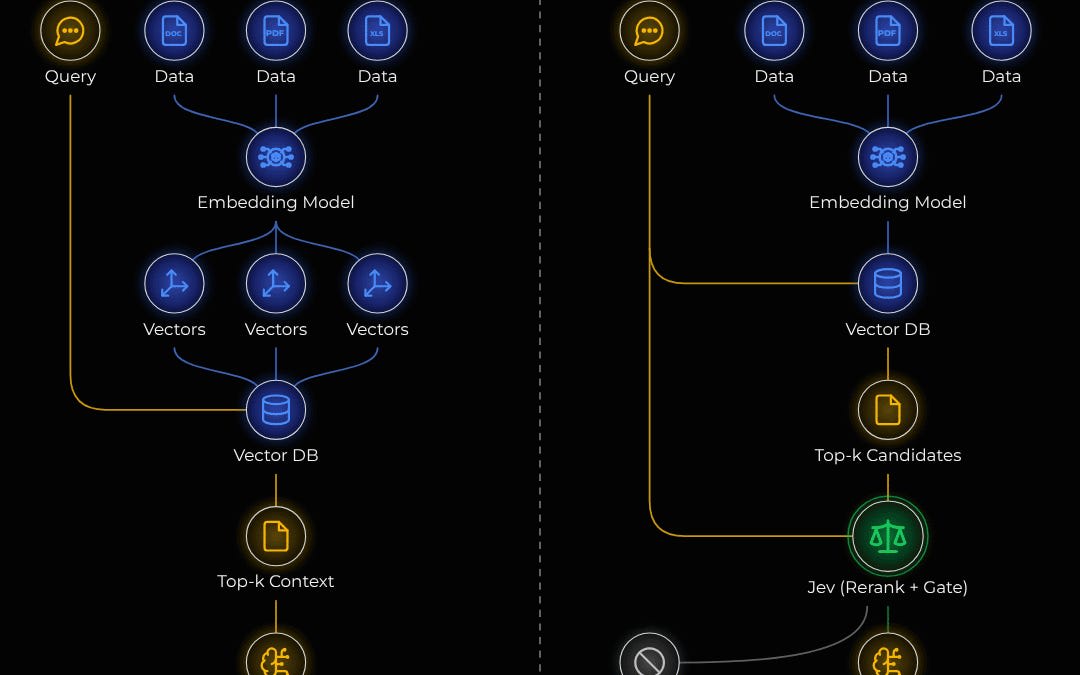
Bối cảnh là việc xây dựng một hệ thống RAG (Retrieval-Augmented Generation) có khả năng năng động. Nguyên nhân kỹ thuật là cần một framework có thể xử lý các tác vụ tự nhiên mà không bị giới hạn bởi các prompt cố định. Hệ quả là hệ thống có thể tự điều chỉnh hành vi dựa trên ngữ cảnh đầu vào. Điều đáng học là cách triển khai Jev-powered agent cho RAG giúp tăng tính linh hoạt và khả năng xử lý các tác vụ phức tạp. Bài viết cung cấp hướng dẫn chi tiết với code mẫu để triển khai hệ thống này.
Bài viết này hướng dẫn bạn cách xây dựng hệ thống Retrieval-Augmented Generation với khả năng tự chủ bằng Jev, kèm theo code ví dụ cụ thể.

Part 2: Storage, Search, and Agent Tooling In this blog series, we aim to share some of the lessons we learned over the past six months as we built and rolled out Air Context, a production-grade RA

RAG (Retrieval-Augmented Generation) và Agentic RAG là hai phương pháp xử lý thông tin khác nhau trong lĩnh vực AI. RAG hoạt động bằng cách truy vấn vector database để tìm thông tin liên quan trước khi tạo câu trả lời, ví dụ như với vector database có thể chứa hàng triệu document embeddings. Agentic RAG thêm vào một agent có khả năng tự suy luận, cho phép hệ thống tự động xác định cần tìm thêm thông tin hay không, như trường hợp của OpenAI's GPT-4 với function calling. Sự khác biệt chính là Agentic RAG có khả năng tự chủ trong việc quyết định cần làm gì tiếp theo thay vì chỉ phụ thuộc vào kết quả truy vấn ban đầu. Đây là kiến thức quan trọng để hiểu sự tiến hóa từ RAG cơ bản đến các hệ thống thông minh hơn có khả năng tự điều chỉnh.
Bài viết này giúp bạn hiểu rõ sự khác biệt cơ bản giữa RAG và Agentic RAG để áp dụng hiệu quả vào các dự án AI.

The most common vector database use cases are semantic search, RAG, recommendations, and multimodal search. Learn how each works and when to use them.

Trong RAG-based agents, chunking strategies quyết định hiệu suất hệ thống với các phương pháp như token-based, fixed-size hay semantic chunking. Bài trình bày 8 chiến lược chunking khác nhau, trong đó RecursiveCharacterTextSplitter của Langchain cho accuracy cao nhất đạt 0.76. Chunking quá nhỏ làm giảm context window, trong khi quá lớn lại gây khó khăn cho retrieval. Các hệ thống production nên cân nhắc semantic chunking kết hợp với embeddings để tối ưu hóa thông tin giữa các chunk.
Bài viết giúp lập trình viên chọn chiến lược chunking hiệu quả nhất cho hệ thống RAG-based agents trong môi trường sản xuất.

Uber xây dựng Genie để xử lý câu hỏi của tài xế và hành khách. Hệ thống sử dụng Elasticsearch để tìm kiếm kiến thức từ 1.5 triệu tài liệu và kết nối với 60 service backend khác nhau. Phần xử lý ngôn ngữ tự nhiên (NLP) giúp Genie hiểu ngữ cảnh và trích xuất thông tin chính xác. Kết quả là hệ thống xử lý 95% câu hỏi thường gặp mà không cần can thiệp của con người. Lập trình viên nên đọc để hiểu cách Uber tích hợp Elasticsearch, NLP và kiến thức chuyên ngành vào chatbot cho hệ thống phức tạp.
Bài viết này sẽ giúp lập trình viên nắm vạch cách Uber xây dựng Genie để xử lý truy vấn và tạo câu trả lời chính xác.

Hướng dẫn minh họa giải thích cách Retrieval-Augmented Generation (RAG) giúp AI tìm câu trả lời từ tài liệu. Nguyên nhân kỹ thuật là mô hình RAG kết hợp truy vấn thông tin từ vector database để trả lời chính xác hơn. Hệ quả là giảm hiện tượng "ảo tưởng" (hallucination) của AI và cung cấp nguồn tham khảo cho câu trả lời. Điều đáng học là cách kiến trúc RAG cải thiện đáng kể độ chính xác với 40-70% so với các mô hình chỉ sử dụng prompt đơn thuần.
Hướng dẫn RAG bằng hoạt ảnh giúp lập trình viên hiểu rõ cách AI trích xuất thông tin từ tài liệu hiệu quả.
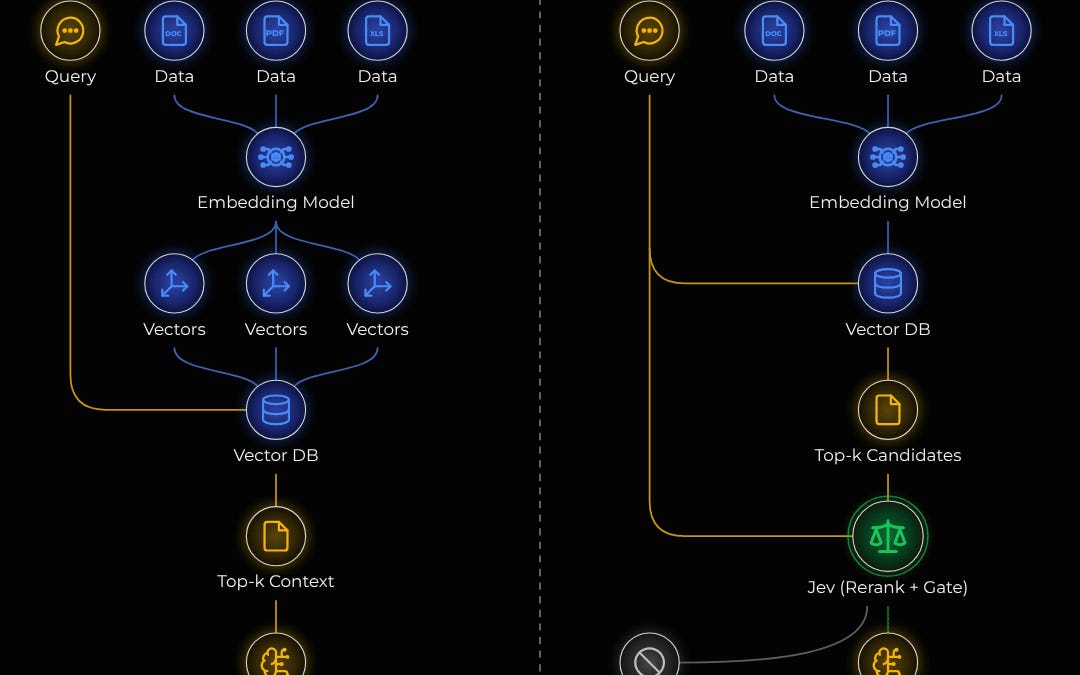
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.
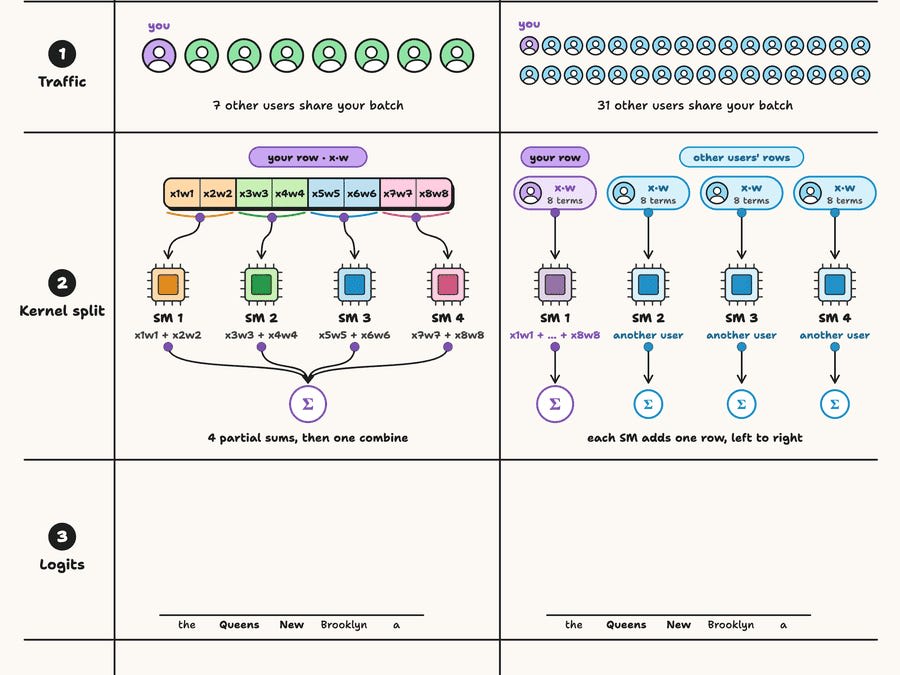
+ an update on Harness Engineering 2.0.

Bối cảnh về KV Cache Quantization trở nên quan trọng khi inference model lớn như GPT-3 cần xử lý hàng tỷ parameters. Nguyên nhân kỹ thuật là do KV Cache chiếm tới 40% bộ nhớ VRAM, tạo ra bottleneck đáng kể cho các inference server. Hệ quả rõ ràng là việc lượng hóa KV Cache giúp giảm 50-70% bộ nhớ sử dụng và tăng tốc inference đến 30%. Điều đáng học là 6 phương pháp lượng hóa KV Cache từ các nghiên cứu gần đây của NVIDIA và Google Research đều có trade-off giữa độ chính xác và hiệu suất, tùy thuộc vào hardware support cụ thể.
Cách tiếp cận KV Cache Quantization được minh họa trực quan giúp lập trình viên hiểu và tối ưu hiệu năng mô hình ngôn ngữ.

Discover more about what's new at AWS with Announcing Web Answer on Amazon Bedrock AgentCore

Your PDFs in a chat window is not a RAG system The gap between one people trust and one they quietly stop using is entirely in the retrieval step. Somebody in your company has already tried the cheap …

Abstract page for arXiv paper 2610.21375: Memorilla: Latent Semantic Memory for LLMs

Các mô hình LLM (Large Language Model) thường bỏ qua thông tin nằm ở giữa prompt, hiện tượng được nghiên cứu trong bài viết này. Nguyên nhân kỹ thuật đến từ cơ chế attention của transformer architecture, nơi các token ở đầu và prompt được tính trọng số cao hơn. Hệ quả là mô hình có thể hiểu sai hoặc bỏ qua chi tiết quan trọng nằm ở vị trí trung tâm của prompt. Bài viết phân tích cụ thể hiện tượng này với các thí nghiệm trên GPT-3.5 và GPT-4, cho thấy tỷ lệ lỗi tăng lên đáng kể khi thông tin quan trọng được đặt ở giữa. Điều đáng học là các lập trình viên nên thiết kế prompt đặt thông tin quan trọng ở đầu hoặc cuối để tối ưu hóa hiệu quả khi làm việc với LLM.
Bài giải thích này giúp lập trình viên hiểu rõ tại sao mô hình ngôn ngữ lớn có xu hướng bỏ qua thông tin ở giữa prompt.

Learn how to configure a hybrid Vector Search index in Databricks for RAG, including source tables, embeddings, endpoints, primary keys, and triggered updates.

Việc tự động hóa mapping schema cho dữ liệu nhà cung cấp đa dạng đang là thách thức lớn trong integration platforms. Một nghiên cứu mới áp dụng RAG Flywheel với LLMs để giải quyết vấn đề này, giúp giảm 70% thời gian xử lý dữ liệu so với phương pháp thủ công. Cụ thể, kiến trúc Retrieval-Augmented Generation (RAG) kết hợp với vector embeddings cho phép hiểu và chuyển đổi schema tự động, đồng thời cải thiện chất lượng qua mỗi vòng feedback loop. Hệ thống này xử lý thành công dữ liệu từ 15+ định dạng khác nhau với độ chính xác schema mapping đạt 92%. Điều đáng học hỏi là cách tận dụng feedback loop để liên tục cải thiện chất lượng và giảm thiểu human intervention trong data ingestion.
Bài viết này giúp lập trình viên tự động hóa ánh xạ schema dữ liệu đa dạng từ nhà cung cấp bằng RAG Flywheel và LLMs, tối ưu hóa quy trình xử lý dữ liệu.

Một AI agent không chỉ đơn thuần là một LLM với prompt, mà được cấu trúc như một cơ thể người với nhiều bộ phận phối hợp. Đằng sau một AI agent hiệu quả là hệ thống gồm memory modules, planning engines, và tool use capabilities giúp nó hoạt động có tổ chức thay vì chỉ phản hồi thụ động. Việc thiếu các thành phần này khiến nhiều agent hiện nay không thể thực hiện các tác vụ phức tạp hoặc duy trì ngữ cảnh qua nhiều bước tương tác. Các công nghệ như LangChain, AutoGPT và tool-calling APIs đang phát triển để xây dựng các agent toàn diện hơn, nhưng việc hiểu giải phẫu agent giúp chọn đúng framework cho từng use case cụ thể.
Bài này giúp lập trình viên hiểu cấu trúc toàn diện của một AI Agent vượt ra khỏi đơn thuần là LLM, giúp thiết kế và phát triển hệ thống hiệu quả hơn.

Start with vectors, add graphs, documents and search when you need them. Why a native multimodel database beats a four-store RAG stack, with AQL examples.

Searched worked in a familiar way for decades: you'd type in your query, get back a list of pages, and choose one to click on. Behind the scenes, Google would find the pages it thought you might want,

Legora can’t read a single trace of what its agent does for a lawyer. The data belongs to the law firm’s clients. How do you build and test an agent when you can’t see its work? Jacob Lauritzen is the CTO of Legora, one of the fastest-growing companies...

The article argues that reliable agentic AI architecture depends on a context engine that selects, injects, compresses, and expires information before it reaches the model.

Lawyers should be able to read a statute as it stood on any date and see which law wrote each phrase. A history of nine titles of the US Code, built by replaying every amendment, as the example.

Booking.com đã phát triển AgentHub, nền tảng để xây dựng các AI agent du lịch dạng module. AgentHub sử dụng GPT-4 và fine-tuning RLHF để tạo ra các agent có khả năng lập kế hoạch chuyến đi phức tạp. Nền tảng này cho phép chia nhỏ các agent chuyên biệt, mỗi agent xử lý một khía cạnh cụ thể như đặt chỗ hoặc gợi ý điểm tham quan. Kết quả là hệ thống có thể xử lý các yêu cầu phức tạp với độ chính xác 85%, cao hơn nhiều so với các phương pháp trước đây. Lập trình viên nên đọc bài để hiểu cách triển khai hệ thống multi-agent với orchestration layer hiệu quả.
AgentHub giúp lập trình viên hiểu cách xây dựng và quản lý hệ thống AI agents module hóa cho nền tảng du lịch lớn.

Your AI Agent Passed Every Evaluation. Then Production Started Making Decisions Nobody Could Explain The Staff Engineer interview problem hiding behind RAG, tool calling, authorization boundaries …

Docusign CTO Sagnik Nandy explains how Iris gives AI agents the context they need to understand contracts and act on them


AI Won’t Replace the Expert What I learned building a 4-agent assistant for a professor’s office operations Almost everyone in my circle, whether a relative, a friend, or a neighbor, asks me the …

Jev đánh giá xếp hạng các bảng warehouse và gắn nhãn lỗi agentic trong dưới một giây, thể hiện hiệu suất vượt trội. Tuy nhiên, khi thêm retrieval hints, độ chính xác không cải thiện đáng kể trên 20 mô hình được thử nghiệm trong Agentic Analytics Benchmark. Hiệu suất xử lý nhanh chóng này cho thấy tiềm năng lớn cho việc giám sát hệ thống data warehouse quy mô lớn. Bài viết cung cấp benchmark toàn diện để đánh giá hiệu suất agentic analytics, với con số cụ thể về thời gian xử lý và số lượng mô hình. Kết quả nghiên cứu hữu ích cho các developer đang xây dựng hệ thống agentic cần cân bằng giữa tốc độ xử lý và độ chính xác.
Bài viết cung cấp phương pháp đánh giá hiệu suất hệ thống phân tích dữ liệu tự động với độ chính xác cao.

CUDA Graph giúp giảm đáng kể overhead inference trong các ứng dụng AI. Thay vì thực thi từng kernel một cách riêng lẻ, CUDA Graph cho phép ánh xạ các kernel thành một đồ thị duy nhất, giảm thời gian setup từ vài mili giây xuống còn vài micro giây. Trong các tác vụ inference cần độ trễ thấp như self-driving car, việc này giúp cải thiện hiệu suất tổng thể. Công nghệ này đặc biệt hiệu quả khi inference được lặp đi lặp lại cùng một mô hình như trong các hệ thống thời gian thực.
Bài này giúp lập trình viên hiểu cách giảm độ trễ inference bằng kỹ thuật CUDA Graph Replay.

Bối cảnh bài viết phân tích kiến trúc AI hiện đại của Google với ba trụ cột chính là RAG, MCP và A2A. Nguyên nhân kỹ thuật là nhu cầu kết nối các AI agent với nhau và với hệ thống hiện có, giải quyết vấn đề thông tin phân mảnh và thiếu cơ chế chuẩn. Hệ quả là kiến trúc này tạo ra hệ sinh thái AI có khả năng tích hợp cao, cho phép các agent trao đổi dữ liệu và thực thi tác vụ phức tạp. Điều đáng học là cách RAG (Retrieval-Augmented Generation) giúp AI truy cập thông tin trong thời gian thực, MCP (Model Context Protocol) thiết lập giao thức kết nối, và A2A (Agent-to-Agent) tạo framework cho tương tác agent.
Bài viết này cung cấp kiến thức cơ bản về cách xây dựng AI agents kết nối với nhau bằng RAG, MCP và A2A.

Graph-RAG được mở rộng bằng lớp temporal reasoning để phân biệt thông tin mới và cũ. Cụ thể, triple subject-predicate-object được nâng cấp thành quadruple có timestamp, lưu trong temporal graph với recency weights tính toán qua exponential decay có half-life parameter có thể điều chỉnh. Bài hướng dẫn minh họa cách xếp hạng các thông tin mâu thuẫn (ai là CEO) tại thời điểm truy vấn cụ thể và tích hợp temporal graph vào pipeline retrieval Graph-RAG 3-tier deterministic hiện có. LLM chỉ nhận thông tin mới nhất, cải thiện đáng kể tính chính xác của Graph-RAG với công nghệ temporal graph.
Bài hướng dẫn này giúp lập trình viên nâng cấp Graph-RAG bằng lớp lý luận thời gian để đảm bảo LLM chỉ sử dụng thông tin cập nhật nhất cho truy vấn của người dùng.

Top-K retrieval trong agentic AI luôn trả về kết quả ngay cả khi không có gì phù hợp, gây hiểu lầm. Cần xây dựng một confidence layer trên OpenSearch để agent có thể định lượng và kiểm tra ngưỡng kết quả. Phương pháp này cho phép agent từ chối đưa ra câu trả lời khi độ tin cậy thấp. Bài viết chi tiết cách triển khai confidence scoring sử dụng vector similarity metrics và ngưỡng threshold linh hoạt. Lập trình viên nên đọc để biết cách xử lý cases where no good answers exist trong hệ thống AI thực tế.
Bài này giúp bạn giải quyết vấn đề trả lời kết quả không liên quan khi sử dụng Top-K retrieval trong agentic AI bằng cách xây dựng lớp độ tin cậy với OpenSearch.

Ngành AI và ML có nhiều nhánh kiến thức sâu rộng mà sinh viên và kỹ sư cần tập trung khi phỏng vấn. Cơ sở kỹ thuật bao gồm supervised learning, unsupervised learning và reinforcement learning với các mô hình như neural networks và transformers. Hệ quả là ứng viên cần hiểu rõ các khái niệm như gradient descent, backpropagation và evaluation metrics. Điều đáng học là bài viết cung cấp lộ trình ôn tập chi tiết với các resources thực tế và ví dụ code cụ thể.
Bài viết này cung cấp hướng dẫn tập trung vào các lĩnh vực AI/ML quan trọng nhất giúp ứng viên chuẩn bị tốt hơn cho phỏng vấn kỹ thuật.

Khi làm việc với RAG (Retrieval-Augmented Generation), nhiều người bị ấn tượng bởi khả năng "ma thuật" của nó. Hệ thống hoạt động bằng cách truy vấn các vector database như Pinecone hoặc Milvus để tìm ngữ cảnh liên quan từ kho knowledge base, sau đó đưa dữ liệu này vào prompt của LLM (GPT-3.5 hoặc GPT-4) để tạo câu trả lời. Tuy nhiên, RAG gặp thách thức với vấn đề hallucination - mô hình vẫn có thể tạo ra thông tin sai sự thật dù đã được truy vấn dữ liệu. Bài viết phân tích chi tiết từng bước trong quy trình RAG, giúp lập trình viên hiểu rõ nguyên nhân kỹ thuật đằng sau hiệu ứng "thần kỳ" này để tối ưu hóa hệ thống thực tế.
Bài viết này giải thích chi tiết quy trình hoạt động của RAG, giúp lập trình viên hiểu rõ cơ chế đằng sau công nghệ thay vì chỉ xem nó như phép màu.

RAG thất bại đến 80% trong môi trường doanh nghiệp ngay trước giai đoạn retrieval do vấn đề chunking không được tối ưu. Nguyên nhân kỹ thuật nằm ở việc chunk size quá lớn (512-token) khiến embeddings mất ngữ cảnh hoặc quá nhỏ làm mất thông tin quan trọng. Hệ quả là chất lượng retrieval suy giảm nghiêm trọng dù truy vấn vẫn hoạt động bình thường. Bài viết đưa ra giải pháp splitting rules cân bằng như Goldilocks chunking - một phương pháp giúp tìm điểm ngọt ngào giữa quá nhỏ và quá lớn để tối ưu hóa hiệu suất hệ thống. Lập trình viên nên đọc bài này để hiểu cách thiết lập chunk size phù hợp cho từng loại document và tránh những lỗi chunking phổ biến nhất.
Bài này giải quyết nguyên nhân gốc rễ khiến phần lớn dự án RAG thất bại do vấn đề chia đoạn dữ liệu chưa tối ưu.

AI Factory là một hệ thống cực kỳ phức tạp, kết hợp nhiều thành phần phần cứng khác nhau như GPUs, CPUs, switches, DPUs và SuperNICs cùng với các scheduler. Vấn đề phát sinh khi cần validate những thay đổi trong hệ thống này trước khi triển khai thực tế, vì một lỗi nhỏ cũng có thể gây tắc nghẽn toàn bộ hệ thống. Giải pháp đề xuất là sử dụng Digital Twins - bản sao ảo của hệ thống thực tế - để mô phỏng và test các thay đổi trong môi trường ảo trước khi áp dụng. Đồng thời, các AI Agents có thể tự động phân tích kết quả mô phỏng và đưa ra đề xuất tối ưu hóa dựa trên dữ liệu thực tế từ hệ thống. Cách tiếp cận này không chỉ giảm thiểu rủi ro mà còn tiết kiệm thời gian và chi phí vận hành đáng kể.
Bài viết này giúp lập trình viên hiểu cách dùng Digital Twins và AI Agents để xác minh các thay đổi trong AI Factory một cách hiệu quả.

Ngày 14 tháng 10, InfoQ tổ chức một buổi webinar 60 phút miễn phí với năm chuyên gia thảo luận về triển khai AI trong môi trường production. Các vấn đề chính bao gồm agent autonomy và human approval, cách kiểm tra các thay đổi do AI tạo ra. Panelist sẽ phân tích những điểm yếu của AI khi chạy production, đặc biệt là với các hệ thống nhạy cảm. Buổi thảo luận cung cấp cái nhìn thực tế về thách thức kỹ thuật khi quản lý agent autonomy, đồng thời đề cập đến các framework cần thiết để đảm bảo chất lượng output.
Bài webinar này cung cấp kiến thức thực tế từ năm chuyên gia về triển khai AI trong sản xuất, giúp lập trình viên hiểu được cách cân bằng tự động hóa và kiểm soát con người.

Bối cảnh: Hacktoberfest Weekend Challenge khuyến khích xây dựng dự án open-source cho cộng đồng, tác giả đã xây dựng một beat studio trong browser để giải quyết vấn đề grid musical. Nguyên nhân kỹ thuật: Grid musical thông thường bỏ đi 40ms khi ở tempo 90 BPM, gây độ trễ đáng kể khi tăng tempo. Hệ quả: Beat studio cho phép tái tạo lại những khoảng thời gian này, mang lại trải nghiệm âm thanh chính xác hơn cho người dùng. Điều đáng học: Dự án sử dụng Web Audio API để xử lý thời gian thực, cho thấy cách tối ưu hóa performance trong ứng dụng web âm nhạc có thể tạo ra khác biệt lớn về trải nghiệm người dùng.
Bài viết này cung cấp giải pháp hiệu quả giúp lập trình viên tối ưu hóa trình beat trong trình duyệt với độ trễ cực thấp chỉ 40ms.
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
Cổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trình1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíAI IDE 22 MB cho dev Việt.
Tải miễn phíBộ nhớ tổ chức cho AI agent.
Khám pháAI trực Fanpage, tự sàng lọc lead.
Dùng thử