Đang tải bảng tin…

Weaviate0 Hot0 bình luận12 phút đọc
Weaviate 1.40 Release
Weaviate 1.40 makes dropping a named vector and 4-bit Rotational Quantization GA, adds multi-vector embeddings on HFresh and PathSeer filtering, and changes vector configuration defaults.
Nguồn: https://weaviate.io/blog/weaviate-1-40-release. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

freeCodeCamp119 Hot2 phút
Learn Vector Databases for Beginners – Embeddings, Similarity Search & ChromaDB
A vector database stores data as lists of numbers called embeddings, which lets it search by meaning instead of matching exact keywords. It's the piece behind a lot of recommendation systems, RAG apps

JetBrains15 Hot14 phút
Building a RAG Pipeline for Semantic Code Search: A Developer Diary and Field Notes
Part 2: Storage, Search, and Agent Tooling In this blog series, we aim to share some of the lessons we learned over the past six months as we built and rolled out Air Context, a production-grade RA

Daily Dose of Data Science | Avi Chawla | Substack146 Hot7 phút
RAG vs. Vectorless RAG, clearly explained!
...explained visually (with tradeoffs in production).

C# Corner1 Hot7 phút
Creating a Hybrid Vector Search Index in Databricks: Important Configuration Settings for RAG Applications
Learn how to configure a hybrid Vector Search index in Databricks for RAG, including source tables, embeddings, endpoints, primary keys, and triggered updates.
Daily Dose of Data Science | Avi Chawla | Substack218 Hot9 phútAI
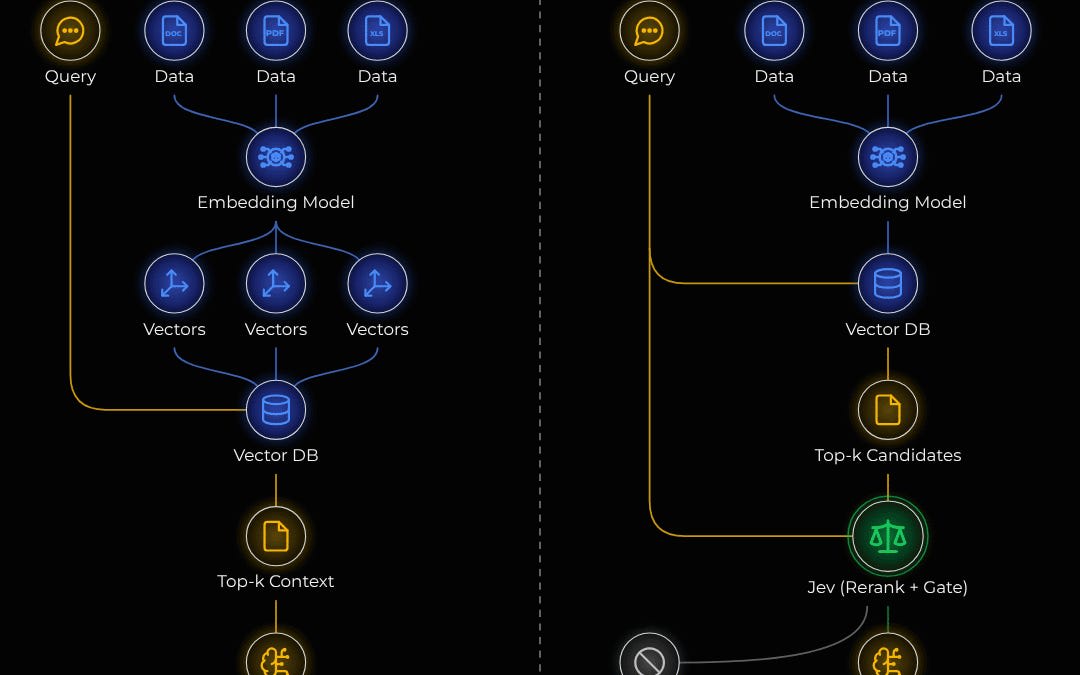
Build a Jev-powered Agentic RAG
Bối cảnh là việc xây dựng một hệ thống RAG (Retrieval-Augmented Generation) có khả năng năng động. Nguyên nhân kỹ thuật là cần một framework có thể xử lý các tác vụ tự nhiên mà không bị giới hạn bởi các prompt cố định. Hệ quả là hệ thống có thể tự điều chỉnh hành vi dựa trên ngữ cảnh đầu vào. Điều đáng học là cách triển khai Jev-powered agent cho RAG giúp tăng tính linh hoạt và khả năng xử lý các tác vụ phức tạp. Bài viết cung cấp hướng dẫn chi tiết với code mẫu để triển khai hệ thống này.
Bài viết này hướng dẫn bạn cách xây dựng hệ thống Retrieval-Augmented Generation với khả năng tự chủ bằng Jev, kèm theo code ví dụ cụ thể.

Couchbase20 Hot12 phút
Vector Database Use Cases: Search, RAG, and AI Apps
The most common vector database use cases are semantic search, RAG, recommendations, and multimodal search. Learn how each works and when to use them.

ByteByteGo85 Hot15 phútAI
How Uber Built a Genie to Answer Questions Correctly
Uber xây dựng Genie để xử lý câu hỏi của tài xế và hành khách. Hệ thống sử dụng Elasticsearch để tìm kiếm kiến thức từ 1.5 triệu tài liệu và kết nối với 60 service backend khác nhau. Phần xử lý ngôn ngữ tự nhiên (NLP) giúp Genie hiểu ngữ cảnh và trích xuất thông tin chính xác. Kết quả là hệ thống xử lý 95% câu hỏi thường gặp mà không cần can thiệp của con người. Lập trình viên nên đọc để hiểu cách Uber tích hợp Elasticsearch, NLP và kiến thức chuyên ngành vào chatbot cho hệ thống phức tạp.
Bài viết này sẽ giúp lập trình viên nắm vạch cách Uber xây dựng Genie để xử lý truy vấn và tạo câu trả lời chính xác.

BigData Boutique blog33 Hot13 phútAI
Vector Database Comparison 2026: Pinecone vs Weaviate vs Qdrant vs OpenSearch
So sánh các vector database Pinecone, Weaviate, Qdrant và OpenSearch cùng các object-storage engine turbopuffer, Amazon S3 Vectors và WarpSearch tập trung vào các yếu tố indexing, hybrid search, quantization, filtering, deployment và pricing. Nguyên nhân kỹ thuật là sự khác biệt về kiến trúc và độ hỗ trợ các tính năng vector search cao cấp, ví dụ Pinecone có hỗ trợ real-time index updates tốt nhất. Hệ quả là sự lựa chọn phù hợp tùy thuộc vào nhu cầu cụ thể như ứng dụng cần low-latency queries có thể chọn Qdrant với hỗ trợ quantization 8-bit. Điều đáng học là khi nào việc chạy thêm một vector store thứ hai không đáng giá về chi phí và quản lý.
Bài cung cấp phân tích chi tiết giúp lập trình viên lựa chọn vector database phù hợp nhất cho dự án của họ.
Bình luận
Đang tải bình luận…