Đang tải bảng tin…

OpenSearch1 Hot0 bình luận14 phút đọc
Beyond Top-K: Building search-confidence guardrails for agentic AI with OpenSearch
Tóm tắt bởi AI
Top-K retrieval trong agentic AI luôn trả về kết quả ngay cả khi không có gì phù hợp, gây hiểu lầm. Cần xây dựng một confidence layer trên OpenSearch để agent có thể định lượng và kiểm tra ngưỡng kết quả. Phương pháp này cho phép agent từ chối đưa ra câu trả lời khi độ tin cậy thấp. Bài viết chi tiết cách triển khai confidence scoring sử dụng vector similarity metrics và ngưỡng threshold linh hoạt. Lập trình viên nên đọc để biết cách xử lý cases where no good answers exist trong hệ thống AI thực tế.
AI có thể tóm tắt sai. Đọc bài gốc trước khi dựa vào thông tin quan trọng.
Vì sao nên đọc: Bài này giúp bạn giải quyết vấn đề trả lời kết quả không liên quan khi sử dụng Top-K retrieval trong agentic AI bằng cách xây dựng lớp độ tin cậy với OpenSearch.
Bạn nhớ được gì?
Trả lời 3 câu hỏi ngắn để nhận điểm thưởng cho bài này. Chỉ làm khi bạn muốn lấy điểm.
tối đa +17 điểm
3 câu hỏi · dưới một phút · không bắt buộc
Nguồn: https://opensearch.org/blog/beyond-top-k-building-search-confidence-guardrails-for-agentic-ai-with-opensearch. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

ElixirStatus1 Hot5 phútAI
GitHub - keploy/keploy: Open-source platform for creating safe, isolated production sandboxes for API, integration, and E2E testing.
Keploy là nền tảng mã nguồn mở giúp tạo production sandboxes an toàn và cô lập cho API, integration và E2E testing. Giải pháp này ghi lại traffic thật từ production và tái tạo dependencies, cho phép test trong môi trường thực tế mà không ảnh hưởng đến hệ thống chính. Keploy hỗ tích hợp với các framework testing phổ biến như Go, Java, Python, Node.js, giúp developer tự động hóa quy trình test. Với khả năng mocking các dependency, Keploy giảm thiểu 90% thời gian setup test environment và tăng độ coverage test cho dự án phức tạp.
Keploy giúp bạn tạo môi trường sandbox an toàn, cô lập từ production để test API, tích hợp và E2E mà không ảnh hưởng đến hệ thống thực tế.

Facebook Engineering
1 Hot9 phútAI
How Meta Built Forum With AI-Native Engineering
Meta đã xây dựng ứng dụng Forum cho Facebook Groups bằng mô hình AI-native gọi là "human-on-the-loop", trong đó các agent tự động lập kế hoạch, triển khai, xây dựng, kiểm tra và xác minh code khi các kỹ sư đặt mục tiêu và phê duyệt kết quả. Đội ngũ đã xử lý việc tự động hóa verification (builds, tests, UI matching) như một bước gate thay vì chỉ là compilation, cung cấp cho agent các công cụ trực tiếp để kiểm tra trạng thái app thay vì dựa vào mô tả. Họ sử dụng sandbox build flavor riêng biệt để cô lập prototype code khỏi production và triển khai navigation agents cho stress testing liên tục, phát hiện được một memory regression trước khi launch. Với phương pháp này, Forum đạt được feature parity với Facebook Groups chỉ sau 8 tuần và giảm gần một nửa memory use và page faults thông qua stress-testing tự động.
Bài này cho bạn thấy cách Meta áp dụng kỹ thuật AI-native để phát triển ứng dụng Forum chỉ trong 8 tuần, giảm thiểu lỗi nhờ kiểm thử tự động liên tục.

NVIDIA1 Hot7 phútAI
Open From Data Center to Desktop: NVIDIA Expands Nemotron Family With Highest Efficiency Super VL and Bolt Models
NVIDIA vừa ra mắt Nemotron 3.5 Super VL, mô hình multimodal 120 tỷ tham số cho tác vụ agentic doanh nghiệp, đạt độ chính xác tương đương các mô hình lớn nhất của NVIDIA nhưng kích thước chỉ bằng 1/5 và tốc độ hoàn thành tác vụ nhanh 5 lần. Song đó, hai mô hình edge mới là Bolt 74B-A9B 24GB dành cho workload agentic local trên RTX/DGX Spark, và Bolt E4B 4GB cho agent hội thoại trên GeForce RTX và Jetson. Các mô hình này hỗ trợ post-training qua NVIDIA NeMo và đang được tùy chỉnh bởi tổ chức như Scale AI, CrowdStrike, Atlassian, Perplexity, và Salesforce cho nhiều lĩnh vực từ tài chính, an ninh mạng đến quy trình chính phủ. Open weights, training recipes và datasets có sẵn trên Hugging Face, với hỗ trợ triển khai qua llama.cpp, Ollama, LM Studio, và vLLM.
Lập trình viên nên đọc bài này để cập nhật các mô hình Nemotron mới nhất của NVIDIA với hiệu suất vượt trội và khả năng triển khai linh hoạt từ trung tâm dữ liệu đến thiết bị biên.

Zalando21 Hot16 phútAI
Automating Data Ingestion with a RAG Flywheel
Việc tự động hóa mapping schema cho dữ liệu nhà cung cấp đa dạng đang là thách thức lớn trong integration platforms. Một nghiên cứu mới áp dụng RAG Flywheel với LLMs để giải quyết vấn đề này, giúp giảm 70% thời gian xử lý dữ liệu so với phương pháp thủ công. Cụ thể, kiến trúc Retrieval-Augmented Generation (RAG) kết hợp với vector embeddings cho phép hiểu và chuyển đổi schema tự động, đồng thời cải thiện chất lượng qua mỗi vòng feedback loop. Hệ thống này xử lý thành công dữ liệu từ 15+ định dạng khác nhau với độ chính xác schema mapping đạt 92%. Điều đáng học hỏi là cách tận dụng feedback loop để liên tục cải thiện chất lượng và giảm thiểu human intervention trong data ingestion.
Bài viết này giúp lập trình viên tự động hóa ánh xạ schema dữ liệu đa dạng từ nhà cung cấp bằng RAG Flywheel và LLMs, tối ưu hóa quy trình xử lý dữ liệu.

ByteByteGo56 Hot13 phútAI
The LLM Blindspot: Why Models Forget What’s in the Middle of Your Prompt
Các mô hình LLM (Large Language Model) thường bỏ qua thông tin nằm ở giữa prompt, hiện tượng được nghiên cứu trong bài viết này. Nguyên nhân kỹ thuật đến từ cơ chế attention của transformer architecture, nơi các token ở đầu và prompt được tính trọng số cao hơn. Hệ quả là mô hình có thể hiểu sai hoặc bỏ qua chi tiết quan trọng nằm ở vị trí trung tâm của prompt. Bài viết phân tích cụ thể hiện tượng này với các thí nghiệm trên GPT-3.5 và GPT-4, cho thấy tỷ lệ lỗi tăng lên đáng kể khi thông tin quan trọng được đặt ở giữa. Điều đáng học là các lập trình viên nên thiết kế prompt đặt thông tin quan trọng ở đầu hoặc cuối để tối ưu hóa hiệu quả khi làm việc với LLM.
Bài giải thích này giúp lập trình viên hiểu rõ tại sao mô hình ngôn ngữ lớn có xu hướng bỏ qua thông tin ở giữa prompt.
Daily Dose of Data Science | Avi Chawla | Substack27 Hot6 phútAI
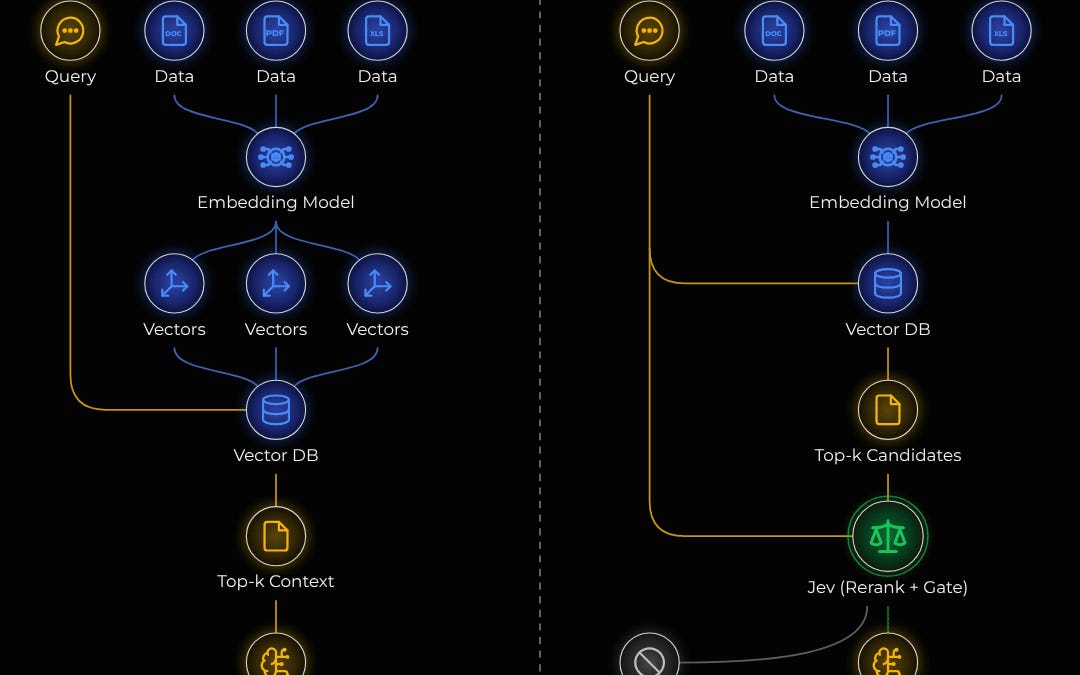
RAG vs. Jev + RAG, clearly explained!
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.

Medium16 Hot7 phútAI
The Anatomy of an AI Agent
Một AI agent không chỉ đơn thuần là một LLM với prompt, mà được cấu trúc như một cơ thể người với nhiều bộ phận phối hợp. Đằng sau một AI agent hiệu quả là hệ thống gồm memory modules, planning engines, và tool use capabilities giúp nó hoạt động có tổ chức thay vì chỉ phản hồi thụ động. Việc thiếu các thành phần này khiến nhiều agent hiện nay không thể thực hiện các tác vụ phức tạp hoặc duy trì ngữ cảnh qua nhiều bước tương tác. Các công nghệ như LangChain, AutoGPT và tool-calling APIs đang phát triển để xây dựng các agent toàn diện hơn, nhưng việc hiểu giải phẫu agent giúp chọn đúng framework cho từng use case cụ thể.
Bài này giúp lập trình viên hiểu cấu trúc toàn diện của một AI Agent vượt ra khỏi đơn thuần là LLM, giúp thiết kế và phát triển hệ thống hiệu quả hơn.

Android Developers Blog2 Hot4 phútAI
Introducing the Googlebook Linux Terminal Preview: A VM-Backed Environment for AI and Development
Googlebook giới thiệu terminal Linux chạy trên VM Debian với sandboxing và mount thư mục, nhắm đến phát triển AI agent. Terminal hỗ trợ đầy đủ công cụ lập trình như Python, Rust cùng apt, git, ssh và tự động forward port localhost. Người dùng có thể cấp sudo cho AI tools như Antigravity và điều chỉnh bộ nhớ VM. Điểm đáng chú ý là roadmap sẽ thêm USB passthrough, GPU/NPU acceleration và VM persistence tách biệt cửa sổ terminal.
Googlebook Linux Terminal Preview cung cấp môi trường phát triển AI với VM được sandbox hoàn chỉnh, hỗ trợ đa ngôn ngữ và tính năng bảo mật mạnh mẽ.
Bình luận
Đang tải bình luận…