Đang tải bảng tin…

Meilisearch0 Hot0 bình luận16 phút đọc
Full-text search vs. semantic search: A full comparison
Tóm tắt bởi AI
Bối cảnh của bài so sánh full-text search và semantic search giúp người dùng hiểu rõ hai phương pháp truy xuất thông tin khác nhau. Nguyên nhân kỹ thuật chính là full-text search sử dụng matching từ khóa exact matching trong khi semantic search ứng dụng Natural Language Processing (NLP) và embedding vectors để hiểu ngữ nghĩa. Hệ quả là semantic search cho kết quả chính xác hơn với các truy vấn phức tạp nhưng đòi hỏi tài tính toán cao hơn, trong khi full-text search nhanh và hiệu quả với dữ liệu có cấu trúc rõ ràng. Điều đáng học là lựa chọn công nghệ phù hợp phụ thuộc vào nhu cầu cụ thể, có thể kết hợp cả hai phương pháp để tối ưu hiệu suất và độ chính xác.
AI có thể tóm tắt sai. Đọc bài gốc trước khi dựa vào thông tin quan trọng.
Vì sao nên đọc: Bài viết này giúp lập trình viên hiểu rõ sự khác biệt giữa tìm kiếm toàn văn bản và tìm ngữ nghĩa, từ đó chọn công cụ phù hợp cho dự án của mình.
Bạn nhớ được gì?
Trả lời 3 câu hỏi ngắn để nhận điểm thưởng cho bài này. Chỉ làm khi bạn muốn lấy điểm.
tối đa +17 điểm
3 câu hỏi · dưới một phút · không bắt buộc
Nguồn: https://www.meilisearch.com/blog/full-text-search-vs-semantic-search. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

Medium1 Hot1 phútAI
Artifical Intelligence — Prep Interview
Ngành AI và ML có nhiều nhánh kiến thức sâu rộng mà sinh viên và kỹ sư cần tập trung khi phỏng vấn. Cơ sở kỹ thuật bao gồm supervised learning, unsupervised learning và reinforcement learning với các mô hình như neural networks và transformers. Hệ quả là ứng viên cần hiểu rõ các khái niệm như gradient descent, backpropagation và evaluation metrics. Điều đáng học là bài viết cung cấp lộ trình ôn tập chi tiết với các resources thực tế và ví dụ code cụ thể.
Bài viết này cung cấp hướng dẫn tập trung vào các lĩnh vực AI/ML quan trọng nhất giúp ứng viên chuẩn bị tốt hơn cho phỏng vấn kỹ thuật.

freeCodeCamp30 Hot2 phútAI
TimescaleDB Course – PostgreSQL for Time-Series Data
Bối cảnh: Quản lý dataset lớn và phát triển nhanh chóng là kỹ năng quan trọng cho lập trình viên hiện đại, từ theo dõi log API, giám sát telemetry IoT đến xây dựng dashboard. Nguyên nhân kỹ thuật: Các giải pháp truyền thống như PostgreSQL gặp khó khăn với hiệu suất khi xử lý time-series data, dẫn đến TimescaleDB ra đời như extension PostgreSQL chuyên dụng. Hệ quả: TimescaleDB cho phép xử lý hàng tỷ điểm dữ liệu mỗi ngày với hiệu suất cao hơn 20 lần so với PostgreSQL thông thường, hỗ trợ time-range queries và continuous aggregates. Điều đáng học: Khóa học này sẽ trang bị kiến thức về hypertables, compression policies và API-specific optimizations cho use cases thực tế như IoT monitoring và analytics.
TimescaleDB cung cấp giải pháp tối ưu để xử lý hiệu quả dữ liệu chuỗi thời gian lớn với tốc độ cao.

Medium1 Hot11 phútAI
RAG Isn’t Magic. Here’s the Journey From a Question to an Answer
Khi làm việc với RAG (Retrieval-Augmented Generation), nhiều người bị ấn tượng bởi khả năng "ma thuật" của nó. Hệ thống hoạt động bằng cách truy vấn các vector database như Pinecone hoặc Milvus để tìm ngữ cảnh liên quan từ kho knowledge base, sau đó đưa dữ liệu này vào prompt của LLM (GPT-3.5 hoặc GPT-4) để tạo câu trả lời. Tuy nhiên, RAG gặp thách thức với vấn đề hallucination - mô hình vẫn có thể tạo ra thông tin sai sự thật dù đã được truy vấn dữ liệu. Bài viết phân tích chi tiết từng bước trong quy trình RAG, giúp lập trình viên hiểu rõ nguyên nhân kỹ thuật đằng sau hiệu ứng "thần kỳ" này để tối ưu hóa hệ thống thực tế.
Bài viết này giải thích chi tiết quy trình hoạt động của RAG, giúp lập trình viên hiểu rõ cơ chế đằng sau công nghệ thay vì chỉ xem nó như phép màu.

We Are .NET28 Hot5 phútAI
EF Core 10 Is INSANE — Overview of Game Changer features
EF Core 10 giới thiệu các toán tử LeftJoin và RightJoin cấp first-class, cùng với named query filters có thể tắt riêng lẻ. Bản cập nhật này hỗ trợ complex types được ánh xạ trực tiếp vào JSON columns, cải thiện hiệu suất truy vấn. Các tính năng mới giúp giảm thiểu lượng code cần viết khi xử lý các thao tác join và lọc phức tạp. Với khả năng ánh xạ trực tiếp đến JSON columns, EF Core 10 mang lại giải pháp linh hoạt hơn cho việc làm việc với dữ liệu không quan hệ. Những cải tiến này đặc biệt hữu ích cho các ứng dụng cần xử lý cả cấu trúc quan hệ và phi quan hệ.
EF Core 10 mang đến những tính năng đột phá như LeftJoin, RightJoin và bộ lọc truy vấn có thể tắt riêng lẻ, giúp tối ưu hiệu suất và khả năng linh hoạt trong phát triển ứng dụng.

Medium1 Hot18 phútAI
The Chunking Dilemma: Why RAG Fails Before Retrieval Even Starts
RAG thất bại đến 80% trong môi trường doanh nghiệp ngay trước giai đoạn retrieval do vấn đề chunking không được tối ưu. Nguyên nhân kỹ thuật nằm ở việc chunk size quá lớn (512-token) khiến embeddings mất ngữ cảnh hoặc quá nhỏ làm mất thông tin quan trọng. Hệ quả là chất lượng retrieval suy giảm nghiêm trọng dù truy vấn vẫn hoạt động bình thường. Bài viết đưa ra giải pháp splitting rules cân bằng như Goldilocks chunking - một phương pháp giúp tìm điểm ngọt ngào giữa quá nhỏ và quá lớn để tối ưu hóa hiệu suất hệ thống. Lập trình viên nên đọc bài này để hiểu cách thiết lập chunk size phù hợp cho từng loại document và tránh những lỗi chunking phổ biến nhất.
Bài này giải quyết nguyên nhân gốc rễ khiến phần lớn dự án RAG thất bại do vấn đề chia đoạn dữ liệu chưa tối ưu.
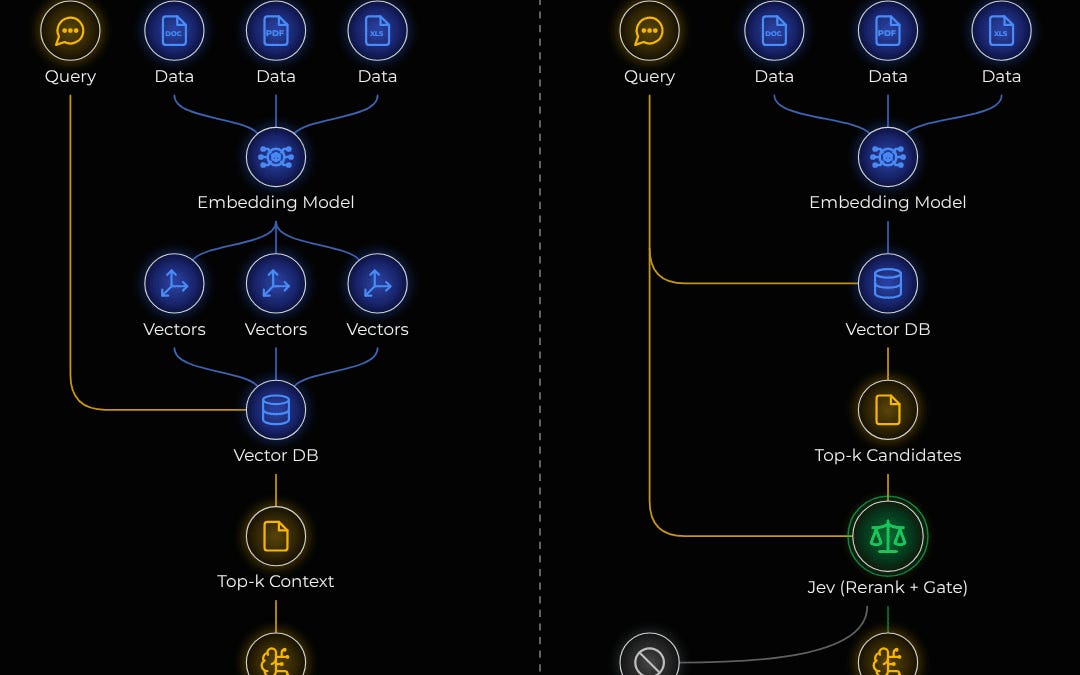
Daily Dose of Data Science | Avi Chawla | Substack1 Hot6 phútAI
RAG vs. Jev + RAG, clearly explained!
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.

We Are .NET29 Hot9 phútAI
One Language to Rule Them? LINQ, Abstraction, and What's Next
Bài viết phân tích cách .NET từng có nhiều ngôn ngữ truy vấn riêng cho từng định dạng dữ liệu trước khi LINQ ra đời nhằm thống nhất chúng. Sau đó, mọi định dạng dữ liệu đều dần được chuyển đổi thành objects và truy vấn bằng LINQ.
LINQ không chỉ là công cụ tìm kiếm dữ liệu mà còn là khái niệm trừu tượng hóa và tiêu chuẩn hóa cách xử lý dữ liệu trong các ngôn ngữ .NET, giúp lập trình viên tránh rắc rối của các ngôn ngữ riêng biệt và tối ưu hóa hiệu suất cho các ứng dụng lớn.

MariaDB.org1 Hot6 phútAI
Laravel 13 now supports MariaDB Vector natively
Laravel phiên bản 13.28 trở đi đã hỗ trợ native vector cho MariaDB 11.7 và mới hơn, loại bỏ nhu cầu sử dụng database thứ hai, dịch vụ vector bên ngoài hay package devilsberg/laravel-mariadb-vector. Developers có thể định nghĩa vector columns và indexes qua migrations, cast embeddings với AsVector và chạy similarity queries với whereVectorSimilarTo thông qua dedicated mariadb driver. Công việc này do community contributor Mohamed Touhami Rhaima cùng 3 người khác thực hiện, được Taylor Otwell review và merge. Hiện tại chỉ hỗ trợ cosine distance, Euclidean distance và index tuning đang nằm trong separate package, trong khi hybrid full-text plus vector search đang được lên kế hoạch.
Lập trình viên phát triển ứng dụng AI cần biết Laravel 13 đã tích hợp hỗ trợ vector natively trong MariaDB từ phiên bản 13.28, giúp tối ưu hóa hiệu suất tìm kiếm tương đồng mà không cần phụ thuộc vào các dịch vụ bên ngoài hay gói phụ, tiết kiệm thời gian và chi phí.
Bình luận
Đang tải bình luận…