Đang tải bảng tin…

XDA Developers0 Hot0 bình luận3 phút đọc
Your CPU has less than 4.2ms to keep up at 240FPS, and that's harder than it sounds
Hitting 240FPS is only half the battle.
Nguồn: https://www.xda-developers.com/your-cpu-has-less-than-4-2ms-to-keep-up-at-240-fps-harder-than-it-sounds. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

XDA Developers119 Hot4 phútAI
I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B model faster than I can read
Một lập trình viên đã tìm ra cách chạy model Llama 35B trên laptop GPU chỉ 8GB VRAM với tốc độ đáng kinh ngạc. Nguyên nhân kỹ thuật nằm ở việc chỉnh sửa cờ n_gpu_layers trong llama.cpp, cho phép tận dụng hiệu quả bộ nhớ VRAM thay vì để nó trở thành điểm nghẽn. Hệ quả là model 35B parameters chạy nhanh đến mức người dùng không kịp theo dõi, vượt xa các kỳ vọng ban đầu về giới hạn phần cứng. Điều đáng học hỏi là đôi khi vấn đề không nằm ở cấu hình phần cứng mà ở cách tối ưu hóa phần mềm để khai thác tiềm năng thực sự của hardware.
Bài viết tiết lộ cách tối ưu hóa một cờ trong llama.cpp để chạy mô hình 35B trên GPU 8GB nhanh hơn tốc độ đọc của bạn.

Khalid Abuhakmeh21 Hot11 phút
How to Loop Through a List in C#: Every Way, Benchmarked
How to loop through and iterate a List<T> in C# with foreach, for, ForEach, Index(), and spans, plus break, continue, safe removal, and benchmarks.

Meziantou0 Hot8 phút
Runtime async benchmarks: .NET 10 vs .NET 11
The same workloads compiled three ways. Runtime async collapses a 20 layer synchronous chain from 1512 bytes to 72, and shallow suspensions go the wrong way.
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 phútAI
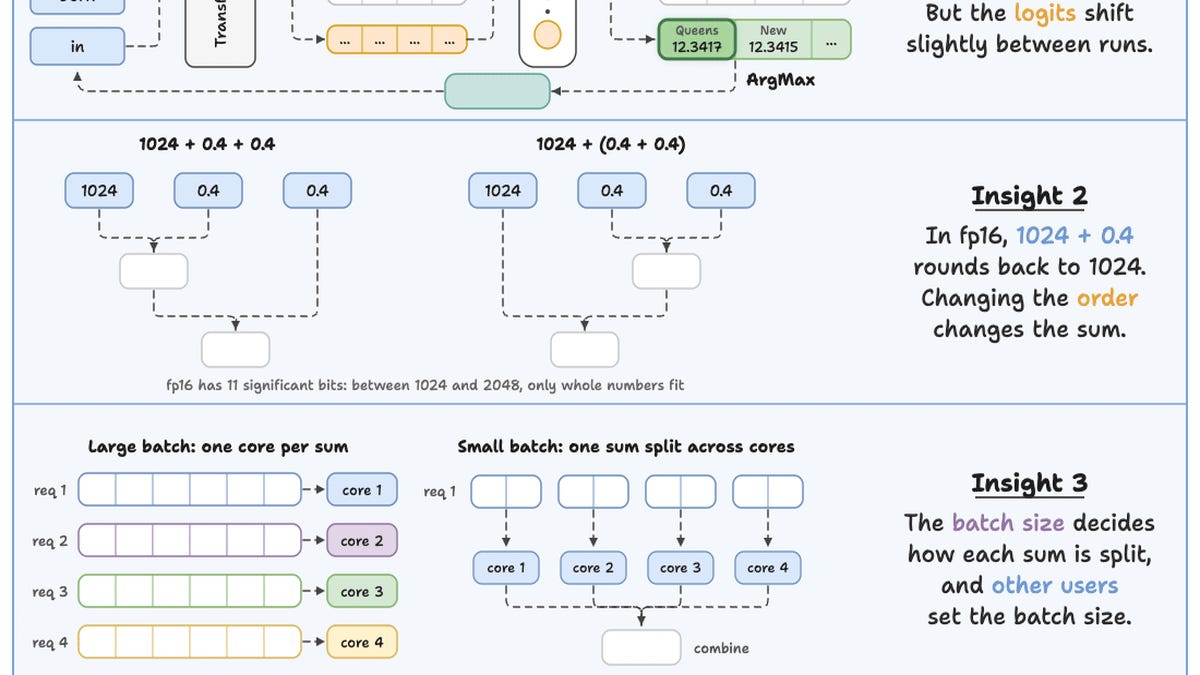
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

ClickHouse54 Hot18 phútAI
Introducing the (blazing fast!) native TCP client for .NET
ClickHouse vừa giới thiệu native TCP client cho .NET giúp tăng tốc độ đọc và insert dữ liệu với số lần phân bổ bộ nhớ ít hơn. API cột (columnar APIs) và hỗ trợ POCO giúp xử lý dữ liệu hiệu quả hơn so với HTTP truyền thống. Client mới này giảm đáng kể chi phí CPU và bộ nhớ nhờ loại bỏ các lớp trung gian không cần thiết. Nếu bạn đang làm việc với ClickHouse trên .NET, việc chuyển sang native TCP client sẽ mang lại hiệu suất vượt trội, đặc biệt với các operation đọc/ghi hàng loạt.
Client TCP native của ClickHouse cho .NET mang lại hiệu suất vượt trội với API cột và hỗ trợ POCO giúp tối ưu hóa hiệu năng ứng dụng của bạn.

Phoronix37 Hot2 phútAI
Omarchy Gets The Web Browser Launching Faster By Avoiding XDG Overhead
Omarchy 4.0.5, bản phân phối Arch Linux dựa trên Hyprland, tăng tốc khởi trình trình duyệt web bằng cách thay thế lời gọi xdg-settings chậm bằng công cụ tùy chỉnh. Việc sử dụng omarchy-cmd-default-browser giúp xác định trình duyệt mặc định trong khoảng 10ms, nhanh hơn đáng kể so với 72ms của xdg-settings do chuỗi script POSIX shell phức tạp. Công cụ này ưu tiên kiểm tra cấu hình Hyprland trước, sau đó mới fallback đến xdg-settings và xdg-mime khi chưa được thiết lập. Tối ưu hóa riêng này cũng giúp giảm thời gian khởi động thanh trạng thái của Omarchy từ khoảng 20 giây xuống còn 15 giây trên hệ thống 6 màn hình với nhiều widget.
Omarchy giúp khởi trình trình duyệt web nhanh hơn đáng kể nhờ loại bỏ lớp xdg-settings chậm và thay bằng công cụ trợ giúp tùy chỉnh.

Adventures in Nodeland75 Hot4 phútAI
How Booking.com cut Node.js costs by 38% with Watt
Booking.com đã tiết giảm chi phí compute cho Node.js tới 38% khi chuyển từ pm2 sang Watt. Công nghệ Watt giúp giảm số lượng pod cần thiết, cắt giảm 20% lượng memory sử dụng, đồng thời giảm được latency. Điều đáng chú ý là tất cả các thay đổi này được thực hiện mà không cần thay đổi bất kỳ dòng service code nào. Giải pháp Watt hoạt động bằng cách tối ưu hóa hiệu suất runtime của Node.js một cách thông minh.
Bài viết cho thấy cách giảm chi phí Node.js hiệu quả mà không cần thay đổi code dịch vụ.

Bình luận
Đang tải bình luận…