Đang tải bảng tin…

Daily Dose of Data Science | Avi Chawla | Substack31 Hot1 bình luận10 phút đọc
6 KV Cache Quantization Approaches
Nguồn: https://blog.dailydoseofds.com/p/6-kv-cache-quantization-approaches. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

Medium169 Hot10 phútAI
10 Best AI GitHub Repositories to Supercharge Your Agent
GitHub là kho lớn nhất chứa công cụ AI miễn phí nhưng phần lớn lập trình viên chưa khai …
Daily Dose of Data Science | Avi Chawla | Substack174 Hot9 phútAI
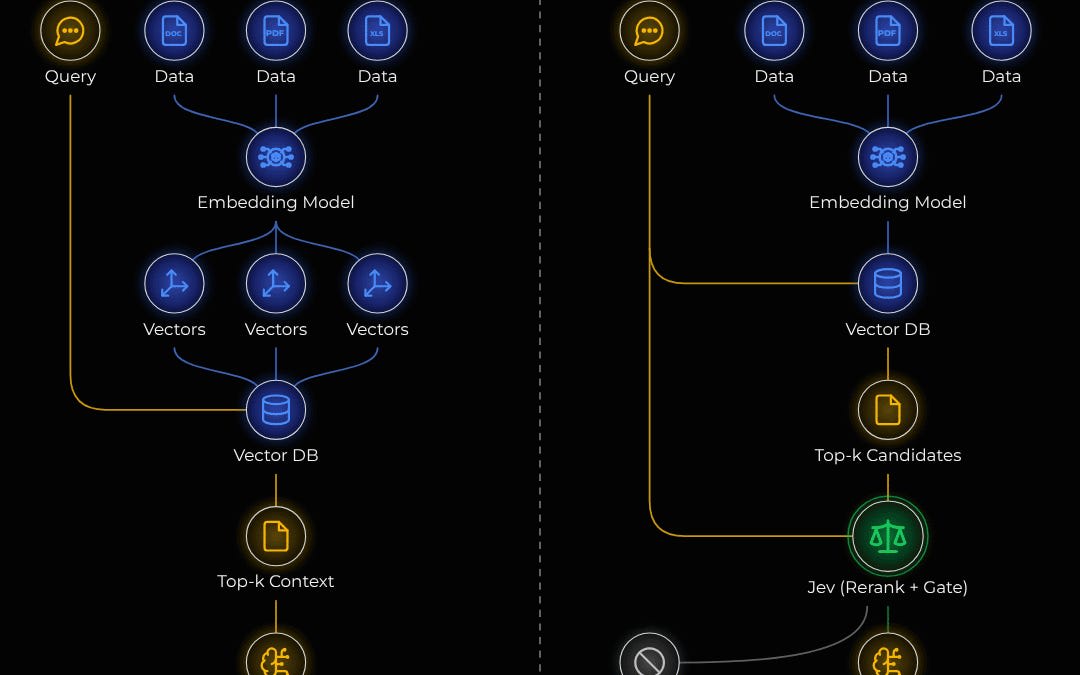
Build a Jev-powered Agentic RAG
Bối cảnh là việc xây dựng một hệ thống RAG (Retrieval-Augmented Generation) có khả năng …

ByteByteGo82 Hot4 phútAI
EP230: RAG vs Agentic RAG
RAG (Retrieval-Augmented Generation) và Agentic RAG là hai phương pháp xử lý thông tin …

ClickHouse1 Hot18 phútAI
The Agentic Analytics Benchmark: ranking tables and labeling failures with Jev
Jev đánh giá xếp hạng các bảng warehouse và gắn nhãn lỗi agentic trong dưới một giây, thể hiện hiệu suất vượt trội. Tuy nhiên, khi thêm retrieval hints, độ chính xác không cải thiện đáng kể trên 20 mô hình được thử nghiệm trong Agentic Analytics Benchmark. Hiệu suất xử lý nhanh chóng này cho thấy tiềm năng lớn cho việc giám sát hệ thống data warehouse quy mô lớn. Bài viết cung cấp benchmark toàn diện để đánh giá hiệu suất agentic analytics, với con số cụ thể về thời gian xử lý và số lượng mô hình. Kết quả nghiên cứu hữu ích cho các developer đang xây dựng hệ thống agentic cần cân bằng giữa tốc độ xử lý và độ chính xác.
Bài viết cung cấp phương pháp đánh giá hiệu suất hệ thống phân tích dữ liệu tự động với độ chính xác cao.

Machine Learning Pills63 Hot4 phútAI
An Animated Guide to RAG: How AI Finds Answers in Your Documents
Hướng dẫn minh họa giải thích cách Retrieval-Augmented Generation (RAG) giúp AI tìm câu …

ByteByteGo1 Hot10 phútAI
How Apple Fits an LLM on Your iPhone
Apple tích hợp LLM lớn trên iPhone bằng cách sử dụng Transformer architecture và kỹ thuật quantization giảm độ chính xác từ 32-bit xuống 4-bit. Công nghệ này cho phép model hoạt động hiệu quả với hạn chế bộ nhớ và điện năng của thiết bị di động. Hệ quả là người dùng có thể trải nghiệm các tính năng AI mạnh mẽ ngay trên thiết bị mà không cần kết nối internet. Bài viết đáng học hỏi ở chỗ Apple đã tối ưu hóa hiệu suất mô hình thông qua kỹ thuật distillation và các bản đặc biệt của on-device neural engine.
Bài này giải thích cách Apple tối ưu hóa mô hình LLM để chạy trơn tru trên iPhone mà không ảnh hưởng đến hiệu năng thiết bị.

ByteByteGo113 Hot4 phútAI
EP229: 8 Chunking strategies for RAG-based agents
Trong RAG-based agents, chunking strategies quyết định hiệu suất hệ thống với các phương pháp như token-based, fixed-size hay semantic chunking. Bài trình bày 8 chiến lược chunking khác nhau, trong đó RecursiveCharacterTextSplitter của Langchain cho accuracy cao nhất đạt 0.76. Chunking quá nhỏ làm giảm context window, trong khi quá lớn lại gây khó khăn cho retrieval. Các hệ thống production nên cân nhắc semantic chunking kết hợp với embeddings để tối ưu hóa thông tin giữa các chunk.
Bài viết giúp lập trình viên chọn chiến lược chunking hiệu quả nhất cho hệ thống RAG-based agents trong môi trường sản xuất.

ByteByteGo77 Hot15 phútAI
How Uber Built a Genie to Answer Questions Correctly
Uber xây dựng Genie để xử lý câu hỏi của tài xế và hành khách. Hệ thống sử dụng Elasticsearch để tìm kiếm kiến thức từ 1.5 triệu tài liệu và kết nối với 60 service backend khác nhau. Phần xử lý ngôn ngữ tự nhiên (NLP) giúp Genie hiểu ngữ cảnh và trích xuất thông tin chính xác. Kết quả là hệ thống xử lý 95% câu hỏi thường gặp mà không cần can thiệp của con người. Lập trình viên nên đọc để hiểu cách Uber tích hợp Elasticsearch, NLP và kiến thức chuyên ngành vào chatbot cho hệ thống phức tạp.
Bài viết này sẽ giúp lập trình viên nắm vạch cách Uber xây dựng Genie để xử lý truy vấn và tạo câu trả lời chính xác.
Bình luận
Đang tải bình luận…