Đang tải bảng tin…

Pinterest Engineering0 Hot0 bình luận9 phút đọc
Evolving Pinterest’s Embedding Retrieval Platform
Tóm tắt bởi AI
Pinterest phát triển embedding retrieval platform để xử lý lượng truy vấn tìm kiếm ngày càng tăng. Họ thay thế hệ thống cũ dựa trên FAISS bằng solution mới sử dụng PyTorch và NVIDIA GPU, giúp tăng tốc độ xử lý. Platform mới cho phép xử lý 100+ triệu embedding mỗi ngày với độ trễ chỉ 20ms, hỗ trợ hơn 50 feature teams trong công ty. Bài viết chia sẻ chi tiết về technical challenges và giải pháp khi scale lên hệ thống lớn, rất hữu ích cho engineer đang làm việc với recommendation system và large-scale embedding retrieval.
AI có thể tóm tắt sai. Đọc bài gốc trước khi dựa vào thông tin quan trọng.
Vì sao nên đọc: Bài viết này giúp bạn hiểu cách Pinterest đã phát triển nền tảng truy xuất embedding để cải thiện hiệu suất và khả năng mở rộng hệ thống.
Bạn nhớ được gì?
Trả lời 3 câu hỏi ngắn để nhận điểm thưởng cho bài này. Chỉ làm khi bạn muốn lấy điểm.
tối đa +17 điểm
3 câu hỏi · dưới một phút · không bắt buộc
Nguồn: https://medium.com/pinterest-engineering/evolving-pinterests-embedding-retrieval-platform-aede4e831e01. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn
Daily Dose of Data Science | Avi Chawla | Substack185 Hot9 phútAI
Build a Jev-powered Agentic RAG
Bối cảnh là việc xây dựng một hệ thống RAG (Retrieval-Augmented Generation) có khả năng năng động. Nguyên nhân kỹ thuật là cần một framework có thể xử lý các tác vụ tự nhiên mà không bị giới hạn bởi các prompt cố định. Hệ quả là hệ thống có thể tự điều chỉnh hành vi dựa trên ngữ cảnh đầu vào. Điều đáng học là cách triển khai Jev-powered agent cho RAG giúp tăng tính linh hoạt và khả năng xử lý các tác vụ phức tạp. Bài viết cung cấp hướng dẫn chi tiết với code mẫu để triển khai hệ thống này.
Bài viết này hướng dẫn bạn cách xây dựng hệ thống Retrieval-Augmented Generation với khả năng tự chủ bằng Jev, kèm theo code ví dụ cụ thể.

BigData Boutique blog17 Hot13 phútAI
Vector Database Comparison 2026: Pinecone vs Weaviate vs Qdrant vs OpenSearch
So sánh các vector database Pinecone, Weaviate, Qdrant và OpenSearch cùng các object-storage engine turbopuffer, Amazon S3 Vectors và WarpSearch tập trung vào các yếu tố indexing, hybrid search, quantization, filtering, deployment và pricing. Nguyên nhân kỹ thuật là sự khác biệt về kiến trúc và độ hỗ trợ các tính năng vector search cao cấp, ví dụ Pinecone có hỗ trợ real-time index updates tốt nhất. Hệ quả là sự lựa chọn phù hợp tùy thuộc vào nhu cầu cụ thể như ứng dụng cần low-latency queries có thể chọn Qdrant với hỗ trợ quantization 8-bit. Điều đáng học là khi nào việc chạy thêm một vector store thứ hai không đáng giá về chi phí và quản lý.
Bài cung cấp phân tích chi tiết giúp lập trình viên lựa chọn vector database phù hợp nhất cho dự án của họ.

Machine Learning Pills67 Hot4 phútAI
An Animated Guide to RAG: How AI Finds Answers in Your Documents
Hướng dẫn minh họa giải thích cách Retrieval-Augmented Generation (RAG) giúp AI tìm câu trả lời từ tài liệu. Nguyên nhân kỹ thuật là mô hình RAG kết hợp truy vấn thông tin từ vector database để trả lời chính xác hơn. Hệ quả là giảm hiện tượng "ảo tưởng" (hallucination) của AI và cung cấp nguồn tham khảo cho câu trả lời. Điều đáng học là cách kiến trúc RAG cải thiện đáng kể độ chính xác với 40-70% so với các mô hình chỉ sử dụng prompt đơn thuần.
Hướng dẫn RAG bằng hoạt ảnh giúp lập trình viên hiểu rõ cách AI trích xuất thông tin từ tài liệu hiệu quả.

ByteByteGo113 Hot4 phútAI
EP229: 8 Chunking strategies for RAG-based agents
Trong RAG-based agents, chunking strategies quyết định hiệu suất hệ thống với các phương pháp như token-based, fixed-size hay semantic chunking. Bài trình bày 8 chiến lược chunking khác nhau, trong đó RecursiveCharacterTextSplitter của Langchain cho accuracy cao nhất đạt 0.76. Chunking quá nhỏ làm giảm context window, trong khi quá lớn lại gây khó khăn cho retrieval. Các hệ thống production nên cân nhắc semantic chunking kết hợp với embeddings để tối ưu hóa thông tin giữa các chunk.
Bài viết giúp lập trình viên chọn chiến lược chunking hiệu quả nhất cho hệ thống RAG-based agents trong môi trường sản xuất.

ByteByteGo77 Hot15 phútAI
How Uber Built a Genie to Answer Questions Correctly
Uber xây dựng Genie để xử lý câu hỏi của tài xế và hành khách. Hệ thống sử dụng Elasticsearch để tìm kiếm kiến thức từ 1.5 triệu tài liệu và kết nối với 60 service backend khác nhau. Phần xử lý ngôn ngữ tự nhiên (NLP) giúp Genie hiểu ngữ cảnh và trích xuất thông tin chính xác. Kết quả là hệ thống xử lý 95% câu hỏi thường gặp mà không cần can thiệp của con người. Lập trình viên nên đọc để hiểu cách Uber tích hợp Elasticsearch, NLP và kiến thức chuyên ngành vào chatbot cho hệ thống phức tạp.
Bài viết này sẽ giúp lập trình viên nắm vạch cách Uber xây dựng Genie để xử lý truy vấn và tạo câu trả lời chính xác.

Daily Dose of Data Science | Avi Chawla | Substack35 Hot10 phútAI
6 KV Cache Quantization Approaches
Bối cảnh về KV Cache Quantization trở nên quan trọng khi inference model lớn như GPT-3 cần …
Daily Dose of Data Science | Avi Chawla | Substack108 Hot6 phútAI
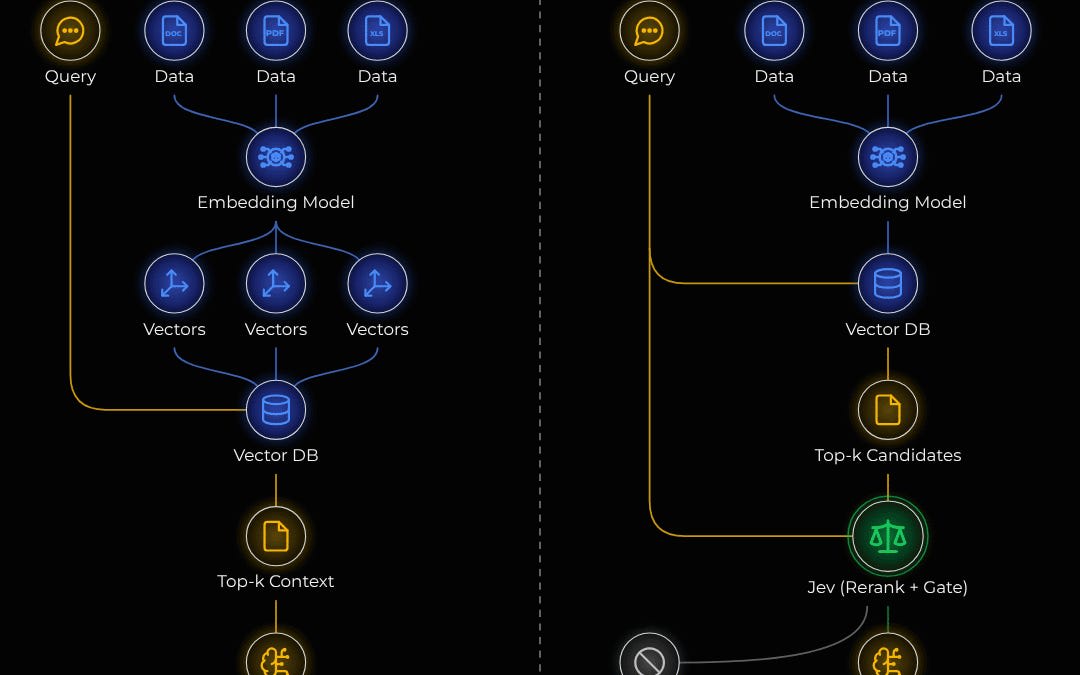
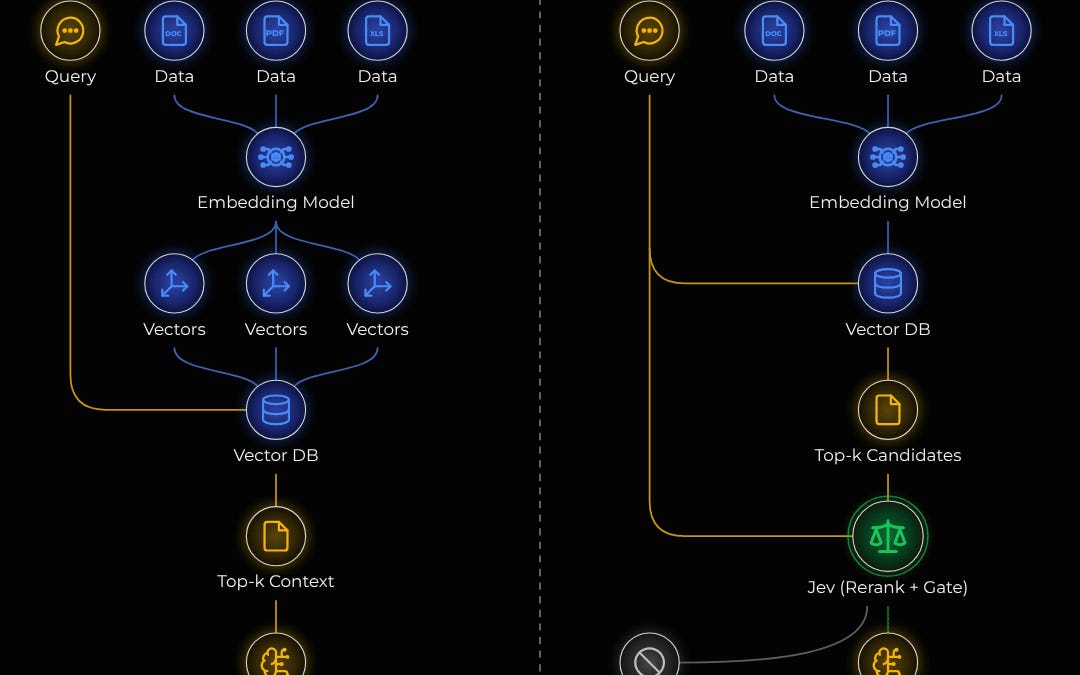
RAG vs. Jev + RAG, clearly explained!
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.

Flavio Copes61 Hot13 phútAI
What “open weights” means for AI models
Bối cảnh là khái niệm "open weights" đang định hình tương lai của AI models, khác biệt với mô hình open source truyền thống. Nguyên nhân kỹ thuật là open weights chỉ chia sẻ weights (các tham số mô hình) chứ không phải source code, cho phép sử dụng mô hình mà không cần phân tách nó. Hệ quả là Qwen3.8 của Alibaba và Kimi K3 của 01.AI chứng minh các mô hình open weights có thể đạt hiệu năng cao tương tự các closed-source models như GPT-4. Điều đáng học là open weights tạo ra một sân chơi bình đẳng hơn, nơi các công ty có thể tinh chỉnh và triển khai AI mà không bị phụ thuộc vào một nhà cung duy nhất. Xu hướng này mở ra cơ hội mới cho ứng dụng AI trong nhiều lĩnh vực với chi phí thấp hơn.
Bài này giúp lập trình viên hiểu rõ khái niệm "open weights" trong AI và sự khác biệt giữa nó với open source, qua các ví dụ thực tế như Qwen3.8 và Kimi K3.
Bình luận
Đang tải bình luận…