Đang tải bảng tin…

TechCrunch0 Hot0 bình luận1 phút đọc
Physical AI chip developer SiMa.ai hits $1.45B valuation
The edge computing startup raised a $150 million Series C led by Fidelity and Amplify.
Nguồn: https://techcrunch.com/2026/09/28/physical-ai-chip-developer-sima-ai-hits-1-45b-valuation. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

DEVCLASS1 Hot4 phút
PyTorch 2.15 tackles the 'one bad GPU' problem
PyTorch 2.15 ships a rewritten NCCL backend that stops a single failing GPU from forcing a full training restart. The new ProcessGroupNCCL allows only one communicator per process group during initialization, which by default eliminates the crosstalk that the old version's many communicators caused. A third-party orchestrator can now exclude a crashed or slow GPU and assign a replacement worker. A new 'flight recorder' captures operation snapshots for debugging stalls. The legacy backend remains as a rollback option but will be removed in 2.16, planned for early next year. The release also totals 3,117 commits from 583 contributors and includes parallel processing improvements for Apple gear and support for Nvidia's next-generation Blackwell GPUs.

XDA Developers125 Hot4 phútAI
I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B model faster than I can read
Một lập trình viên đã tìm ra cách chạy model Llama 35B trên laptop GPU chỉ 8GB VRAM với tốc độ đáng kinh ngạc. Nguyên nhân kỹ thuật nằm ở việc chỉnh sửa cờ n_gpu_layers trong llama.cpp, cho phép tận dụng hiệu quả bộ nhớ VRAM thay vì để nó trở thành điểm nghẽn. Hệ quả là model 35B parameters chạy nhanh đến mức người dùng không kịp theo dõi, vượt xa các kỳ vọng ban đầu về giới hạn phần cứng. Điều đáng học hỏi là đôi khi vấn đề không nằm ở cấu hình phần cứng mà ở cách tối ưu hóa phần mềm để khai thác tiềm năng thực sự của hardware.
Bài viết tiết lộ cách tối ưu hóa một cờ trong llama.cpp để chạy mô hình 35B trên GPU 8GB nhanh hơn tốc độ đọc của bạn.

Hacker News1 Hot6 phút
Nvidia Kubernetes Engine (NVKE)
NVIDIA Kubernetes Engine (NVKE). A management plane for GPU Kubernetes on bare metal. - dsx-ai-factory/nvke
Daily Dose of Data Science | Avi Chawla | Substack12 Hot9 phút
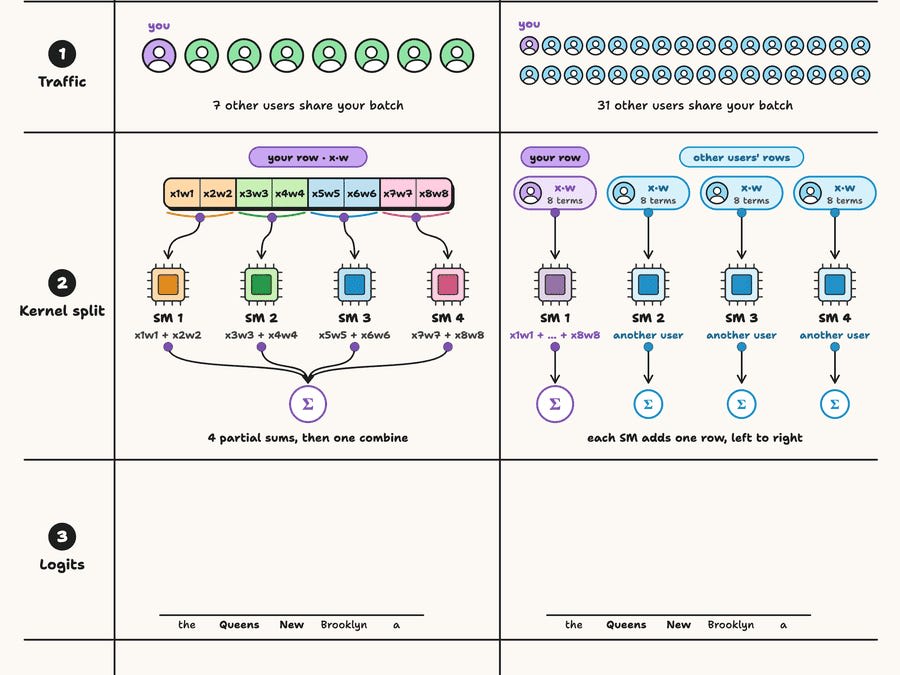
Why Other Requests Change Your LLM’s Output
+ an update on Harness Engineering 2.0.

XDA Developers1 Hot4 phút
I spent $500 to upgrade my aging gaming PC, and it beat buying a new one
A high-end GPU, a modern CPU, and 32GB of RAM
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 phútAI
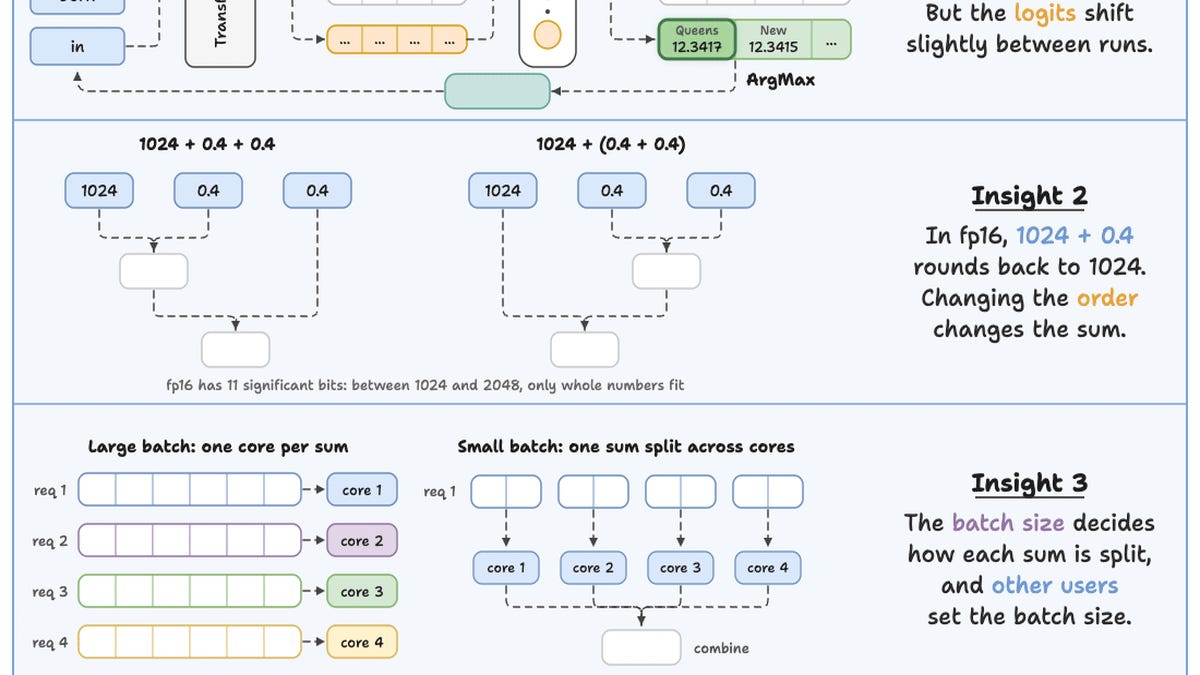
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

XDA Developers1 Hot4 phút
I challenged our new tool to build a gaming PC for less than $1,000, and it surprised me with the results
XDB Builder helps you plan your next build or upgrade

XDA Developers3 Hot5 phút
5 GPUs that are finally too old for modern games in 2026
Every good thing must come to an end
Bình luận
Đang tải bình luận…