Đang tải bảng tin…

InfoQ1 Hot0 bình luận4 phút đọc
TornadoVM 7 Enables GPU-Native Workloads From Java Applications
Tóm tắt bởi AI
TornadoVM 7 cho phép Java tận dụng GPU mà không cần code thủ công. Framework này tự động tối ưu hóa code Java cho cả CPU đa nhân và GPU. Phiên bản mới hỗ trợ đầy đủ GPU programming với tính năng mới là GPU-native workloads. TornadoVM giúp lập trình viên Java khai thác sức mạnh xử lý song song của GPU mà không cần học ngôn ngữ GPU-specific như CUDA hay OpenCL.
AI có thể tóm tắt sai. Đọc bài gốc trước khi dựa vào thông tin quan trọng.
Vì sao nên đọc: TornadoVM 7 cho phép lập trình viên Java tận dụng hiệu suất GPU mà không cần viết code phức tạp.
Bạn nhớ được gì?
Trả lời 3 câu hỏi ngắn để nhận điểm thưởng cho bài này. Chỉ làm khi bạn muốn lấy điểm.
tối đa +17 điểm
3 câu hỏi · dưới một phút · không bắt buộc
Nguồn: https://www.infoq.com/news/2026/10/tornadovm-7-gpu. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

ByteByteGo2 Hot14 phút
How Netflix Uses AI Agents for Performance Engineering
The Netflix engineering team has developed an autonomous performance agent system. In this article, we’ll be learning more about it.

XDA Developers1 Hot4 phút
I challenged our new tool to build a gaming PC for less than $1,000, and it surprised me with the results
XDB Builder helps you plan your next build or upgrade

Daily Dose of Data Science | Avi Chawla | Substack104 Hot7 phút
RAG vs. Vectorless RAG, clearly explained!
...explained visually (with tradeoffs in production).

Flavio Copes46 Hot6 phút
How to run an LLM locally
Run an LLM locally with Ollama. See how much memory you need, where LM Studio and llama.cpp fit, and how to call the model from code.

Medium1 Hot11 phút
From Shipping Features to Owning the P&L: My Technical PRD for an AI-Native Cloud & LLM FinOps Control Plane
From Shipping Features to Owning the P&L: My Technical PRD for an AI-Native Cloud & LLM FinOps Control Plane How I built a Java, ClickHouse, Kubernetes, and Prometheus gateway to stop “whale” …

XDA Developers122 Hot4 phútAI
I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B model faster than I can read
Một lập trình viên đã tìm ra cách chạy model Llama 35B trên laptop GPU chỉ 8GB VRAM với tốc độ đáng kinh ngạc. Nguyên nhân kỹ thuật nằm ở việc chỉnh sửa cờ n_gpu_layers trong llama.cpp, cho phép tận dụng hiệu quả bộ nhớ VRAM thay vì để nó trở thành điểm nghẽn. Hệ quả là model 35B parameters chạy nhanh đến mức người dùng không kịp theo dõi, vượt xa các kỳ vọng ban đầu về giới hạn phần cứng. Điều đáng học hỏi là đôi khi vấn đề không nằm ở cấu hình phần cứng mà ở cách tối ưu hóa phần mềm để khai thác tiềm năng thực sự của hardware.
Bài viết tiết lộ cách tối ưu hóa một cờ trong llama.cpp để chạy mô hình 35B trên GPU 8GB nhanh hơn tốc độ đọc của bạn.
Daily Dose of Data Science | Avi Chawla | Substack8 Hot9 phút
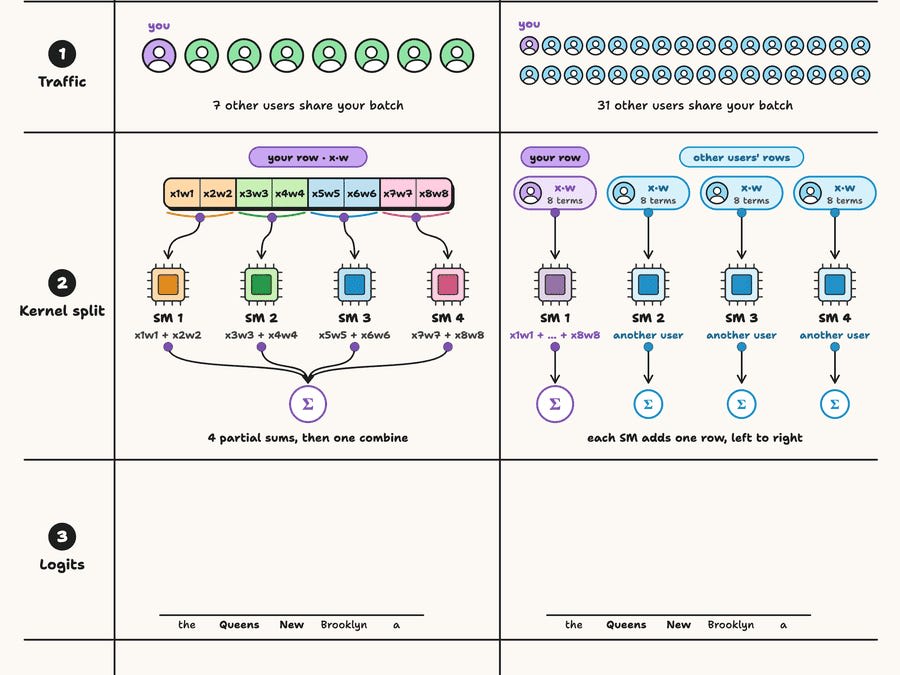
Why Other Requests Change Your LLM’s Output
+ an update on Harness Engineering 2.0.
Daily Dose of Data Science | Avi Chawla | Substack17 Hot9 phút
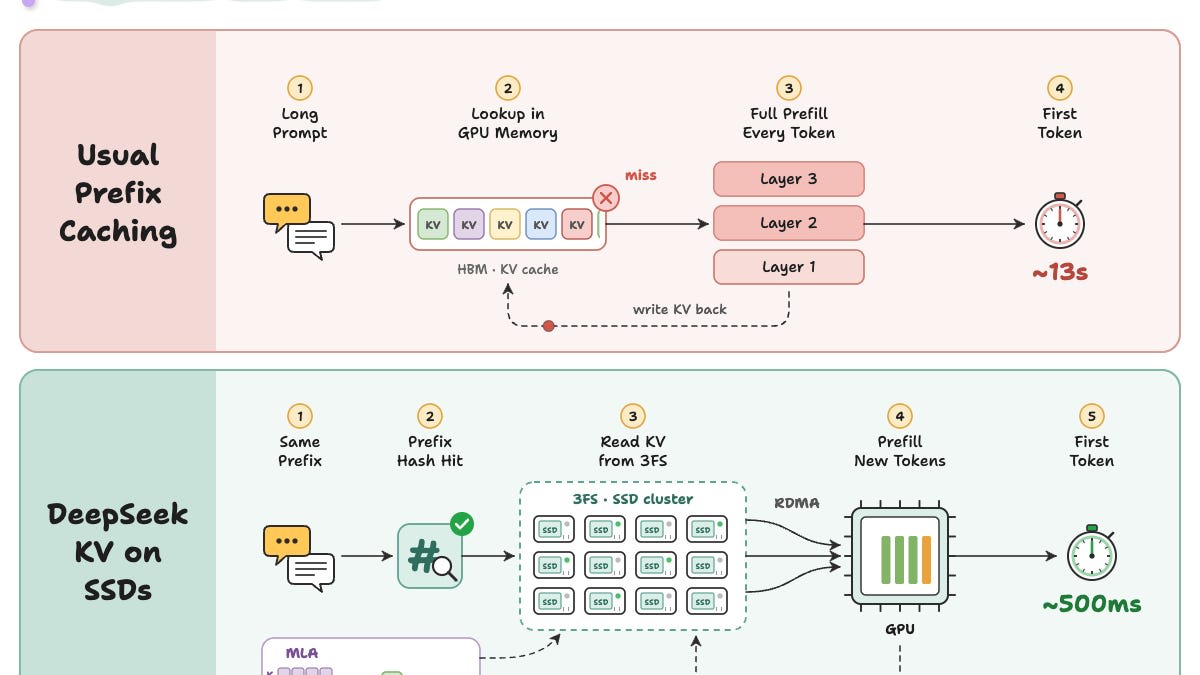
Why DeepSeek stores its KV cache on disk
DeepSeek's engineering behind 26x faster time to first token.
Bình luận
Đang tải bình luận…