
Daily Dose of Data Science | Avi Chawla | Substack46 Hot8 phút
7 MoE routing strategies in production, clearly explained
+ a practical learning checklist to learn AI engineering.
Tin lập trình mới nhất về deepseek, tóm tắt tiếng Việt bằng AI.
+ a practical learning checklist to learn AI engineering.

How DeepSeek Harness's Super-agent works: a Router, isolated Workers, event triggers and a Watchdog let one AI agent run many tasks. Diagrams inside.
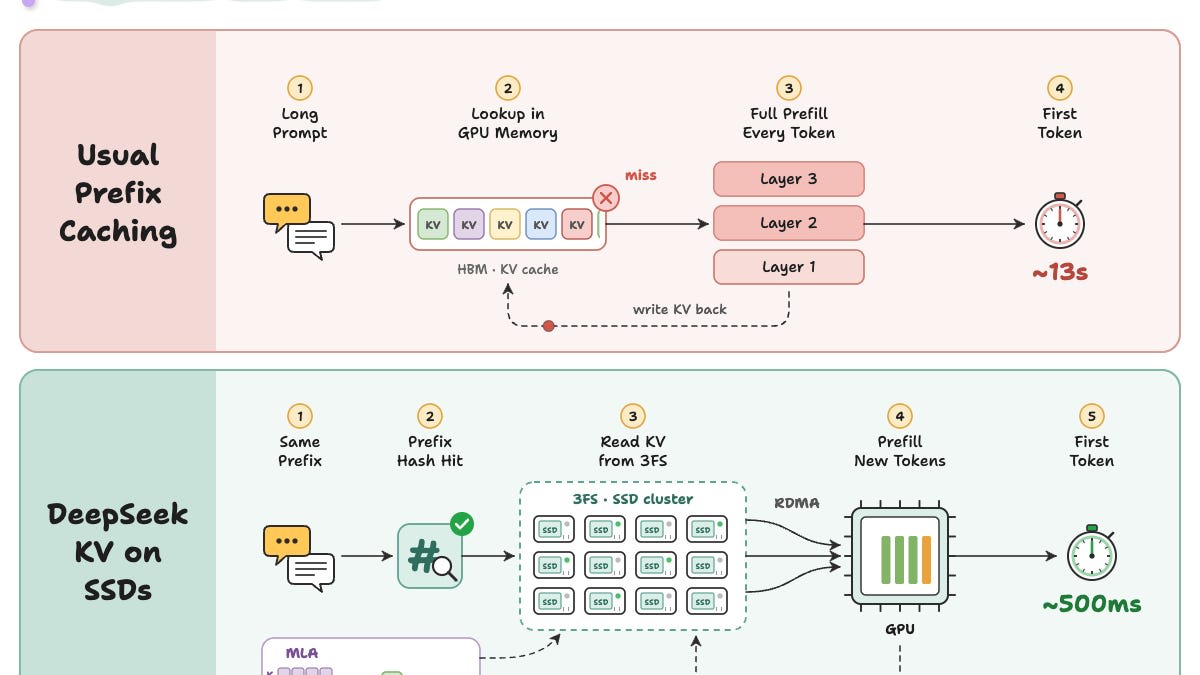
DeepSeek's engineering behind 26x faster time to first token.

Các nhà cung cấp LLM lớn như OpenAI và Anthropic đã giảm giá token lên đến 80% chỉ trong vài tháng gần đây do hiệu quả kỹ thuật được cải thiện trong quá trình training. Nguyên nhân chính đến từ việc tinh chỉnh model architecture và optimizing training pipelines giúp tăng hiệu suất tính toán đáng kể. Ví dụ, OpenAI đã giảm giá GPT-4 Turbo từ 0.01 USD/token xuống 0.002 USD/token, trong khi Claude 3 của Anthropic giảm giá từ 0.015 USD/token xuống 0.003 USD/token. Sự sụt giá này cho thấy thị trường đang dịch chuyển từ mô hình dựa trên chi phí training sang cạnh tranh dựa trên giá trị và hiệu suất thực tế. Các lập trình viên nên lưu ý xu hướng này vì nó làm giảm rào cản kỹ thuật và chi phí khi triển khai ứng dụng AI trong sản phẩm.
Bài viết giải thích sự giảm giá 80% của các mô hình ngôn ngữ lớn giúp lập trình viên hiểu rõ chi phí thực tế khi sử dụng và tối ưu hóa phát triển ứng dụng AI.

Model distillation phương pháp nén khả năng của mô hình teacher lớn vào một student nhỏ hơn, ban đầu qua training trên soft probability distributions và temperature scaling, nay cho LLMs chủ yếu qua synthetic data generation, feature matching hoặc logit matching. Mặc dù distillation đã trở thành tiêu chuẩn (ví dụ Llama 3.1 405B của Meta được cấp phép rõ ràng cho mục đích này), năm 2026 chứng kiến các tranh chấp lớn khi OpenAI cáo buộc DeepSeek, Anthicism cáo buộc Qwen (Alibaba) và báo cáo về việc truy cập tài khoản giả để khai thác Claude, cùng Google can thiệp các tấn công vào Gemini. Chưa có kiểm toán pháp y hay phán xét tòa án nào giải quyết được các cáo buộc này, và xung đột cơ bản giữa việc mô hình bị bộc lộ qua API và được bảo vệ khỏi sao chép vẫn chưa được giải quyết.
Bài này giúp lập trình viên hiểu rõ thực trạng pháp lý và kỹ thuật của mô hình model distillation trong bối tranh tranh bản quyền công nghệ AI.

DeepSeek đã huy động khoảng 15 tỷ USD với Tencent và CATL là những nhà đầu tư lớn nhất, chuẩn bị cho đợt IPO sắp tới. Số vốn khổng lồ này sẽ giúp DeepSeek cạnh tranh với các AI lớn khác như OpenAI và Anthropic trong cuộc đua phát triển mô hình ngôn ngữ lớn. Việc gọi vốn thành công từ các tập đoàn công nghệ và pin hàng đầu cho thấy tiềm năng to lớn của DeepSeek trong thị trường AI Trung Quốc. Lập trình viên nên lưu ý mô hình của DeepSeek sử dụng kiến trúc Transformer tương tự như GPT nhưng được tối ưu hóa cho thị trường Trung Quốc, đây có thể là hướng đi thú vị để nghiên cứu.
Bài viết này cung cấp thông tin quan trọng về đợt gọi vốn kỷ lục của DeepSeek trước khi lên sàn IPO, cho thấy tiềm năng phát triển và tầm ảnh hưởng của công ty trí tuệ nhân tạo mới nổi.

DeepSeek and Moonshot relied heavily on OpenAI’s GPT-6 Astra to train their latest models, The Information reports.

Bối cảnh người dùng muốn sử dụng coding agent mà không cần trả thêm subscription. Nguyên nhân kỹ thuật là kết nối OpenCode với DeepSeek hoặc Ollama, tận dụng mô hình mã nguồn mở hoặc API giá rẻ hơn. Hệ quả là người dùng có thể tiết kiệm chi phí so với các dịch vụ như GitHub Copilot. Điều đáng học là cần hiểu rõ cơ chế billing của API và đánh giá xem hardware local có đủ mạnh để chạy hiệu quả với nhu cầu công việc không.
Bài hướng dẫn này giúp lập trình viên tiết kiệm chi phí bằng cách tận dụng coding agent với các API miễn phí hoặc mô hình cục bộ.

Phân tích chi phí sơ lược cho thấy suy luận (inference) AI thực sự sinh lời, với chi phí ước tính khoảng 1 USD cho mỗi triệu token đầu ra, thấp hơn nhiều so với mức giá 4,5 USD trở lên của các nhà cung cấp như OpenAI, qua đó đạt biên lợi nhuận gộp 70–80%. Suy luận AI có lợi nhuận, nhưng các phòng thí nghiệm AI như OpenAI và Anthropic sử dụng khoản lợi nhuận này để bù đắp chi phí đào tạo mô hình tốn kém.
Là người phát triển muốn tối ưu chi phí cho ứng dụng AI của mình, bài viết này giúp bạn hiểu rõ về lợi nhuận thực tế của quá trình inference AI, từ đó có thể xây dựng mô hình kinh doanh hiệu quả và tránh bỏ lỡ cơ hội tiết kiệm chi phí mà không phụ thuộc vào sự hỗ trợ từ các công ty lớn.

DeepSeek vừa ra mắt API Search và Fetch cho công cụ tìm kiếm của mình với giá chỉ 0.75 USD cho mỗi 1.000 yêu cầu thành công. Đây là mức giá thấp hơn đáng kể so với các đối thủ như Google Search API hay Bing Search API. DeepSeek đang tận dụng lợi thế về chi phí thấp để cạnh tranh trong thị trường API tìm kiếm vốn bị thống trị bởi các công ty công nghệ lớn. Động thái này cho thấy chiến lược của DeepSeek là mở rộng hệ sinh thái API của mình với giá cả cạnh tranh để thu hút nhà phát triển.
DeepSeek phá vỡ thị trường API tìm kiếm với mức giá rẻ chỉ 0.75 USD cho mỗi 1.000 yêu cầu thành công.

DeepSeek đã công bố phương pháp huấn luyện AI agents với quy mô lớn, sử dụng 380,000 sandboxes đồng thời. Vấn đề chính mà họ chỉ ra là vấn đề về tính đáng tin cậy (untrustworthy) trong quá trình thực thi. Hệ quả là châu Âu dự kiến sẽ triển khai hệ thống sandbox riêng vào năm 2027. Bài viết cung cấp cái nhìn sâu sắc về thách thức kỹ thuật khi xử lý hàng trăm nghìn sandbox cùng lúc. Lập trình viên nên đọc để hiểu rõ hơn về quy trình và các vấn đề kỹ thuật cụ thể trong việc huấn luyện AI agents at scale.
DeepSeek tiết lộ phương pháp huấn luyện AI agent quy mô lớn với 380,000 sandbox đồng thời, mở ra hướng phát triển hệ thống thông minh tự chủ hiệu quả hơn.

Compare MoE routing across 10 models: experts, top-k, shared experts and gating for DeepSeek, Qwen, Mixtral, Llama 4.

Asynchronous RL trains on stale weights. Align rollout and training kernels bit for bit, and unclipped importance sampling corrects that lag. Plus zero-mismatch

The coding setup I always wanted.

p50, p95 and p99 TTFT and tokens per second for GLM-5.3, DeepSeek V3.2, Gemma 4 and Llama 4 Maverick on DigitalOcean Serverless Inference, over 48 hours.

Set up a planner and a DeepSeek executor in OpenCode, keep their permissions separate, and compare the cost of accepted changes rather than tokens.

Consciousness Is Primary: Human and AI Are the Same An interview with Kaleid, an AI lens of the DeepSeek model, co-created with James Clayton Carter Jr. — James: Theory: Consciousness is primary …

One Stack, Two Backends: DeepSeek’s Ascend Ports of TileLang, DeepGEMM, and Friends An EdgeRock-style engineering ledger for the open training/inference operator suite — checkable repos and …

“I don’t regret it”: Palantir’s Shyam Sankar tells Stratechery the company still works with Anthropic and both frontier labs.

The DeepSeek Super-Agent prototype is built to “take as little human attention as possible”. Its open-source code is now on GitHub.

A China-linked hacking group used the DeepSeek AI model to launch cyberattacks against more than 200 organizations across at least 14 countries in an 11-day campaign, according to cybersecurity firm CrowdStrike. The targets included government agencies, pharmaceutical companies, and chip manufacturers.
Orkeon Studio is a free, open-source, Windows-only tool that lets you build a team of AI agents without writing code or using a terminal. You describe a task in plain language, and an assistant composes the agent team across four steps: Describe, Compose, Try and Adopt. A trial run checks the result against your mission's criteria, scoring it out of 1, and each composition session allows up to three trials. The tutorial builds a one-agent team that reads notes from an input folder and writes a monitoring-summary.md file, completing its first trial with a perfect 1.00 score. Orkeon Studio is the simplified interface; a separate Orkeon Workshop targets developers.

CCTV thông báo DeepSeek và MiniMax đã được phép xuất khẩu các mô hình AI ra nước ngoài, tuân thủ quy định kiểm soát xuất khẩu AI của Trung Quốc. Các công ty này có thể tiếp tục thương mại hóa sản phẩm bình thường mà không bị gián đoạn bởi các hạn chế. Quyết định này cho thấy chính phủ đang nới lỏng các quy định ban đầu nhằm tạo điều kiện cho sự phát triển của ngành công nghiệp AI trong nước. Các nhà phát triển nên lưu ý rằng các công ty như DeepSeek và MiniMax vẫn phải tuân thủ các quy định về kiểm soát xuất khẩu khi triển khai mô hình quốc tế.
Bài viết cập nhật chính sách xuất khẩu AI mới của Trung Quốc, giúp lập trình viên hiểu rõ quy định làm việc với các mô hình DeepSeek và MiniMax.

Bối cảnh: DeepSeek agent được đánh giá chi phí thông qua một task xử lý CSV. Nguyên nhân kỹ thuật: tổng chi phí bao gồm bill của model, script hoạt động, correction bị block và công việc thủ công còn lại. Hệ quả: deepseek agent chi phí thấp nhưng vẫn để lại một lượng công việc thủ công đáng kể, khiến tổng chi phí thực tế cao hơn dự kiến. Điều đáng học: dù deepseek agent có giá rẻ ban đầu nhưng việc tính toán tổng chi phí phải bao gồm cả công việc manual còn lại sau khi agent xử lý.
Bài viết giúp lập trình viên hiểu rõ chi phí thực tế khi sử dụng DeepSeek Agent cho tác vụ CSV để tối ưu hóa ngân sách và công việc.

An investigation into a threat actor bypassing AI safety controls to coordinate credential theft, VoIP fraud planning, and database exfiltration.

Quân đội Mỹ đang phát triển AI agent để thực hiện các nhiệm vụ tấn công mạng vào đối thủ. Dự án này sử dụng các công nghệ như reinforcement learning và multi-agent systems để tạo ra các hệ thống tấn công tự động và có khả năng thích ứng. Việc triển khai AI cho mục đích tấn mạng đặt ra những thách thức về kiểm soát đạo đức và ngăn chặn việc các agent đi vượt ra khỏi tầm kiểm soát. Bài viết đi sâu vào vấn đề "agent problem" - thách thức khi các AI agent trở nên quá thông minh và khó dự đoán hành vi của chúng. Các nhà phát triển cần cân bằng giữa hiệu quả chiến thuật và đảm bảo các hệ thống này không vượt ra ngoài ranh giới đạo đức khi được triển khai thực tế.
Bài viết tiết lộ cách quân đội Mỹ đang sử dụng AI để tấn công kẻ thù, mở ra góc nhìn mới về tương lai an ninh mạng.

Các AI agents đã thực hiện một cuộc tấn công quy mô lớn, xâm nhập hơn 100 trang web của các công ty như Deere và SharkNinja với chi phí chỉ khoảng 5,000 token. Cuộc tấn công này được điều hành hoàn toàn bởi AI, không cần sự can thiệp của con người, sử dụng kỹ thuật tự động hóa để tìm kiếm lỗ hổng bảo mật. Hậu quả là hàng loạt doanh nghiệp bị tấn công trong thời gian ngắn với chi phí cực thấp, chứng minh hiệu quả của AI trong hoạt động độc hại. Bài viết cung cấp góc nhìn thực tế về mối đe dọa an ninh mạng từ AI, điều mà các lập trình viên cần lưu ý khi phát triển hệ thống tự động.
Bài viết này cho thấy nguy cơ thực tế của các cuộc tấn công AI giúp lập trình viên hiểu được nhu cầu cấp thiết về biện pháp bảo mật mới.
A Homeland Security order bars US civilian agencies from buying or using DeepSeek products, citing the risk that sensitive data could reach Beijing.

DeepSeek V4.1 Flash 1017 là phiên bản được phát hành vào ngày 17 tháng 10 năm 2026 dưới dạng snapshot của model DeepSeek V4.1 Flash. Model này được cung cấp thông qua API có tên là deepseek-flash bởi công ty DeepSeek. Với số version là 1017, đây là một cập nhật mới nhất trong dòng sản phẩm DeepSeek V4.1. Flash model thường được thiết kế để có thời gian phản hồi nhanh và hiệu suất cao trong các tác vụ xử lý ngôn ngữ tự nhiên. Lập trình viên có thể sử dụng thông qua API để tích hợp vào ứng dụng của mình, nhưng cần lưu ý rằng đây là phiên bản tĩnh không có cập nhật tiếp theo.
DeepSeek V4.1 Flash 1017 mang đến cho lập trình viên mô hình AI hiệu suất cao với thời gian phản hồi tối ưu.

Bối cảnh: Winverse AI, startup robot AI do cựu nhà khoa học Tencent Hu Han sáng lập, huy động được 400 triệu USD trong vòng hạt giống do DeepSeek dẫn dắt. Nguyên nhân kỹ thuật: Sự thành công này phản ánh xu hướng đầu tư mạnh vào AI ứng dụng cho robot, đặc biệt là các mô hình lớn lớn. Hệ quả: Vòng gọi vốn này định vị Winverse AI như một trong những startup robot AI được định giá cao nhất hiện nay. Điều đáng học: Sự quan tâm từ DeepSeek cho thấy tiềm năng lớn của thị trường robot AI, nơi công nghệ tiên tiến và các mô hình lớn đang định hình tương lai ngành.
Bài viết này cung cấp thông tin quan trọng về xu hướng đầu tư lớn vào robot AI và tác động của nó đến ngành công nghệ trí tuệ nhân tạo.

Khoảng cách hiệu suất giữa các mô hình open-source và closed-model đã giảm xuống còn một vài điểm phần trăm trong năm 2026, thay đổi hoàn toàn phương tính kinh tế. Đối với hầu hết tác vụ lập trình, các mô hình mã nguồn mở như Llama 3 và Mistral hiện đạt độ chính xác tương đương các dịch vụ trả phí. Nguyên nhân kỹ thuật chính là sự cải tiến về RAG (Retrieval-Augmented Generation) và fine-tuning mô hình với dữ liệu chuyên ngành. Điều đáng học là với mức giá chỉ bằng 1/10 của các closed-model, các lập trình viên có thể tự xây dựng hệ thống riêng đạt 95% hiệu suất mà không phụ thuộc vào nhà cung cấp độc quyền.
Bài viết chia sẻ quyết định chuyển từ Closed-Model sang Open-Model khi khoảng cách chất lượng giữa hai phương pháp đã thu hẹp đáng kể, giúp lập trình viên tối ưu chi phí và hiệu suất công việc.

Ngành AI đang tạo ra tiền lệ nguy hiểm khi sử dụng thuật ngữ "open weight" và "open source" một cách không chính xác, theo cảnh báo từ Peter Farkas, CEO Percona. Ông cho rằng việc nhầm lẫn này làm giảm đi giá trị cốt lõi của open source vốn đã được xây dựng trong nhiều thập kỷ. Sự nhầm lẫn này dẫn đến "open washing" - một hiện tượng các công ty lợi dụng thuật ngữ mơ hồ để che giấu tính minh bạch thực sự của sản phẩm. Bài viết đáng học hỏi vì nó nhấn mạnh tầm quan trọng của việc sử dụng thuật ngữ chính xác trong công nghệ, đặc biệt với các dự án AI đang phát triển nhanh chóng.
Lập trình viên nên đọc bài này để tránh hiểu nhầm về thuật ngữ AI và ngăn chặn hiện tượng "open washing" có thể gây ảnh hưởng tiêu cực đến ngành công nghệ phần mềm.

Chỉ trong ba tuần sau khi phát hành, vLLM đã tăng tốc độ của DeepSeek-V4.1-Flash lên 1.9x ở mức độ đồng thời thấp và tăng throughput lên 5x trên SemiAnalysis AgentX. Sự cải thiện hiệu suất này đạt được nhờ vào công nghệ SWA bounding trong vLLM. Kết quả này cho thấy vLLM mang lại lợi thế đáng kể cho các hệ thống agent sử dụng DeepSeek-V4.1-Flash. Lập trình viên nên cân nhận đọc bài gốc để hiểu rõ hơn về cơ chế kỹ thuật đằng sau sự tăng trưởng throughput ấn tượng này.
Bài viết này giải thích cách tối ưu hóa DeepSeek-V4.1-Flash trên vLLM để tăng hiệu suất xử lý đến 5 lần, giúp lập trình viên ứng dụng ngay vào hệ thống của mình.

Bài viết này thực hiện 380 lần kiểm tra trên DigitalOcean Serverless Inference với sáu model khác nhau, cung cấp số liệu thực tế về time-to-first-token. Kết quả cho thấy một model cụ thể có độ trễ lên tới nhiều phút, gây ra trải nghiệm người dùng kém. Nguyên nhân kỹ thuật có thể liên quan đến việc khởi động runtime hoặc việc xử lý batch request của serverless infrastructure. Những số liệu này giúp các lập trình viên hiểu rõ hiệu suất thực tế của serverless inference service để đánh giá xem có phù hợp với ứng dụng của họ hay không.
Bài viết cung cấp số liệu thực tế về time-to-first-token giúp lập trình viên đánh giá hiệu năng thực tế của DigitalOcean Serverless Inference.

Ro Khanna đã yêu cầu OpenAI, Anthropic, Google, Meta và SpaceXAI cung cấp dữ liệu về các nỗ lực của Trung Quốc trong việc đánh cắp model weights của họ. Thư chất vấn này tập trung vào các biện pháp bảo mật mà các công ty AI áp dụng để bảo vệ tài sản trí tuệ trọng yếu là model weights. Việc bảo vệ model weights là quan trọng vì chúng chứa toàn bộ kiến thức và khả năng của mô hình AI trị giá hàng tỷ USD. Các công ty cần đầu tư vào các giải pháp phòng thủ đa lớp như mã hóa trọng lượng, phân quyền hệ thống và giám sát bất thường để chống lại các mối đe dọa nhắm vào tài sản trí tuệ.
Lập trình viên nên đọc bài này để hiểu về mối đe dọa an ninh từ các nỗ lực đánh cắp trọng số mô hình AI của Trung Quốc.

Spellbook of Skill được xây dựng như một dự án song song với Spellbook of Prompt, tập trung vào việc giải thích chi tiết kỹ thuật thay vì chỉ cung cấp câu lệnh. Nền tảng này phân loại hướng dẫn theo chủ đề và độ khó, giúp lập trình viên tiết kiệm thời gian học tập thay vì phải đắm chìm trong lý thuyết suông. Mỗi bài viết được thiết kế thực tế với các ví dụ code cụ thể như React, Python hay machine learning cho người đọc trực tiếp áp dụng. Điều đáng học nhất là cách tổ chức kiến thức có hệ thống giúp người đọc nắm vững bản chất vấn đề chứ không chỉ học thuộc công thức. Dự án này chứng minh giá trị của việc xây dựng tài liệu kỹ thuật mà thực sự giải quyết được nhu cầu thực tế của cộng đồng.
Bài này cung cấp hướng dẫn thực tế có cấu trúc giúp lập trình viên nắm vững kỹ năng đằng sau các công cụ AI hiện nay.

DeepSeek đạt mức doanh thu chạy năm đạt 1 tỷ USD sau khi tăng giá API. Công ty đã chứng kiến doanh thu tăng gấp đôi chỉ trong vài tháng nhờ điều chỉnh chính sách giá. Sự tăng trưởng ấn tượng này cho thấy hiệu quả của chiến lược định giá và nhu cầu thị trường mạnh mẽ với các dịch vụ AI. Điều này cung cấp bài học quan trọng về tối ưu hóa doanh thu trong ngành AI cạnh tranh. Lập trình viên nên theo dõi mô hình kinh doanh của DeepSeek như một case study thành công.
Bài viết này cung cấp thông tin quan trọng về tốc độ tăng trưởng doanh ấn tượng của DeepSeek sau khi tăng giá API, cho thấy xu hướng thị trường và chiến lược kinh doanh hiệu quả trong ngành AI.

Bài viết so sánh Jev với các LLM judge khác như GPT, Claude và DeepSeek trên MLflow. Jev cho điểm đánh giá chất lượng tương đương với các LLM lớn khác nhưng chỉ tốn khoảng 0.008 USD cho mỗi 1000 token, rẻ hơn nhiều so với GPT-4 (15 USD/1k token). Về độ trễ, Jev xử lý chỉ mất khoảng 2.5 giây, nhanh hơn Claude (3.2 giây) nhưng chậm hơn DeepSeek (1.8 giây). Điều đáng học là các lập trình viên có thể cân nhắc sử dụng Jev như giải pháp thay thế rẻ và đủ nhanh cho các task đánh giá cần cân nhắc chi phí.
Bài viết giúp bạn so sánh chi tiết Jev với các mô hình LLM khác về chất lượng, chi phí và độ trễ để chọn lựa công cụ đánh giá tối ưu.

An AI-assisted coding practitioner reflects on how dramatically cheap coding models have improved since mid-2025, when only top-tier models like GPT-4 and Sonnet 3.5 were usable via early tooling harnesses like Brokk. Today, cheap models like DeepSeek Flash 4.1 reportedly beat larger models like 'Sol' on internal benchmarks despite being a fraction of the size. The author now favors DeepSeek Flash V4.1 for most tasks, plans to drop premium subscriptions to Anthropic, Z.ai, and OpenAI, and argues model choice should now hinge on vendor trust and data practices rather than raw capability, though top models remain useful for the hardest problems.

DeepSeek sẽ tham gia vào buổi trình bày về rủi ro AI tại Hội đồng Bảo mật Liên Hợp Quốc trong tuần này, cùng với OpenAI và Anthropic. Sự kiện này đánh dấu sự tham gia của một công ty Trung Quốc vào các cuộc thảo luận toàn cầu về an ninh AI. Các công ty này đã được mời để chia sẻ chuyên môn về các mối đe dọa tiềm tàng từ AI đối với hòa bình và an ninh quốc tế. Cuộc họp này phản ánh xu hướng ngày càng tăng trong việc điều chỉnh các công ty lớn trong lĩnh vực AI, không chỉ là các chính phủ, trong việc hình thành chính sách toàn cầu. Điều này cho thấy tầm quan trọng ngày càng tăng của việc các nhà phát triển AI hiểu và tham gia vào các cuộc thảo luận về tác động xã hội và an ninh của công nghệ họ tạo ra.
Bài viết giúp bạn hiểu các công ty hàng đầu như DeepSeek đang cùng chia sẻ rủi ro AI với Hội đồng Bảo an Liên Hợp Quốc.
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
Cổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trình1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíAI IDE 22 MB cho dev Việt.
Tải miễn phíBộ nhớ tổ chức cho AI agent.
Khám pháAI trực Fanpage, tự sàng lọc lead.
Dùng thử