Đang tải bảng tin…

Phoronix0 Hot0 bình luận1 phút đọc
Vulkan 1.4.363 Released With New VK_INTEL_device_info Extension
Vulkan 1.4.363 has been released with spec clarifications, various fixes, and new multi-instance validation usage rules for DMA-BUF external memory in VkMemoryAllocateInfo and VkMemoryGetFdInfoKHR. The release also introduces VK_INTEL_device_info, a new Intel vendor extension that lets applications query the graphics IP block version of an Intel GPU directly, indicating architecture generation, release, and hardware revision, removing the need for apps and games to maintain manual device ID lookup tables.
Nguồn: https://www.phoronix.com/news/Vulkan-1.4.363. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

XDA Developers120 Hot4 phútAI
I changed one llama.cpp flag, and my 8GB laptop GPU now runs a 35B model faster than I can read
Một lập trình viên đã tìm ra cách chạy model Llama 35B trên laptop GPU chỉ 8GB VRAM với tốc độ đáng kinh ngạc. Nguyên nhân kỹ thuật nằm ở việc chỉnh sửa cờ n_gpu_layers trong llama.cpp, cho phép tận dụng hiệu quả bộ nhớ VRAM thay vì để nó trở thành điểm nghẽn. Hệ quả là model 35B parameters chạy nhanh đến mức người dùng không kịp theo dõi, vượt xa các kỳ vọng ban đầu về giới hạn phần cứng. Điều đáng học hỏi là đôi khi vấn đề không nằm ở cấu hình phần cứng mà ở cách tối ưu hóa phần mềm để khai thác tiềm năng thực sự của hardware.
Bài viết tiết lộ cách tối ưu hóa một cờ trong llama.cpp để chạy mô hình 35B trên GPU 8GB nhanh hơn tốc độ đọc của bạn.
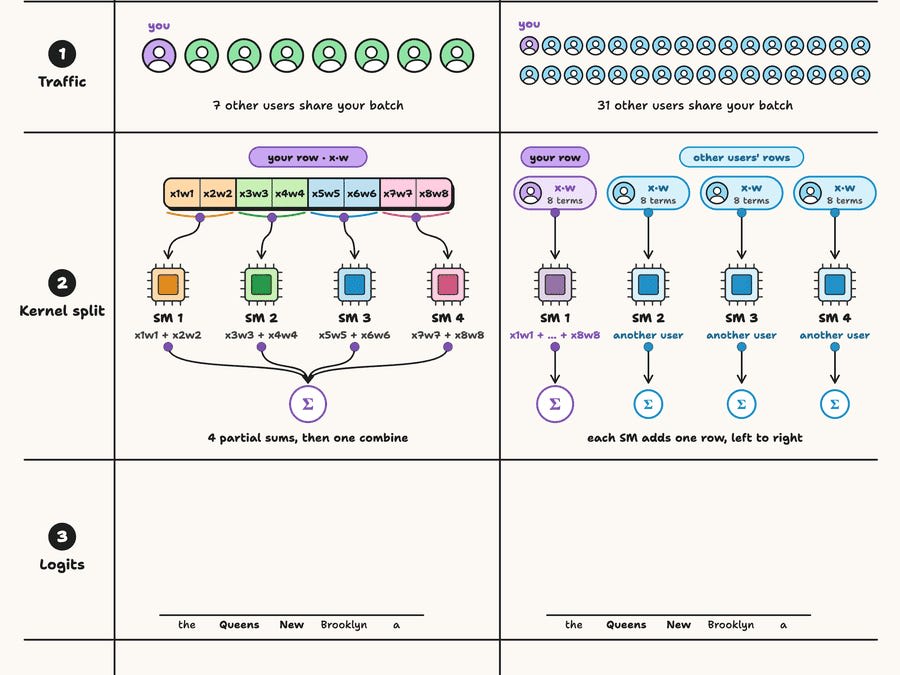
Daily Dose of Data Science | Avi Chawla | Substack8 Hot9 phút
Why Other Requests Change Your LLM’s Output
+ an update on Harness Engineering 2.0.
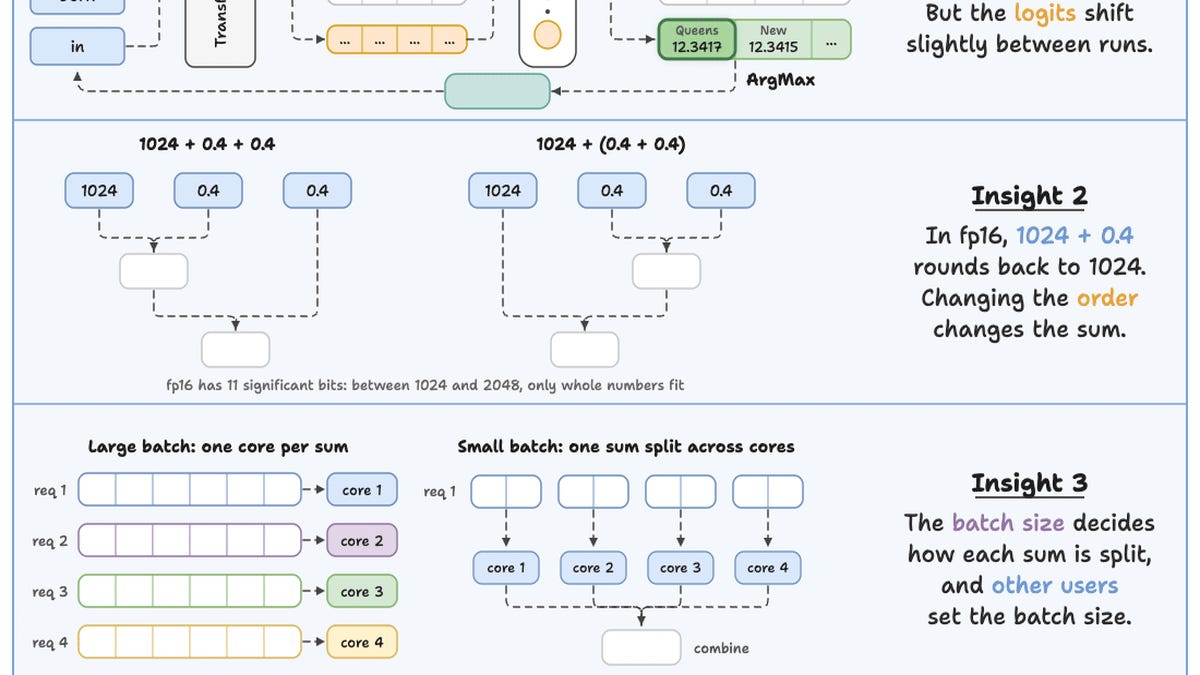
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 phútAI
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.


XDA Developers3 Hot5 phút
5 GPUs that are finally too old for modern games in 2026
Every good thing must come to an end

Google Developers37 Hot1 phútAI
Colab is now part of your Google AI plan
Google vừa tích hợp Colab vào Google AI plan, mang lại lợi ích cao cấp cho người đăng ký. Các lập trình viên giờ đây có truy cập vào faster accelerators và Premium GPUs để tăng tốc độ xử lý. Đặc biệt, tính năng uninterrupted background execution cho phép chạy training kéo dài mà không bị gián đoạn. Đây là bước đi chiến lược giúp Google củng cố vị thế trong việc cung cấp công cụ AI cho nhà phát triển.
Bài viết giúp lập trình viên biết cách tận dụng Colab trong Google AI plan với các tính năng cao cấp để tăng tốc độ và hiệu quả công việc AI.

The Next Web8 Hot2 phútAI
TSMC is open to working on Musk’s Terafab but says it must run the fab
TSMC đang thảo luận với Elon Musk về dự án Terafab nhưng khẳng định bất kỳ nhà máy nào cũng phải do TSMC vận hành. Musk muốn tự mình kiểm soát hoạt động của nhà máy semiconductor này. Giám đốc điều hành C.C. Wei của TSMC nhấn mạnh TSMC sẽ không chấp nhận để bên thứ ba điều hành. Sự bất đồng trong cách quản lý có thể là trở ngại lớn cho việc hợp tác giữa hai bên.
Bài viết này giúp lập trình viên hiểu rõ quan điểm của TSMC về việc hợp tác với Musk trong dự án Terafab.

NVIDIA Developer48 Hot13 phútAI
Introducing CUDA Rust: Two Tracks for Writing GPU Kernels
Vào tháng 9 năm 2026, NVIDIA đã công bố định hướng lập trình GPU gốc bằng Rust. Công ty đang phát triển hai hướng tiếp cận riêng cho CUDA Rust, cạnh tranh với các công cụ trưởng thành như CUDA C++ và CUDA Python. Việc này giải quyết nhu cầu về ngôn ngữ an toàn bộ nhớ hơn cho lập trình GPU, vốn hiện chủ yếu dựa vào C++. Lập trình viên nên cân nhắc track phù hợp giữa Rust CUDA Compiler (RCC) và Rust-CUDA crate tùy thuộc vào nhu cầu dự án. Sự phát triển này đánh dấu bước tiến quan trọng khi Rust đang dần trở thành lựa chọn thay thế cho C++ trong các hệ thống hiệu năng cao.
Bài này giúp lập trình viên Rust nắm bắt hướng đi mới của NVIDIA cho lập trình GPU native.
Bình luận
Đang tải bình luận…