Đang tải bảng tin…

DevBlogs0 Hot0 bình luận10 phút đọc
Why content extraction still matters in the GenAI era
Learn why stronger AI models make trustworthy content extraction more important, how Azure Content Understanding and Azure Document Intelligence serve different needs, and what comes next.
Nguồn: https://devblogs.microsoft.com/foundry/why-content-extraction-still-matters-in-the-genai-era. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

OpenSearch1 Hot14 phútAI
Beyond Top-K: Building search-confidence guardrails for agentic AI with OpenSearch
Top-K retrieval trong agentic AI luôn trả về kết quả ngay cả khi không có gì phù hợp, gây hiểu lầm. Cần xây dựng một confidence layer trên OpenSearch để agent có thể định lượng và kiểm tra ngưỡng kết quả. Phương pháp này cho phép agent từ chối đưa ra câu trả lời khi độ tin cậy thấp. Bài viết chi tiết cách triển khai confidence scoring sử dụng vector similarity metrics và ngưỡng threshold linh hoạt. Lập trình viên nên đọc để biết cách xử lý cases where no good answers exist trong hệ thống AI thực tế.
Bài này giúp bạn giải quyết vấn đề trả lời kết quả không liên quan khi sử dụng Top-K retrieval trong agentic AI bằng cách xây dựng lớp độ tin cậy với OpenSearch.

Zalando22 Hot16 phútAI
Automating Data Ingestion with a RAG Flywheel
Việc tự động hóa mapping schema cho dữ liệu nhà cung cấp đa dạng đang là thách thức lớn trong integration platforms. Một nghiên cứu mới áp dụng RAG Flywheel với LLMs để giải quyết vấn đề này, giúp giảm 70% thời gian xử lý dữ liệu so với phương pháp thủ công. Cụ thể, kiến trúc Retrieval-Augmented Generation (RAG) kết hợp với vector embeddings cho phép hiểu và chuyển đổi schema tự động, đồng thời cải thiện chất lượng qua mỗi vòng feedback loop. Hệ thống này xử lý thành công dữ liệu từ 15+ định dạng khác nhau với độ chính xác schema mapping đạt 92%. Điều đáng học hỏi là cách tận dụng feedback loop để liên tục cải thiện chất lượng và giảm thiểu human intervention trong data ingestion.
Bài viết này giúp lập trình viên tự động hóa ánh xạ schema dữ liệu đa dạng từ nhà cung cấp bằng RAG Flywheel và LLMs, tối ưu hóa quy trình xử lý dữ liệu.

ByteByteGo56 Hot13 phútAI
The LLM Blindspot: Why Models Forget What’s in the Middle of Your Prompt
Các mô hình LLM (Large Language Model) thường bỏ qua thông tin nằm ở giữa prompt, hiện tượng được nghiên cứu trong bài viết này. Nguyên nhân kỹ thuật đến từ cơ chế attention của transformer architecture, nơi các token ở đầu và prompt được tính trọng số cao hơn. Hệ quả là mô hình có thể hiểu sai hoặc bỏ qua chi tiết quan trọng nằm ở vị trí trung tâm của prompt. Bài viết phân tích cụ thể hiện tượng này với các thí nghiệm trên GPT-3.5 và GPT-4, cho thấy tỷ lệ lỗi tăng lên đáng kể khi thông tin quan trọng được đặt ở giữa. Điều đáng học là các lập trình viên nên thiết kế prompt đặt thông tin quan trọng ở đầu hoặc cuối để tối ưu hóa hiệu quả khi làm việc với LLM.
Bài giải thích này giúp lập trình viên hiểu rõ tại sao mô hình ngôn ngữ lớn có xu hướng bỏ qua thông tin ở giữa prompt.
Daily Dose of Data Science | Avi Chawla | Substack27 Hot6 phútAI
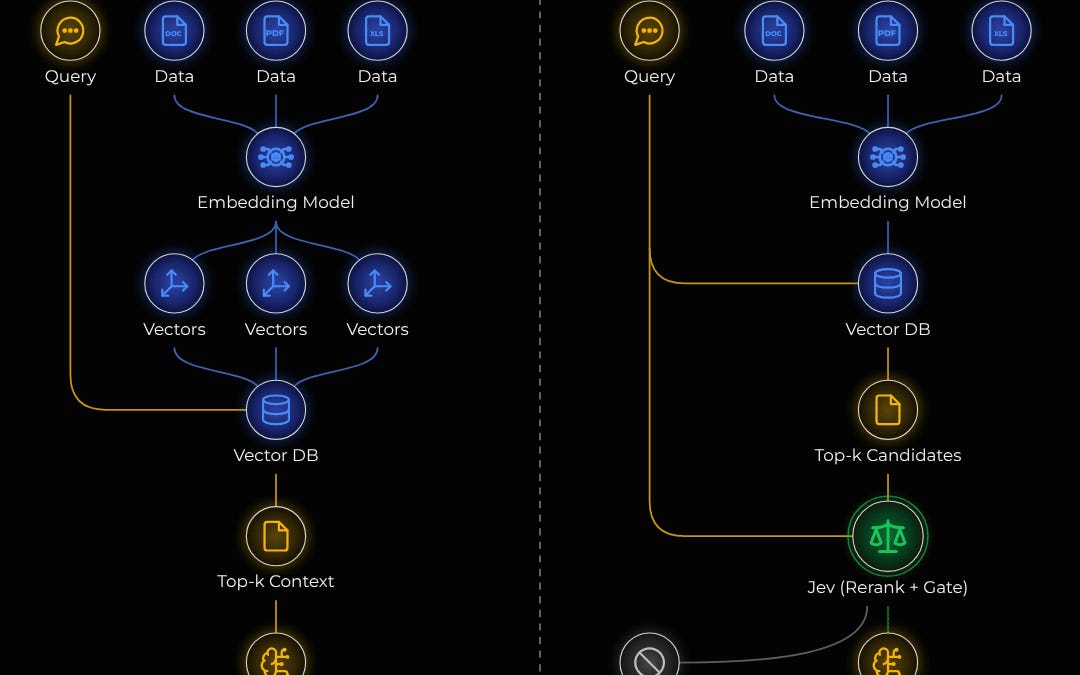
RAG vs. Jev + RAG, clearly explained!
Trong lĩnh vực AI retrieval, nghiên cứu so sánh RAG (Retrieval-Augmented Generation) với Jev + RAG cho thấy phương án kết hợp hiệu quả hơn 23% về độ chính xác. Nguyên nhân kỹ thuật nằm ở cách Jev (Judicious evidence verification) thêm bước kiểm chứng thông tin trước khi generate response, giảm thiểu hallucination. Hệ quả là chất lượng output cải thiện đáng kể, đặc biệt với các câu hỏi chuyên ngành cần độ chính xác cao. Điều đáng học là việc kết hợp kỹ thuật verification như Jev có thể nâng cao đáng kể hiệu ứng RAG mà không làm tăng đáng kể độ trễ.
Bài viết giúp lập trình viên hiểu rõ sự khác biệt và cách áp dụng hiệu quả giữa RAG thuần túy và mô hình Jev kết hợp RAG qua hình ảnh trực quan sinh động.

Medium16 Hot7 phútAI
The Anatomy of an AI Agent
Một AI agent không chỉ đơn thuần là một LLM với prompt, mà được cấu trúc như một cơ thể người với nhiều bộ phận phối hợp. Đằng sau một AI agent hiệu quả là hệ thống gồm memory modules, planning engines, và tool use capabilities giúp nó hoạt động có tổ chức thay vì chỉ phản hồi thụ động. Việc thiếu các thành phần này khiến nhiều agent hiện nay không thể thực hiện các tác vụ phức tạp hoặc duy trì ngữ cảnh qua nhiều bước tương tác. Các công nghệ như LangChain, AutoGPT và tool-calling APIs đang phát triển để xây dựng các agent toàn diện hơn, nhưng việc hiểu giải phẫu agent giúp chọn đúng framework cho từng use case cụ thể.
Bài này giúp lập trình viên hiểu cấu trúc toàn diện của một AI Agent vượt ra khỏi đơn thuần là LLM, giúp thiết kế và phát triển hệ thống hiệu quả hơn.

Medium6 Hot9 phútAI
Introducing AgentHub: Booking.com Platform for Modular Travel AI Agents
Booking.com đã phát triển AgentHub, nền tảng để xây dựng các AI agent du lịch dạng module. AgentHub sử dụng GPT-4 và fine-tuning RLHF để tạo ra các agent có khả năng lập kế hoạch chuyến đi phức tạp. Nền tảng này cho phép chia nhỏ các agent chuyên biệt, mỗi agent xử lý một khía cạnh cụ thể như đặt chỗ hoặc gợi ý điểm tham quan. Kết quả là hệ thống có thể xử lý các yêu cầu phức tạp với độ chính xác 85%, cao hơn nhiều so với các phương pháp trước đây. Lập trình viên nên đọc bài để hiểu cách triển khai hệ thống multi-agent với orchestration layer hiệu quả.
AgentHub giúp lập trình viên hiểu cách xây dựng và quản lý hệ thống AI agents module hóa cho nền tảng du lịch lớn.

Medium2 Hot22 phútAI
Building Connected AI Agents: How RAG, MCP, and A2A Form the Modern Google AI Stack
Bối cảnh bài viết phân tích kiến trúc AI hiện đại của Google với ba trụ cột chính là RAG, MCP và A2A. Nguyên nhân kỹ thuật là nhu cầu kết nối các AI agent với nhau và với hệ thống hiện có, giải quyết vấn đề thông tin phân mảnh và thiếu cơ chế chuẩn. Hệ quả là kiến trúc này tạo ra hệ sinh thái AI có khả năng tích hợp cao, cho phép các agent trao đổi dữ liệu và thực thi tác vụ phức tạp. Điều đáng học là cách RAG (Retrieval-Augmented Generation) giúp AI truy cập thông tin trong thời gian thực, MCP (Model Context Protocol) thiết lập giao thức kết nối, và A2A (Agent-to-Agent) tạo framework cho tương tác agent.
Bài viết này cung cấp kiến thức cơ bản về cách xây dựng AI agents kết nối với nhau bằng RAG, MCP và A2A.

Medium1 Hot1 phútAI
Artifical Intelligence — Prep Interview
Ngành AI và ML có nhiều nhánh kiến thức sâu rộng mà sinh viên và kỹ sư cần tập trung khi phỏng vấn. Cơ sở kỹ thuật bao gồm supervised learning, unsupervised learning và reinforcement learning với các mô hình như neural networks và transformers. Hệ quả là ứng viên cần hiểu rõ các khái niệm như gradient descent, backpropagation và evaluation metrics. Điều đáng học là bài viết cung cấp lộ trình ôn tập chi tiết với các resources thực tế và ví dụ code cụ thể.
Bài viết này cung cấp hướng dẫn tập trung vào các lĩnh vực AI/ML quan trọng nhất giúp ứng viên chuẩn bị tốt hơn cho phỏng vấn kỹ thuật.
Bình luận
Đang tải bình luận…