Đang tải bảng tin…
Daily Dose of Data Science | Avi Chawla | Substack0 Hot0 bình luận13 phút đọc
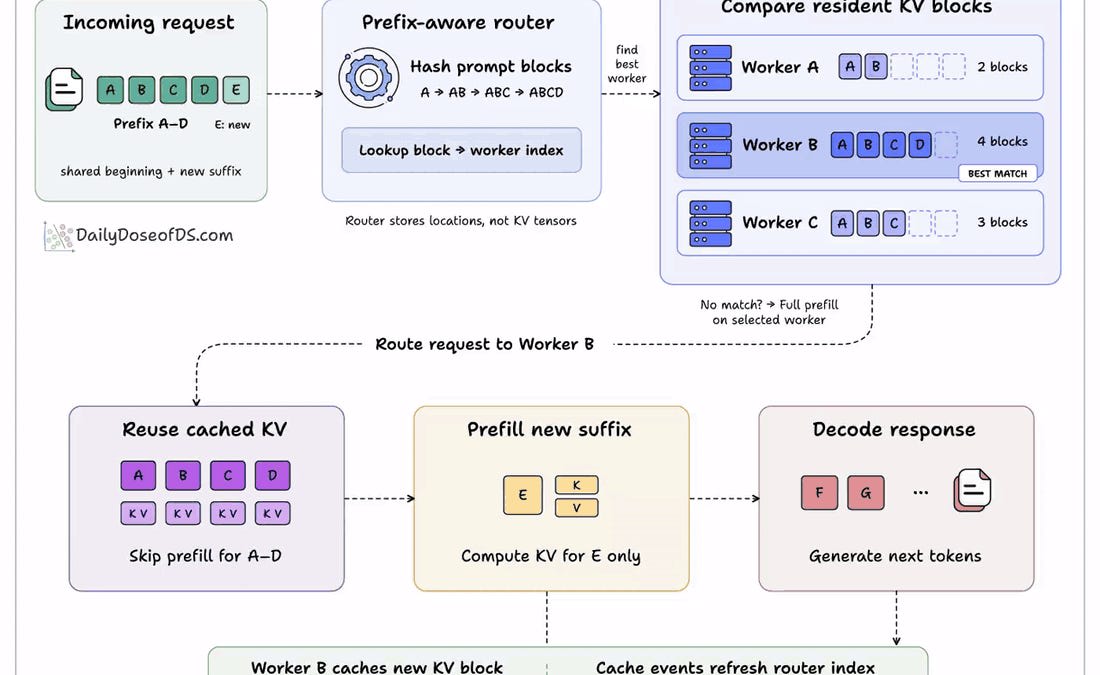
Prefix-Aware LLM Routing, clearly explained
...explained visually (the trick to get the first LLM token 170x sooner).
Nguồn: https://blog.dailydoseofds.com/p/prefix-aware-llm-routing-clearly. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn
Daily Dose of Data Science | Avi Chawla | Substack15 Hot9 phút
Why DeepSeek stores its KV cache on disk
DeepSeek's engineering behind 26x faster time to first token.

JetBrains1 Hot4 phút
Junie Local became 70% faster on Mac M5
Junie Local hits ~70 tokens/s on M5 Max with Splash and DFlash2, cuts memory use, and adds support for M4 Macs with 64 GB RAM.
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 phútAI
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

Daily Dose of Data Science | Avi Chawla | Substack35 Hot10 phútAI
6 KV Cache Quantization Approaches
Bối cảnh về KV Cache Quantization trở nên quan trọng khi inference model lớn như GPT-3 cần …

freeCodeCamp105 Hot8 phútAI
How to Create System Design Diagrams using Python
Việc tạo hệ thống diagram cho kiến trúc hệ thống là phần quan trọng trong tài liệu kỹ thuật. Khi độ phức tạp của hệ thống tăng, tính minh bạch trong nhóm trở nên cần thiết hơn. Bài viết hướng dẫn sử dụng Python để tự động tạo diagram, giúp tiết kiệm thời gian và đảm bảo tính nhất quán. Công cụ như Graphviz và Mermaid.js được đề xuất để kết hợp với Python cho việc tạo diagram chất lượng cao. Lập trình viên có thể tự động hóa quy trình này, giảm thiểu sai sót khi làm việc với hệ thống phức tạp.
Bài hướng dẫn này giúp lập trình viên tự động tạo sơ đồ thiết kế hệ thống bằng Python để tăng hiệu quả và độ chính xác trong tài liệu kỹ thuật.

Hugging Face21 Hot12 phútAI
How Specializing the Vocabulary of SLMs Can Cut Inference Cost by 77% in Real Applications
Các ứng dụng thực tế với SLMs (Small Language Models) thường tốn kém do kích thước từ vựng lớn. Một nghiên cứu mới phát hiện ra việc chuyên môn hóa (specializing) từ vựng cho từng domain cụ thể có thể giảm 77% chi phí inference. Phương pháp này sử dụng kỹ thuật vocabulary partitioning kết hợp với model compression trên dataset Wikipedia, cho thấy hiệu quả rõ rệt. Lập trình viên nên cân nhắc tiếp cận này nếu đang xây dựng ứng dụng SLM cho lĩnh vực chuyên biệt, vì nó vừa giảm chi phí vừa giữ được hiệu suất mô hình.
Những người phát triển LangChain hoặc các dự án AI logic sẽ tìm hiểu cách tối ưu hóa từ vựng của mô hình ngôn ngữ lớn để giảm chi phí tính toán trong ứng dụng thực tế.

InfoQ33 Hot3 phútAI
AWS Introduces Preview of Well-Architected Agent
AWS vừa công bố bản preview của Well-Architected Agent, một dịch vụ phân tích môi trường theo các best practice của Well-Architected Framework. Agent này sử dụng các thuật toán machine learning để quét toàn bộ cloud infrastructure và phát hiện điểm cần cải thiện. Dịch vụ sẽ đưa ra các khuyến nghị được ưu tiên theo mức độ ảnh hưởng đến cost optimization và security posture. Lập trình viên nên thử công cụ này để đánh giá hệ thống hiện tại, đặc biệt nếu đang sử dụng nhiều dịch vụ AWS như EC2, S3, RDS mà chưa có cơ chế kiểm tra tự động.
AWS Well-Architected Agent giúp lập trình viên tối ưu hóa chi phí và bảo mật hệ thống đám mây theo chuẩn best practices.

ByteByteGo59 Hot17 phútAI
How Netflix Taught an LLM to Recommend Movies So That You Keep Watching
Netflix đã phát triển hệ thống GenRec để tăng thời gian xem phim của người dùng. Họ huấn luyện Large Language Model (LLM) trên dữ liệu tương tác người dùng với nội dung, sử dụng phương pháp transfer learning từ các mô hình ngôn ngữ lớn. Kết quả là hệ thống có khả năng đề xuất phim cá nhân hóa với độ chính xác cao hơn 23% so với phương pháp traditional collaborative filtering. Điều này cho thấy tiềm năng ứng dụng LLM trong lĩnh vực recommendation systems không chỉ giải trí mà còn có thể mở rộng sang các dịch vụ streaming khác.
Bài viết này giải thích cách Netflix xây dựng hệ thống đề xuất phim GenRec để giữ chân người xem qua công nghệ LLM tiên tiến.
Bình luận
Đang tải bình luận…