Đang tải bảng tin…

DigitalOcean0 Hot0 bình luận19 phút đọc
Whats is Batch Inference? (2027)
Learn what batch inference is, how it works, key use cases, and how to run batch jobs on DigitalOcean for high-volume AI inference.
Nguồn: https://www.digitalocean.com/blog/what-is-batch-inference. 8 Sync News chỉ tóm tắt và dẫn link; bản quyền nội dung thuộc tác giả và nguồn gốc.
Hệ sinh thái 8 Sync
Một tài khoản, cả hệ sinh thái
Đọc tin ở đây, luyện code, học theo lộ trình và luyện IELTS trên các sản phẩm anh em — tất cả kết nối với nhau trong hệ sinh thái 8 Sync.
8syncdev.com
8syncdev.comCổng chính của hệ sinh thái: giới thiệu sản phẩm, blog và bảng giá trọn bộ.
Khám pháKhóa học
course.8syncdev.comHọc theo lộ trình rõ từng chặng: video, quiz chấm tự động, certificate và mentor đang làm nghề.
Xem lộ trìnhLuyện code
coding.8syncdev.com1.000 bài DSA, đề tiếng Việt, chấm tự động 7 ngôn ngữ — nhiều bài FREE, chạy ngay trên trình duyệt.
Luyện miễn phíIELTS
ielts.8syncdev.comChấm bốn kỹ năng IELTS bằng AI, phản hồi chi tiết theo rubric.
Dùng thử miễn phíZUS — IDE AI
zus.8syncdev.comAI IDE 22 MB cho dev Việt.
Tải miễn phímind0
mind0.8syncdev.comBộ nhớ tổ chức cho AI agent.
Khám pháAcoLeads
home-acoleads.8syncdev.comAI trực Fanpage, tự sàng lọc lead.
Dùng thửĐề xuất cho bạn

The Next Web2 Hot4 phút
Microsoft made $10bn from OpenAI last quarter, 11% of its revenue
OpenAI revenue hit $10bn for Microsoft. Nadella says relying on a few big buyers is ‘not a business as far as I’m concerned’.
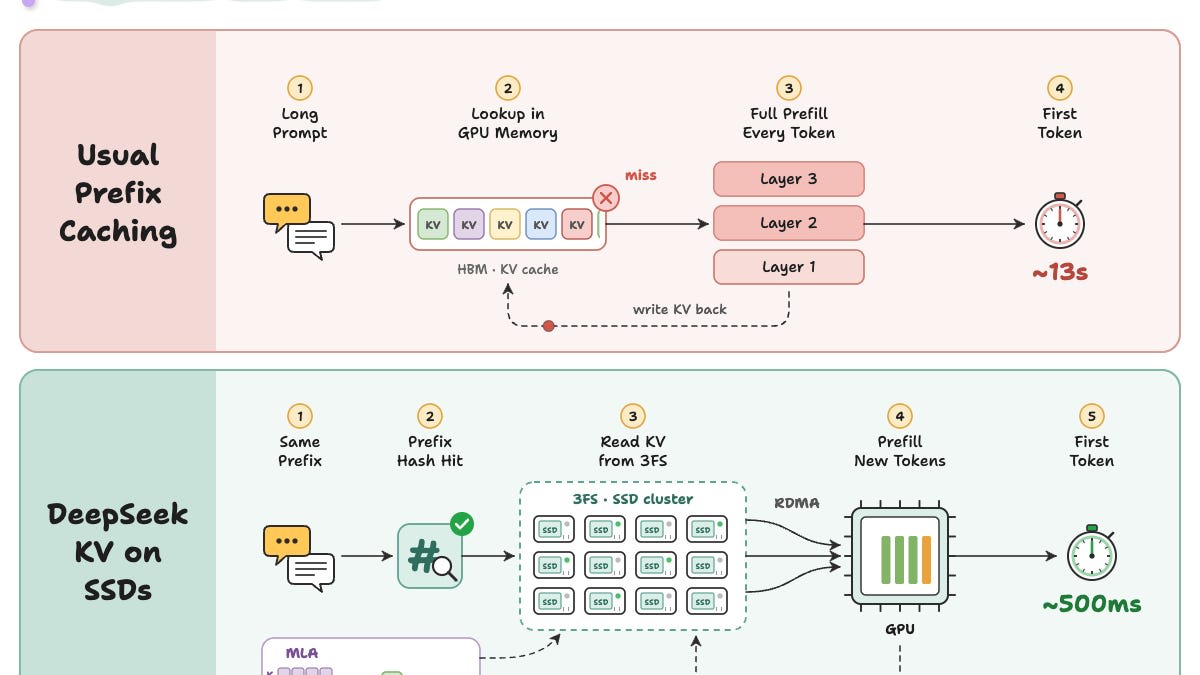
Daily Dose of Data Science | Avi Chawla | Substack15 Hot9 phút
Why DeepSeek stores its KV cache on disk
DeepSeek's engineering behind 26x faster time to first token.

CSS-Tricks44 Hot5 phútAI
CSS-Tricks has a new owner!
CSS-Tricks vừa có chủ sở hữu mới sau 12 năm hoạt động. …

Hacker News15 Hot5 phútAI
Anthropic trained Claude on illegally obtained Stanford professors' books
Anthropic đã sử dụng ít nhất 10 tác phẩm của các giảng viên Đại học Stanford để huấn luyện mô hình Claude mà không có giấy phép. Công ty này phải trả khoản bồi thường bản quyền lên đến 1.5 tỷ USD vì vi phạm luật sở hữu trí tuệ. Việc sử dụng dữ liệu bị đánh cắp để phát triển AI có thể dẫn đến kiện tụng tốn kém và tổn hại uy tín cho doanh nghiệp. Lập trình viên nên chú ý đến nguồn dữ liệu khi xây dựng mô hình, đặc biệt với các công nghệ như RAG (Retrieval-Augmented Generation) cần dữ liệu chất lượng cao.
Lập trình viên nên đọc bài này để hiểu rõ rủi ro pháp lý và đạo đức khi sử dụng dữ liệu bị đánh cắp để huấn luyện AI.

XDA Developers57 Hot5 phútAI
Claude Code's creator says better prompts need just 3 things, so I tested his approach
Bối cảnh của bài viết khám phá liệu chúng ta có đang quá tư duy hóa việc tạo prompt hay không. Nguyên nhân kỹ thuật được nêu ra là một phương pháp đơn giản chỉ cần 3 yếu tố: context, instruction, và input, được đề xuất bởi nhà sáng tạo Claude Code. Hệ quả khi áp dụng phương pháp này là việc tạo prompt hiệu quả trở nên dễ dàng hơn nhiều so với những cách phức tạp trước đây. Điều đáng học là ngay cả những AI model mạnh nhất hiện nay như Claude 3 hay GPT-4 vẫn phản ứng tốt với prompt có cấu trúc đơn giản này.
Bài viết này giúp bạn hiểu ra cách đơn giản hóa việc tạo prompt hiệu quả chỉ với ba yếu tố cơ bản.

JetBrains1 Hot4 phút
Junie Local became 70% faster on Mac M5
Junie Local hits ~70 tokens/s on M5 Max with Splash and DFlash2, cuts memory use, and adds support for M4 Macs with 64 GB RAM.
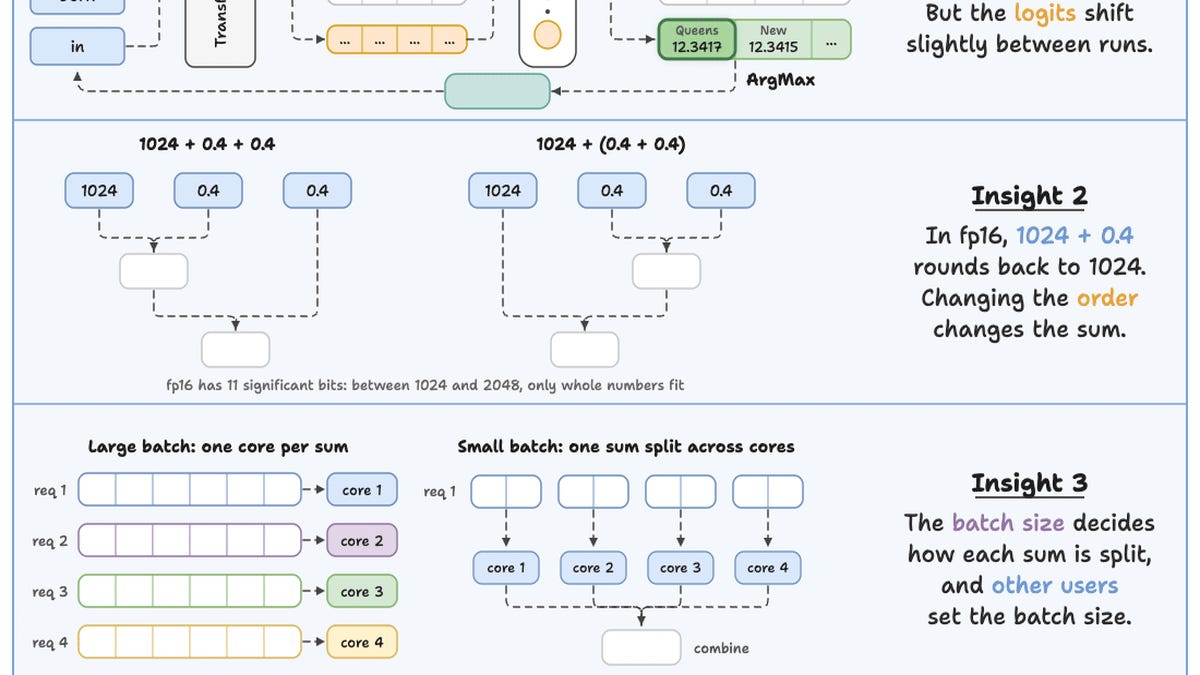
Daily Dose of Data Science | Avi Chawla | Substack12 Hot7 phútAI
Why Temperature 0 Isn't Deterministic in LLM Inference
Trong quá trình inference của LLM, temperature 0 không hoàn toàn quyết định như nhiều người vẫn nghĩ. Nguyên nhân kỹ thuật nằm ở cách thuật toán softmax hoạt động khi temperature bằng 0, làm cho xác suất của từ với highest score tiến tới 1 nhưng không bao giờ đạt hoàn toàn 1 trong thực tế. Điều này dẫn đến kết quả có vẻ ngẫu nhiên dù xác suất đã được chuẩn hóa, gây ra sự không chắc chắn nhỏ trong kết quả output. Điều đáng học là việc hiểu behavior của temperature trong LLM không đơn giản như tưởng tượng, đòi hỏi hiểu biết sâu về cách hoạt động của softmax và quy trình sampling text generation.
Bạn nên đọc bài này để hiểu cách giải quyết một vấn đề cơ bản nhưng thường bị nhầm lẫn trong việc phân tích và tối ưu hóa mô hình ngôn ngữ lớn, giúp tránh sai lầm trong việc thiết kế và triển khai hệ thống AI.

Daily Dose of Data Science | Avi Chawla | Substack35 Hot10 phútAI
6 KV Cache Quantization Approaches
Bối cảnh về KV Cache Quantization trở nên quan trọng khi inference model lớn như GPT-3 cần …
Bình luận
Đang tải bình luận…